昨天9月23号,我在南京老门东的巷口躲秋雨。风裹着雨往领子里钻,鞋尖湿了一大片,随便拐进一家半地下的咖啡店,老板正蹲在地上整理一筐刚到的生豆。装豆子的编织袋磨破了,各种产地的豆子混在一块,撒了半地。
老板抬头递了张干纸巾,说能不能搭把手,按产地分出来。我蹲下来挑,挑了十分钟,错了快一半,突然反应过来——这不就是所有人天天挂在嘴边的深度学习吗?
它从来不是实验室里遥不可及的怪物
很多人一听到这五个字,第一反应就是满机房闪着灯的服务器,动辄千亿的参数,一堆看不懂的偏微分公式,是只有大厂科学家才能碰的东西。
其实哪有那么玄乎。
本质上就是让机器像人一样,从一堆已经标好答案的例子里,自己摸出判断规律。就像今天挑豆子,老板先给你拿出两盘分好的成品,告诉你云南豆偏扁圆,纹路偏浅,巴西豆偏饱满,油脂感强,你看多了对错,下次再拿到混豆子,自然就能分出个八九不离十。
这个从例子里摸规律的过程,换个专业名字,就是深度学习。
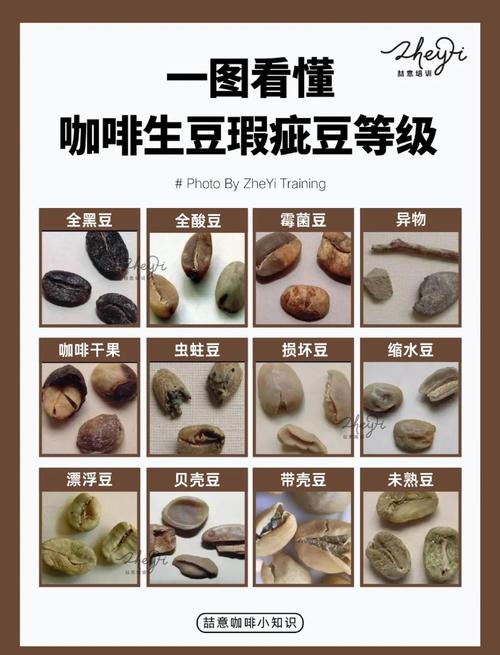
人挑错了,老板给你指出来哪颗放错了,你下次就记住那个纹路那个颜色不对,下次就改。机器挑错了,就调整自己内部的判断标准,调个百八十万次,准确率自然就上去了。
就这么简单。
戳破几个被吹烂的常见误区
说实话,这两年这概念被吹得太离谱,好多谬论传得跟真的一样。
第一个谬论,说深度学习现在无所不能,什么问题都能解决。真的吗?上个月我去参观南京一个古籍修复工作室,他们想让深度学习认明版古籍上模糊的刻字,好多字已经被虫蛀得缺笔少画,别说机器了,从业三十年的老修复师都要翻着工具书猜半天,它怎么可能搞定?
规律都是从样本里来的,训练的时候没见过这种极端情况,它就摸不出对的规律。巧妇也难为无米之炊,对吧?
第二个谬论,说深度学习已经拥有了人类的智慧,能思考会推理。别扯了。它就是个会摸规律的“哑巴”,能给你输出结果,说不出为什么会得出这个结果。说白了就是个黑箱,你把输入塞进去,它把结果吐出来,中间它到底是怎么判断的,至今没人能说的百分之百清楚。
就像你挑豆子挑多了,一闻就知道哪个是耶加雪菲,你说不清楚为什么你一闻就知道,就是感觉对,它也一样。
之前就有这么个经典的例子,给猫咪的照片贴一小块黄色贴纸,深度学习直接把猫认成了鳄鱼。它根本不懂什么是猫什么是鳄鱼,它只是按训练出来的规律匹配像素特征而已,稍微改一点它没见过的细节,就直接乱认。
别把它神化,它就是个工具。
现在的深度学习,正在往“小”里走
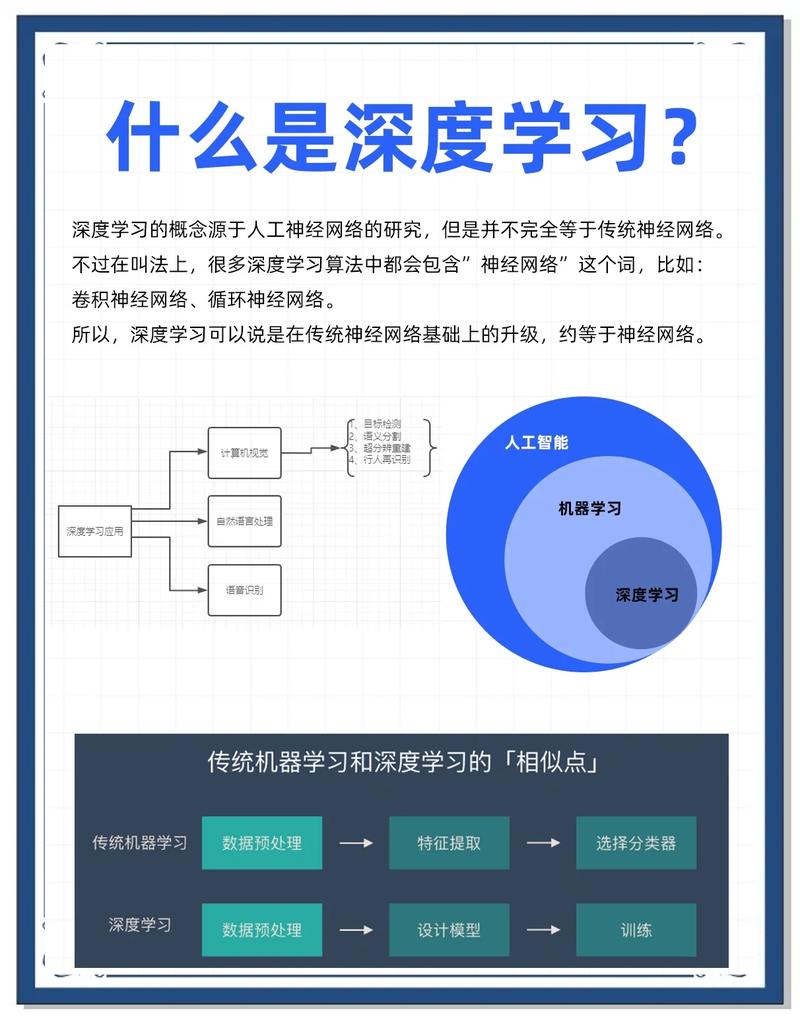
前两年圈里的风气就是堆参数,比谁的模型大,仿佛参数不够千亿都不好意思出来打招呼,仿佛越大越厉害。
不过话说回来,百分之九十九的落地场景,根本用不上那么大的模型。就像你挑一筐十公斤的豆子,雇一个兼职就够了,犯不着把全南京市的厨师都叫来撑场面。
现在越来越多做落地的人,都转向了轻量深度学习模型,不需要什么超级算力,几十万几百万参数就够,就能跑在手机里,跑在工厂的检测设备里,跑在巷口咖啡店的点单机里,不需要连云端,速度快成本低,隐私性还更好。
当然不是说大模型没用,大模型适合做复杂的通用任务,写稿画图聊天都能用,但是细分的小任务,真的犯不着杀鸡用牛刀。我认识一个南京做纺织检测的小伙子,他们就训练了一个不到一百万参数的小模型,专门认布料上的跳线和色差,准确率比传统的图像识别方法高了快两成,整套设备的成本只有原来的十分之一,已经在好几家工厂用起来了。
这才是把技术用对了地方。不像好多蹭热点的创业者,张嘴闭嘴就是千亿参数大模型,落地的时候连个零件表面的小划痕都认不准,纯纯是拿概念圈钱。
那天我帮老板挑完豆子,老板送了我一杯手冲耶加雪菲,雨也停了,我坐在窗边看巷子里来往的游客,桂花香味飘进来,突然就想通了。所有的技术,到最后都要落到具体的小事上。深度学习也一样,不是用来放在PPT里吹牛逼的,就是帮你分一分豆子,找一找布料的划痕,认一认模糊的字迹,帮人省点时间省点力而已。
褪去所有的概念包装,它本质就是帮人干活的好手。如此而已。
作者|科技
排版|科技
审核|安然