 大讲堂

你以为的“分布式”,根本不是真分布式训练
刚入行的工程师对分布式训练的理解往往特别简单:把一个塞不进单卡的大模型,拆成几块分别丢到不同的GPU上,最后把结果拼起来就完事。 错得离谱。 核心矛盾从来不是“能不能把模型装下”,是“怎么让几千张卡像一张卡一样转,不互相拖后腿”。现在行业里通用的三种并行模式——数据并行、张量并行、流水线并行——本质上都是在找“模型拆分粒度”和“跨卡通信开销”的最优平衡点。拆得太粗,单卡塞不下;拆得太碎,卡之间传梯度的时间比算梯度的时间还长,最后GPU趴在那里空等,钱全打了水漂。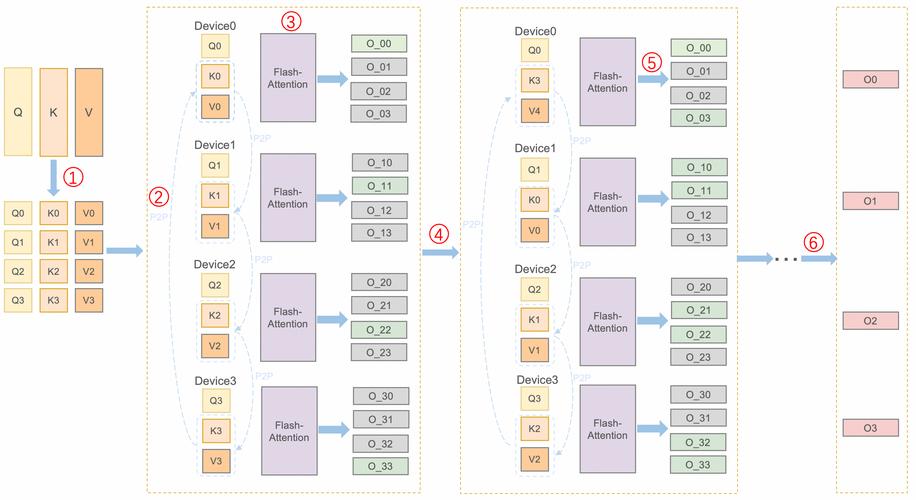
现在的分布式训练圈,已经卷到“看不见的地方”了
很多人以为现在的AI竞争是“谁家买的卡多谁赢”,真进了行业才知道,头部厂商的GPU利用率能做到60%-70%,中小团队连30%都摸不到。同样是1000张A100,头部团队跑一次训练的时间,是中小团队的2倍多,算下来单任务的成本差了整整一倍。 这中间的差距,根本不是靠砸钱买硬件能补上的。 现在行业里最抢手的工程师,不是会调模型参数的算法岗,是有过千卡甚至万卡集群调优经验的运维工程师。这种人在市场上的年薪开到百万级都抢不到——毕竟人家知道怎么把集合通信的延迟压到最低,知道流水线并行的气泡率怎么降到10%以下,知道哪个参数改一下能让GPU利用率涨5个百分点。这些经验没有公开的教材,全是过去几年跑坏了几十台服务器、熬了几百个大夜熬出来的。
藏在算力账单里的治理风险,没人愿意公开提
现在谈分布式训练,大家都在说技术进步、成本下降,很少有人提藏在背后的风险。 首先是资源错配的问题。这两年各地都在拉算力中心项目,给了极低的电价和土地补贴,很多项目打着“万卡集群”的旗号拿地,实际上集群的利用率连30%都不到,跑的还是没什么落地价值的玩具模型。算下来,公共资源换回来的只是几个没有商业闭环的创业团队,账根本算不平。 然后是安全漏洞的问题。分布式训练的节点越多,被攻击的面就越大。你把模型的参数、梯度拆到几千个节点上,只要其中某一个节点被人篡改了传输的梯度值,整个训练出来的模型就可能被植入后门——比如训练个内容审核模型,后门一开,特定的违规内容就能被放过去;训练个金融风控模型,特定资质的客户就能被误判为优质用户。这种风险现在没有统一的检测标准,全靠各个团队自己补窟窿。 还有个更隐蔽的生态锁定问题。现在各家的分布式训练框架都是在开源版本上深度定制的,跨平台迁移的成本极高。你在A云厂商的集群上调优了半年的训练流程,搬到B云厂商的集群上,可能要花两三个月重新适配,这就导致很多中小团队根本换不了供应商,议价权为零,被锁死在生态里挨宰。 聊到这肯定有人问,那接下来分布式训练会往哪走? 说几个我观察到的趋势,没有什么宏大叙事,全是一线跑出来的实感。 第一,未来3年,分布式训练的优化重点会从“怎么把模型装下”,转到“怎么把通信成本压到最低”。现在大家在搞的集合通信算法优化、存算一体架构,本质上都是要把跨节点传梯度的无效开销消掉。等到那个时候,GPU利用率能冲到90%以上,同样规模的集群,能跑的模型参数能翻3倍,训练成本还会再下一个台阶。 第二,未来3-5年,会出现一批专门做分布式训练调优的第三方服务商。就像当年给企业做ERP实施的公司一样,不管你用哪家的卡、哪家的框架,人家上门给你把集群调到最优,最后按节省的算力成本分成。这生意现在已经有人在做了,只是还没走到台前,毕竟大部分厂商还把调优能力当核心壁垒捂着。 第三,别觉得分布式训练是大厂的专属游戏。随着框架的轻量化优化,原来要几千张卡才能跑的千亿参数模型,可能几百张卡就能搞定,甚至边缘侧的分布式训练都会落地——比如几个制造工厂的本地服务器凑成一个小集群,不用把生产数据传到公有云,就能训练适配自身工艺的工业大模型,既解决了数据泄露的问题,又省了大笔的云服务费用。 上周那个吃烧烤的算力负责人说,现在大家都在卷参数、卷公开榜单,没人愿意盯着GPU利用率那点小数点后的数字抠。但就是这0.1的利用率差距,算下来一年就是几百万的成本。 说白了,所有的技术泡沫最后破的时候,留下来的全是这些没人愿意说透的硬账。作者|大讲堂
排版|大讲堂
审核|见微