 大讲堂

2026年招投标现场的意外报价
烟味飘得满屋子都是。
2026年3月我在苏州工业园某汽车结构件厂的智能质检项目开标现场,亲眼看见做了八年传统云视觉的王老板把标书往桌上一摔。他报的128万总价,比同场另一家厂商的报价低了整整51万,可采购方连他的技术参数页都没翻到第三行。
那家高报价的厂商,标书上明明白白写着核心方案是联邦学习。

我凑过去翻了翻那份179万的报价单,里面列的费用项很细:本地节点硬件28万,加密模块授权15万,三年运维费42万,剩下的是模型迭代的人力成本。算下来,光运维费这一项,就相当于这个结构件厂过去3年给质检系统交的所有云服务费总和。
王老板当场就骂,说这是把客户当冤大头。可散场之后,采购部的张主管拉着我在走廊抽烟,说他也想选便宜的。去年就是因为把三个车间的质检缺陷图传到王老板的公有云平台做模型训练,被下游的新势力车企开了800万的罚单——理由是未经过授权就传输涉及生产工艺的敏感数据,这笔钱相当于他们厂2025年全年净利润的12%。
说实话,我跑了十年制造业的招投标现场,头一次见有人因为怕罚款,愿意给同一套功能的技术多掏40%的溢价。之前大家选云视觉,图的就是算力便宜,模型迭代快,可现在合规的刀架在脖子上,谁还敢把自己车间的缺陷样本往外传?那些缺陷图里藏着的,是注塑的温度参数、冲压的压力曲线,是小厂压箱底的吃饭本事,也是品牌方怕被竞品抄走的核心工艺。
成本账本里的真实博弈
不过话说回来,那些发布会吹”联邦学习是数据可用不可见的革命”的话术,我是半分都不信的。
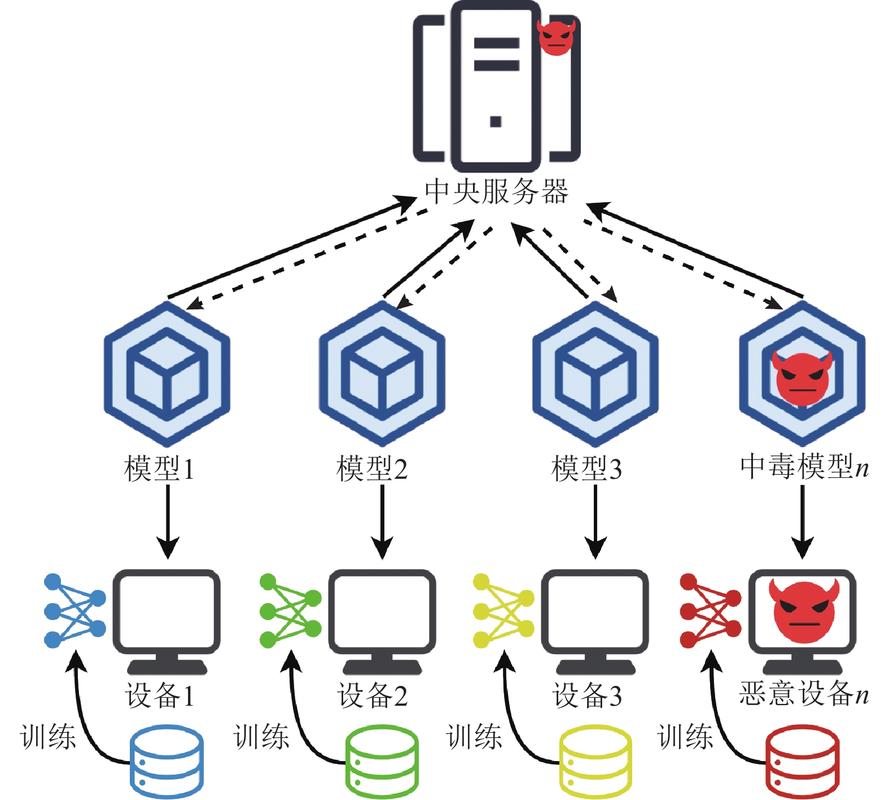
我去年跟着深圳某工业AI公司的项目组跑了三个月美的的供应链质检项目,算过一笔实账:很多人以为联邦学习不用传原始数据,能省带宽,实际上联邦学习的每一轮模型训练,要传的加密梯度数据量,比原始缺陷图片只小30%左右,但每一次加密解密的算力消耗,是普通集中式训练的2.7倍。根本不是什么降本的技术,是拿算力换数据合规的成本。
这个模式说穿了就像农村育种:之前大家搞集中式训练,相当于把所有村子的种子都拉到农科院的实验田里选优,种子交出去了,人家种出更好的品种,跟你也没关系;现在搞联邦学习,每个村子在自己的田里种,只把选出来的最优单株的花粉送到农科院配种,既不用把自己家的核心种源交出去,又能拿到改良后的杂交品种。美的当时推这套方案,就是因为给他们供空调注塑件的17家小厂,之前死活不愿意把缺陷图传到美的的云里——有个做改性塑料的小老板说,那些缺陷样本里藏着他调试了五年的配方,交出去等于把老婆孩子都送给别人了。
算过账就知道谁在买单。美的作为品牌方,承担了所有数据合规的罚款风险,所以大头的技术投入是他们出的。之前集中式训练的时候,每个小厂一年要交12万的云上传带宽费,还要掏2万的人工成本做数据脱敏;换成联邦学习之后,美的出钱给每个小厂装了3.8万的本地节点,每年只收1.2万的运维费,相当于小厂三个月的带宽成本,还不用怕数据泄露。
谁在扩产?上海那家做可信执行环境芯片的厂商我熟,2025年的订单直接翻了3倍——所有联邦学习的节点都要装这个芯片,防止本地的原始数据被偷,之前他们的芯片主要卖给金融机构,现在一半的订单都是制造业的。谁在库存里挣扎?就是开标现场摔标书的王老板这类,之前囤了快2亿的公有云服务器,现在客户都要求数据不出厂,他的服务器搁在机房里落灰,连折旧都快算不过来了。
当然也有糟心的地方。我去年去东莞的一家小注塑厂,老板看着装在墙角的那个联邦学习盒子,说这玩意儿比他的200吨注塑机还娇贵。每个月要请人来调两次参数,不然就掉线,连加密证书过期了都不知道找谁换。很多小厂连个专职IT都没有,对吧?你让他维护这套加密系统?纯纯的为难人。
被改写的产业链位置
现在江浙沪的制造业招投标文件里,已经有60%的工业AI项目加了”数据不出厂”的硬性要求。那些之前吹自己公有云攒了多少亿训练数据的厂商,现在连标书的门槛都进不去。
之前做AI训练师的那群人,原来坐在杭州的写字楼里标数据,一个月拿6000块工资。现在呢?要跑遍江浙沪的工厂,在每个本地节点上校准模型,要懂注塑工艺,要懂冲压参数,还要能看懂加密日志,工资直接涨了30%,还得常年背着个笔记本住厂附近的招待所。
算过现在的成本账:联邦学习的整体落地成本,比2023年刚推的时候降了62%,但还是比传统集中式云视觉贵40%左右。相当于每帮工厂提升1个百分点的质检良率,就要多花大概20万的技术成本。现在敢掏这个钱的,都是被合规罚过的,或者是给头部新能源、新势力供货的厂——小厂没这个预算,宁愿靠老师傅肉眼看质检,也不愿意掏这笔钱。
标准的博弈才刚开始。现在信标委在推统一的工业联邦学习接口标准,可美的、海尔、宁德时代这些大厂,都在搞自己的私有标准。宁德时代的供应链联邦学习项目,连美的的技术团队想对接都进不去,因为接口不兼容。等于小厂花了钱装的节点,只能给一个品牌方用,不能同时给其他客户做质检模型——本来是打破数据孤岛的技术,现在反而成了每个大厂圈自己供应链数据的围墙。
之前大家说联邦学习能打破互联网平台的数据垄断,结果跑了三年现场才发现,平台没被打破,反而每个制造业的大厂,都给自己的供应商修了一圈高高的数据墙。再过两年,当所有工厂的墙角都摆上了那个娇贵的小盒子,大家突然发现这些盒子根本连不成一张网,每个墙里面的模型,只给墙的主人干活。
那到底是数据的解放,还是换了个地方的圈地?
作者|大讲堂
排版|大讲堂
审核|阿辰