2026-10-05 02:43:03
作者:
科技
上周六约朋友逛南京老门东,走到巷口拐脚的咖啡店歇脚,抬头就看到吧台贴着一张软乎乎的中秋海报,暖黄色调,桂树影晃在咖啡杯上,字也写得软乎乎的。
我夸老板会找设计,老板笑着擦杯子,说哪找什么设计,自己用AI弄的,十五分钟不到。
哦?我凑过去看。她点开工具,传了一张昨天刚拍的店门口桂花树的照片,输入一行字:“做一张中秋促销海报,用这棵树的感觉,加字‘桂花香里吃月饼,第二杯半价’,色调暖一点。”
点生成,不到一分钟,三张图出来了,挑挑就能用。
这就是现在说的多模态大模型啊。
别翻百科了,我们从这事儿说开
以前你用AI画图,是不是只能输文字?你要把你想要的感觉,你手里有的素材,全掰成文字说清楚,说不清楚就出歪货。现在呢?你把你现成的图扔给它,把你想说的话告诉它,它能一起读懂。
说白了,以前的AI是残疾人,有的只会认字不会看画,有的只会看画不会听话,现在的多模态大模型,是个感官正常的普通人,眼睛能看,耳朵能听,嘴巴能说能写还能画,各种信息攒一块儿理解。
多模态大模型的核心,是打通了不同类型信息的墙。
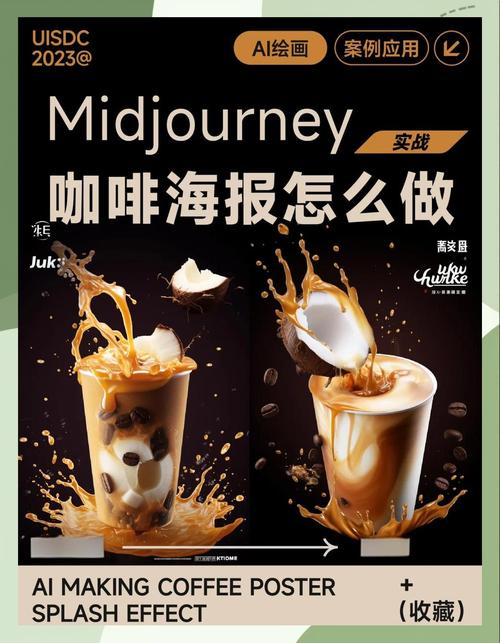 咖啡店多模态AI生成海报操作界面
有没有试过跟AI发语音,同时发一张你拍的菜谱照片,让它帮你算出这道菜一共多少卡路里?
搁五年前,这得三个不同的AI一起干活:一个转语音,一个识别图里的文字,一个算卡路里,中间哪步错了全错。现在一个多模态大模型就搞定了,对吧?
我见过最多的两个误区
第一个误区:很多人觉得,多模态就是把文字大模型、图像模型拼一块儿,套个壳就拿出来卖。
不对。早期的半成品确实是这么干的,把不同模型的输出拼一下,本质还是各干各的,你传一张图,先让图像模型把图转成文字描述,再把描述给文字大模型,中间转一道,信息就丢了好多,还容易错。
真正的多模态大模型,从训练的时候就混着喂不同模态的数据——文字、图片、音频混在一块儿,让模型自己学,看到桂花的样子,就对应上文字里“香”“软”“秋天”这些词的感觉,不是硬拼的,是真的学会了不同信息之间的关联。
第二个误区:很多人觉得,多模态大模型就是能生成图片的AI。
这完全是被营销带歪了。能生成图只是其中一个能力而已,它的能耐更多在“理解”这边。
比如你开远程会,多模态模型能一边听懂所有人的发言,一边看懂你共享屏幕里的PPT、表格、截图,结束直接给你出一份带重点标注,把表格数据整理好的会议纪要,这活儿单模态AI干不了,只有多模态能做。
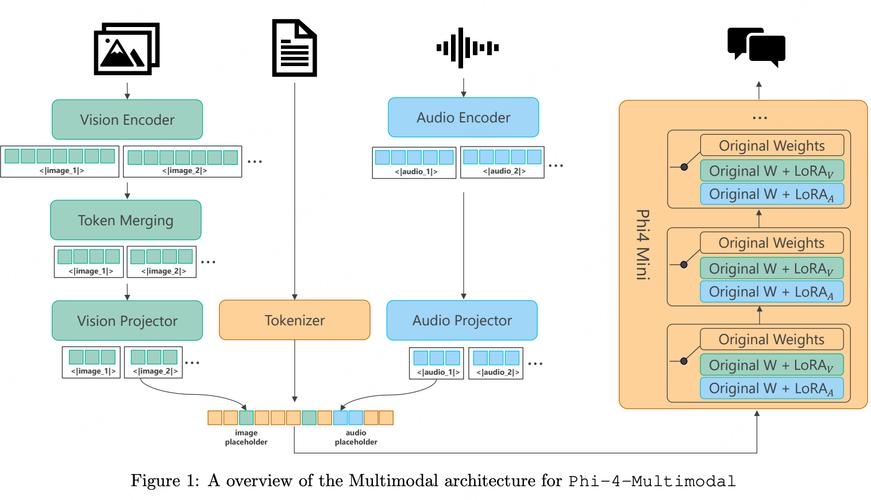 多模态大模型统一训练架构示意图
我之前帮朋友整理资料,试过把一整份带图带表的PDF扔给多模态模型,让它把里面提到的所有案例整理出来,不到两分钟搞定,放以前,OCR识别完文字,图里的表格内容还得自己重新敲,太磨人了。
好用,但真没吹得那么神
 好用,但真没吹得那么神
说实话,这次在咖啡店亲眼看到老板用,我还是挺惊讶的,毕竟前两年多模态还在实验室发论文,现在摆摊开店的普通人都能用了。
进步真的快。
但你说它是不是完美了?远着呢。
有没有碰到过这种情况:你拍一张你家猫的照片,输入“给我画一张我家猫站在桂花树下的图”,结果出来一只长桂花的猫?
这就是现在多模态的老毛病,不同模态的信息混在一起,它经常串味,把不相关的特征拼一块儿,逻辑错得离谱。
还有,你给它一张拍歪了的手写菜单,让它帮你统计一下哪个菜卖得最多,它大概率能把数字认错,把字看错,因为模糊的信息跨模态对应起来,难度比咱们想象的大太多了。
不过话说回来,哪有新工具刚出来就完美的?
咱们普通人不用管什么架构不架构,只要它能帮咖啡店老板省几百块设计费,能帮咱们整理资料省几个小时加班,能帮医生更快看完CT片,这就是好东西啊。
对吧?
那天我在咖啡店买了一杯桂花拿铁,就着海报的桂香喝,觉得技术这事儿真有意思,从来不是实验室里冷冰冰的论文,是落到巷口咖啡店的一杯咖啡里,落到普通人的日常里,慢慢改变日子的。
免责声明:市场有风险,选择需谨慎!此文仅供参考,不作买卖依据。如有侵权请联系删除。
文章名称:巷口咖啡店的AI画师,正在揭开多模态大模型的真实面纱
文章链接:https://www.lfdjt.com/p/keji/a/6562.html