别翻百科了,换个角度说知识图谱
要是把互联网上所有信息比作散在地上的一万块拼图,传统的搜索是啥?你输入关键词,它帮你把所有带这个关键词的拼图块捡出来堆你面前,对不对?找不找得到你要的,全靠你自己拼。
知识图谱不一样,它提前就把所有拼图块按连接处拼好了。你要找哪一块,它直接把和这块连在一起的一整组都递到你手上,不用你自己翻。
举个最常见的例子,你现在搜「周杰伦」,打开搜索引擎第一页,侧边直接就出来他的出生日期、妻子、代表作、最近开演唱会的城市,不用你点进网页一个个找。这些信息不是搜索引擎碰巧抓来的,是知识图谱早就把「周杰伦」和这些信息的关系理清楚了,直接调用就行。
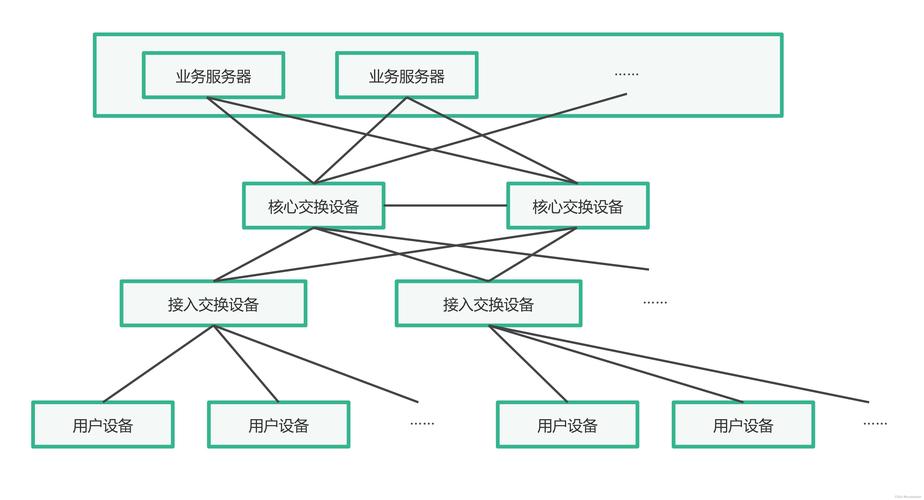
很多人以为这是最近十年才出来的新东西,其实早在上世纪七十年代,就有人提出类似的思路了。那时候想做一个能整理人类所有知识关系的网络,可惜算力不够,存储也不够,存不下这么大一张网,只能停在论文里。
直到互联网爆发,移动互联网出来,算力成本降了,大家才发现,哦,原来这东西真能用了。
日常你摸得到的知识图谱,都在干哪些活
除了搜索结果侧边栏那点信息,知识图谱其实早就渗进你每天用的所有产品里了。
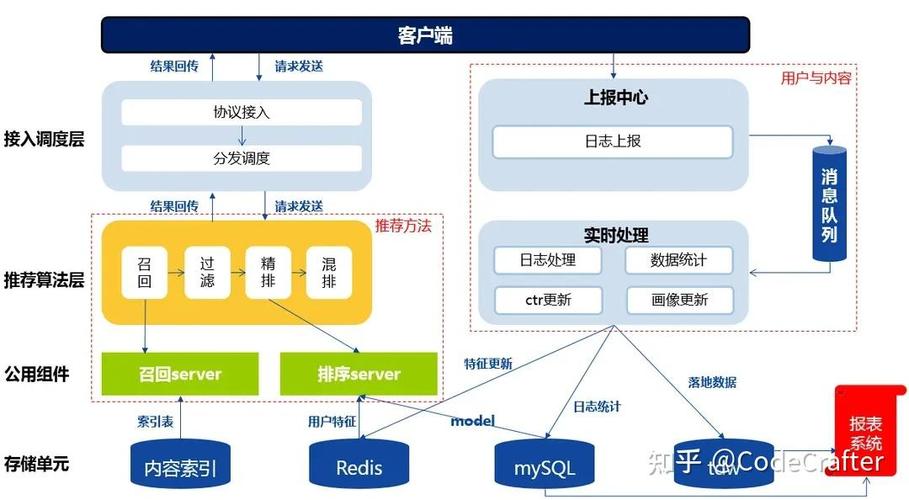
就说推荐。你既喜欢看布偶猫拆家的视频,又喜欢搜南京本地的鸭血粉丝汤探店,两个完全不搭的爱好,推荐算法怎么精准给你找内容?
放在以前,可能只给你推猫,或者只推美食,碰运气。现在知识图谱会给你打两个标签,再把有同样两个标签的用户拉出来,把这些用户喜欢的内容都推给你,准确率高了不止一点。
再说说金融反欺诈。你去申请贷款,填了自己的工作地址,填了老板名字,知识图谱一拉,就能发现这个地址同时还关联了五家你没提过的公司,那个老板还是三家失信企业的法人。不用人工去一条条查工商信息,几毫秒就出结果,直接就把风险标出来了。
还有你天天用的智能客服。你发一句「我的快递什么时候到」,不用你报订单号,它就能通过知识图谱,把你的账号、你最近三天的下单记录、对应快递的物流节点一下子串起来,直接给你说位置,省了多少来回拉扯的功夫。
知识图谱真正值钱的,不是它存了多少知识,是它存了知识之间的关系。这是它和普通数据库最不一样的地方。
比如说,知识图谱里存了「猫-属于-哺乳动物」,又存了「哺乳动物-属于-脊椎动物」,就算从来没有人直接说过「猫是脊椎动物」这句话,它也能顺着关系自己推出来,直接回答你的问题。
现在大模型老是胡编乱造,大家第一个想到的优化方向,就是把大模型和知识图谱结合,用知识图谱把事实关系卡死,大大降低胡说八道的概率。这个方向现在已经有不少落地的产品了。
吹得越多,坑越多,知识图谱没那么神
说实话,现在行业里吹知识图谱吹得太厉害了,什么全领域通用知识图谱,什么能替代人类知识库,听着挺玄乎,其实好多坑都没说。
第一个坑,更新成本太高了。人类每天都在产生新的知识,新的关系,今天某明星官宣离婚,明天某公司出了新品,后天某个领域出了新的研究成果,知识图谱得天天更,牵一发而动全身,改一个关系可能要动一整片,光是维护成本就够很多中小公司喝一壶的。
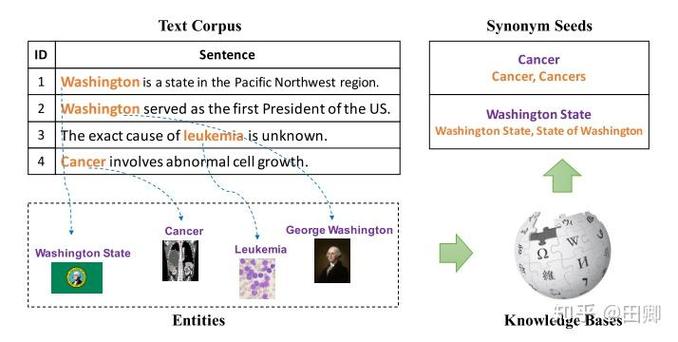
第二个坑,关系挖不对。现在很多关系是AI自动从文本里挖的,不是人手工标的,很容易错。比如说你挖「南京」相关的实体,AI会把「南京长江大桥」和「南京大桥饭店」直接挖成「南京-大桥-饭店」,错把大桥当成饭店的前缀,这种错误多到你改不完,用到核心业务里就是大问题。
我去年跟一个做企业服务的朋友吃饭,他说他们帮一家制造企业做内部知识图谱,就是把老师傅的工艺经验整理成网,方便新人查。结果同一个零件,三个老师傅三个叫法,光统一名称梳理关系,整个项目组耗了两个多月,差点逾期赔违约金。
坑归坑,方向确实是对的。不过话说回来,知识图谱不管发展到什么时候,都替代不了人找新的关系,对吧?它只是把已经有的知识整理好,相当于你家那个帮你把所有衣服按季节、场合整理好挂在衣柜里的管家,你要出门直接拿,省得你自己翻箱倒柜。但你要买新衣服,要搭配新穿法,还是得你自己来。
下次你再刷手机,突然惊叹怎么这个APP这么懂你,不妨停下来想一想。那张藏在后台看不见的知识网,早已经把你的喜好,把千万人的行为,把世界上零散的知识,悄悄连在了一起。
作者|科技
排版|科技
审核|小准