9月23号南京那场技术沙龙,我挤在后排凑到调试台边,胳膊肘都被旁边的人碰掉半杯冰美式。
本来看着工程师跑本地部署的开源模型,输入的prompt是’写一段颐和路梧桐落叶的秋日短文案’,结果他手滑把temperature参数从0.7拉到0.1,出来的内容干得像课本里的说明文,连’踩在落叶上沙沙响’这种最基础的氛围感都没提。旁边的实习生小声吐槽:’这模型怎么突然变傻了?’
我当时盯着屏幕突然反应过来——我们好像从一开始,就把大模型算法想成了能独立思考的’电子聪明人’,但真相根本不是这样。
你以为的“聪明”,其实是概率的凑数游戏
很多人第一次用大模型,看到它能顺着自己的话接下去,甚至能精准get到自己没说出口的潜台词,第一反应是’这玩意真的懂我’。
别信。
你输进去的每一个字,进到模型的参数层里,都会被拆成一个个它训练时见过的最小单元——可能是半个汉字,可能是一个常用词,甚至是一个标点符号。它要做的事,和你高中做英语完形填空没有任何区别:给你前面已经出现的所有内容,算出来下一个位置放哪个单元的概率最高,就把哪个单元放上去。
没有理解。没有共情。纯纯的概率计算。
刚才提到的那个被拉低的temperature参数,说穿了就是个’随机度旋钮’。拧得越低,模型越敢选概率最高的那个答案,出来的内容就越死板,像照着标准答案背课文;拧得越高,它越敢选那些概率稍低但更有新鲜感的内容,有时候能蹦出来让你眼前一亮的句子,有时候也能瞎扯到离谱——比如把写梧桐落叶的文案,直接串到隔壁巷子的烤鸭店促销上。
我上周在家部署小尺寸的开源模型玩,把这个旋钮拧到1.2,本来想让它帮我写一段给朋友的生日祝福,结果它给我拼出来半段科幻小说,说’祝你在银河里捡到属于你的小行星’,虽然离谱,但我盯着屏幕笑了快十分钟。
被吹上天的“推理能力”,其实是攒出来的记忆碎片
之前有朋友给我发截图,说他用大模型解出了一道考研难度的线性代数题,字里行间都在震惊’这玩意真的有逻辑思维’。
真不是。
你以为它是在一步步推导公式、梳理逻辑链条?其实是它训练的时候,见过几百万份数学题的解答过程、教材上的定理证明、甚至网上学生发的解题笔记,所有这些内容都被压成了几十亿个参数,藏在模型的各个层里。你给它一道题,它不是在’思考’,是在快速匹配:哦,这种题型我之前见过,上次见的时候,后面接的是’先求导再代入数值’,那我就把这句话拼出来。
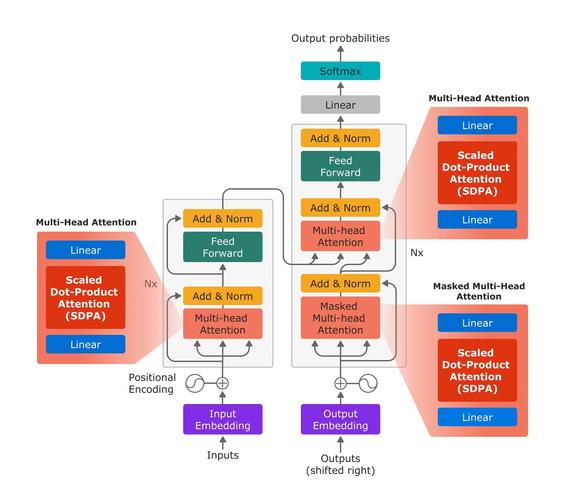
它所谓的’注意力机制’,说白了就是在拼句子的时候,知道哪些词和前面的内容关联度更高,不会东一榔头西一棒子扯太远。
上次我特意编了一道从来没在网上出现过的初中几何题,把三角形的边长换成了特别偏的小数,连辅助线的位置都改得和常见题型不一样,拿去问它。结果它前面扯了一堆三角形全等的定理,绕了三圈,最后连个正确的辅助线位置都给不出来。我当时对着屏幕愣了两秒——合着之前吹得神乎其神的’逻辑推理’,全是背下来的现成答案啊。
别被神话骗了,算法本身根本没有那么玄乎
现在一提到大模型算法,很多人就觉得这是啥不可复制的黑科技,是只有顶级实验室才能做出来的东西。
说出来可能会打破很多人的滤镜:现在所有主流大模型用的核心结构,2017年就被几个谷歌的工程师写在论文里了,到现在快7年,根本不是什么刚冒出来的新技术。真正拉开效果差距的,从来不是算法本身有多颠覆性的创新,是你喂给它的训练数据够不够干净、够不够多元,还有调参数的人,是不是真的知道每个参数到底在影响什么。
我之前接触过两个做开源模型的团队,用的是一模一样的核心算法结构。一个团队为了凑训练数据,扒了一堆网上的盗版小说、无营养的网络段子,出来的模型连个正经的工作总结都写不利索,动不动就蹦出来’家人们谁懂啊’的网络梗;另一个团队花了半年时间整理合规的公开出版物、学术文献、行业报告,出来的模型写专业分析的时候,连引用的文献出处都能找对。
算法是完全一样的。差的是喂进去的东西。
说实话,现在很多厂商吹自己的算法有多牛,你扒开底层代码看,全是基于公开的开源结构改的,最多就是在注意力计算的环节优化了几个小细节,根本没有什么天翻地覆的创新。你要是真信了他们的营销话术,花大价钱去买所谓的’专属定制算法服务’,最后大概率会发现,出来的效果还不如你自己花两个小时整理下prompt、调两个参数好用。
有人问过我,既然大模型算法本质是概率拼接,那它以后真的能完全取代人的工作吗?
我一般会给他们举个最生活化的例子。你刷短视频的时候,平台的算法给你推的内容,是不是刚好是你愿意停下来看的?它从来不知道你为什么喜欢这类内容,只是算出来你看到这类内容的时候,停留的时间更长、点赞的概率更高。大模型的算法,和这个逻辑本质上没有区别。
它能帮你凑出来一段看起来很顺的文字,能帮你总结几十页文档的核心要点,甚至能帮你写代码的初稿。但它永远不知道,你写这段文字,是为了给去世的爷爷写悼词,还是为了给甲方交一份能顺利过审的方案。
它没有立场。
没有情绪。
你给它什么语境,它就给你拼什么概率最高的内容。
9月23号沙龙快结束的时候,那个做开源模型的工程师说,现在整个行业都走偏了,总觉得参数量越大的模型越厉害,其实真正的好算法,是能让小尺寸的模型也能解决实际的问题,而不是天天比谁的数字堆得大。我当时特别同意这句话——毕竟你用个需要好几张高端显卡才能跑的超大模型,去帮你写个朋友圈文案,和你用个手机就能跑的小模型写的,普通人根本分不出来区别。
我散场的时候沿着颐和路走,风卷着梧桐叶蹭过路边的围墙,突然就觉得,我们其实没必要把大模型算法当成什么无所不能的神。它就是个被人做出来的工具,和你手里的计算器、你用的搜索引擎没有本质区别。
你会用,它就能帮你省点力气。
你不会用,就算给你堆上万亿参数的模型,它也只会给你拼出来一堆毫无灵魂的、概率最高的废话。
作者|科技
排版|科技
审核|柚子