 大讲堂

去年接了个创业团队的项目,要把70B的开源模型部署到线上做智能客服。
之前的方案是用HuggingFace原生推理库,单卡A100撑死跑3个并发,用户一多就卡成PPT,等待时长超过10秒,投诉量翻了三倍。
换vLLM之后?
同一张卡,跑27个并发。
我当时盯着监控面板愣了半分钟。
真的,那种冲击力就像你开了十年的油车,突然换了辆纯电,发现之前一半的油耗全是白烧的。
不是魔法,是把GPU显存里的“无效浪费”全抠出来
很多人第一次用vLLM的时候,总觉得是有什么黑科技,其实拆开看,核心就一个东西:PagedAttention。
之前的推理框架是怎么管理显存的?说穿了特别笨。就像你办演唱会,给每个进场的观众提前锁一整排座位,不管人家是站在门口打个招呼就走,还是要看完两个小时的演出,空着的座位也不许别人坐。最后算下来,真正用来存模型权重、存推理过程中的KV缓存的显存,连40%都不到,剩下60%全是被各种预留的、碎片化的空块占着,看着显存总量够,实际能用的没多少。
vLLM的思路完全换了。它把GPU显存切成固定大小的小块,就像操作系统里的虚拟内存分页机制,哪个块空了,就实时分给下一个需要显存的请求,完全不用提前预留整块空间。这么一改,显存碎片率直接从60%以上压到4%以内,单卡能承载的并发请求量直接翻了七八倍。

当然,别把它吹成万能的。
我自己踩过坑。
比如跑1B参数以下的小模型,vLLM的性能优势根本出不来,甚至比专门针对边缘场景优化的推理框架还慢30%。再比如对某些非主流量化格式的支持现在还不全,老架构的V100显卡上跑4bit AWQ量化的模型,有时候速度还不如原生的FP16。它不是解决所有推理问题的银弹,只是把通用场景下的推理效率拉到了目前能摸到的天花板。
现在整个开源AI圈,已经绕不开vLLM了
说个很直观的事。
现在Llama 3、Qwen2、Mistral这些主流开源大模型的官方部署文档,第一推荐的生产级推理框架就是vLLM,不是别的。
去年某公有云厂商把大模型推理实例的默认引擎从自研框架切到vLLM之后,单实例的推理吞吐量涨了2.3倍,对应的单token成本直接降了62%——这个数他们在季度财报里专门提过,毕竟降本带来的利润率提升,比多卖几个GPU实例还实在。
生态的渗透速度比很多人预想的快太多。LangChain、LlamaIndex这些上层应用框架,早就把vLLM的适配做进了默认选项,现在很多做RAG的小团队,根本不用花几个星期调推理环境,点三下鼠标就能把本地下载好的开源模型用vLLM跑起来,直接对接自己的业务流程。
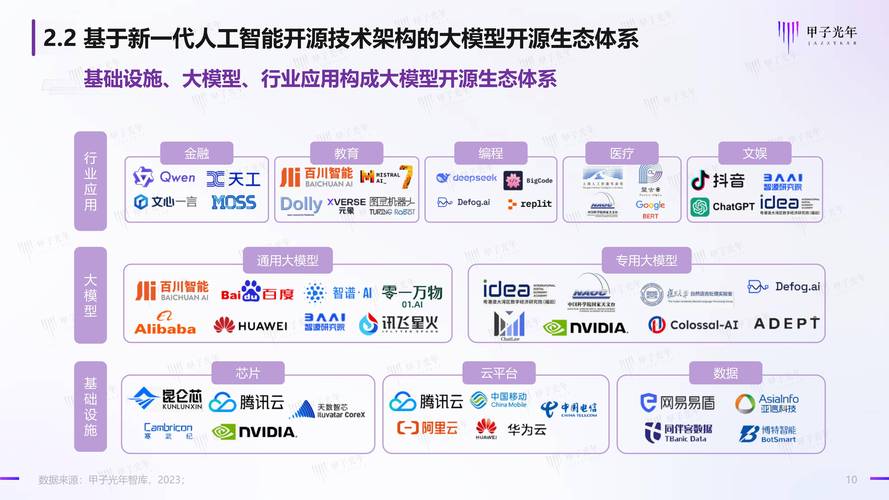
不过话说回来,这波渗透也打垮了一批本来想做通用推理框架的创业团队。之前有个朋友的团队,花了半年时间自研推理引擎,本来想跟vLLM拼性能,结果第一次跑基准测试,吞吐量连vLLM的60%都不到。现在整个团队已经转去做多模态推理的垂直优化了——毕竟通用文本推理的基本盘,已经被vLLM焊死了,硬拼根本拼不过。
它重构的不是技术参数,是整个AI落地的成本账
很多人没意识到,vLLM带来的变化,根本不是“推理速度快了点”这么简单。
之前大模型推理的成本,能占到整个AI应用总成本的70%以上。很多创业团队算完账发现,自己部署模型的成本比直接接OpenAI的API还贵两倍,根本不敢做高并发的C端产品,生怕用户量涨一点,成本就直接把现金流烧穿。
vLLM把成本打下来之后,整个账算过来完全变了。
举个真实的例子。之前有个做AI法律文书生成的小团队,最开始全靠OpenAI API,每个月光推理成本就要12万,稍微搞个活动拉新,成本就直接超预算。后来他们用vLLM部署了本地的70B开源模型,把自己积累的3000份司法文书全量塞进了上下文窗口,每个月的推理成本直接降到1.8万。最关键的是,回答的质量比之前用API的时候还好——毕竟API的上下文长度有限,塞不下完整的案件细节,经常答非所问。
这才是最核心的影响。之前很多AI应用根本不是产品不好,是算不过账,不敢做。现在成本压到原来的1/6,很多之前停留在demo阶段的产品,终于能真正上线跑了。
当然,现在的问题也不少。
首先是安全的窟窿太大。vLLM本身是个专注性能的开源推理框架,根本没有内置的用户鉴权、流量审计、敏感内容拦截的模块。我之前看到过安全团队的扫描结果,全网有超过1200个没有任何鉴权的vLLM服务,端口直接暴露在公网上,谁都能随便调用,相当于把自己花钱买的GPU算力白送给陌生人刷token。
还有个常见的坑,就是很多团队不管什么场景都硬套vLLM。比如做实时语音交互的场景,vLLM的批处理优化,是攒够一批请求一起处理来提吞吐量,但是对单个请求的延迟没有做专门优化,经常出现用户说完话等2秒才出反应,体验差到用户直接卸载。
说几个我自己的判断,不一定全对,但是基于现在的行业变化推出来的。
第一,vLLM不会成为行业里唯一的推理框架,但是它会成为整个行业的性能基准。就像现在做CPU的,出来新品第一个要跟Intel的同功耗产品比性能,以后所有新的推理框架,第一个要对标的就是vLLM的吞吐量。达不到这个基准,根本没人愿意用。
第二,现在的开源版本会一直保持基础功能免费,但是核心团队肯定会往商业化走。毕竟这么大的用户量摆在这,企业需要的权限管控、跨集群调度、多模态推理优化、故障排查工具,这些都是可以收费的企业级功能。我估计3年之内,vLLM肯定会推出正式的企业版,就像之前的MySQL、Redis一样,开源版给个人开发者用,企业版收服务费。
第三,3年之后,整个大模型推理的成本还会再降一个数量级,vLLM在里面的贡献至少能占30%。到时候很多现在算不过账的应用,比如面向K12的AI家教、社区级的AI客服、个性化的AI陪伴产品,都会因为成本足够低真正落地,而不是每年在行业大会上放demo。
作者|fawen
排版|fawen
审核|白杨