2026-10-02 02:16:15 作者:大讲堂
你有没有想过,为什么GPT出来之后,之前火了十几年的RNN、LSTM一夜之间就没人提了?
不是参数堆得不够多。是核心逻辑换了赛道。
自注意力到底解决了什么老问题?
做自然语言处理的老玩家都知道,早年处理序列数据,都是一个字一个字往前啃。RNN要读完第一个字,才能读第二个,前面的信息传个几十上百步,早就稀释得没影了。长文本分析?直接凉。
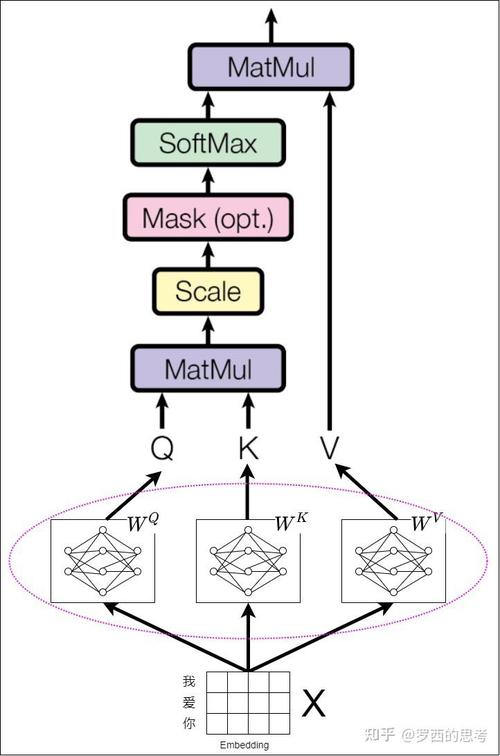
2017年Google那篇《Attention Is All You Need》扔出来,整个圈都炸了。原来不用逐字递推,给所有词两两算相似度,挑重要的留下来就行。
Transformer自注意力机制计算流程图 注意力机制的本质就是打分分配资源 。就像你逛电商首页,眼睛只会停在你想买的东西上,边缘的弹窗广告直接自动忽略,大脑不会把算力浪费在没用的信息上。AI这么做,其实就是模仿人的认知习惯。
自注意力更狠,它不光能看上下文,还能给自己序列里的每个词打分。翻译一句话,代词”它”到底指的是前面哪个名词,一眼就能对上,之前的模型哪有这本事。
说白了,没有注意力机制,就没有今天的大模型。就这么简单。
不止大模型:注意力机制已经悄悄渗透进全产业
别以为注意力机制只有大模型才能用。其实早就落地到你每天用的产品里了,只是你没察觉。
你刷抖音短视频,为什么总能刷到你想看的?推荐系统里的多注意力机制,会给你最近一小时的行为打10倍权重,三年前搜过一次的吉他,直接降到几乎可以忽略的分数。这不就是注意力?
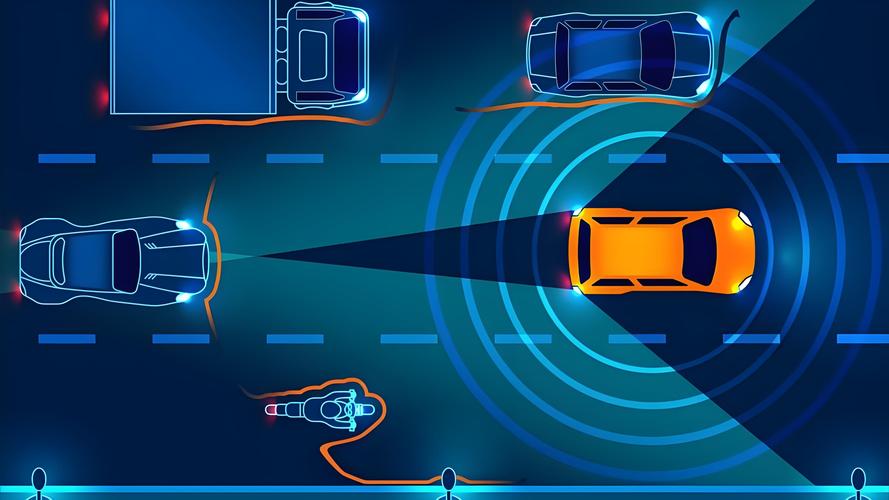
自动驾驶的视觉感知,现在主流模型全加了注意力。路那么大,摄像头拍的整帧画面里,90%都是没用的背景,蓝天、行道树、路边的广告牌,注意力机制直接把几乎所有计算资源都分配给前面的车、突然窜出来的行人、远处的红绿灯,相同算力下,小障碍物的识别准确率直接提了30%还多。
自动驾驶视觉注意力机制聚焦障碍物示意图 绕不开的瓶颈:接下来三五年要往哪破?
绕不开的瓶颈:接下来三五年要往哪破? 注意力机制的打分逻辑现在还是黑箱 。它为什么给这个特征打高分,为什么忽略那个,很多时候连训练模型的工程师都说不清楚。招人的AI筛简历,会不会因为训练数据里的偏见,自动给男性求职者的性别特征打更高分?做医疗影像分析,会不会因为训练的时候大部分病灶长在左肺,就自动忽略右肺的微小病灶?偏见会被注意力放大,这个问题现在还没找到完美的解法。
不过话说回来,技术迭代的速度比想象中快。我对未来三五年的判断很明确:
第一,高效长文本注意力一定会落地,百万字级输入的成本降到现在的十分之一以内,到时候整本书问答、整份年报分析这些场景,会直接普及,不用再切来切去拆段落。
第二,垂直领域的定制化注意力会成主流,医疗影像就专门给病灶区域加权重,工业质检就专门给产品缺陷区域加算力,不用做通用计算,成本降一半,准确率提一截。
第三,注意力机制的可解释会变成强制要求,以后大模型上线备案,不光要看输出结果,还要能解释清楚注意力的分配逻辑,把偏见的风险控住。
很多人追热点都盯着大模型的参数、ChatGPT的功能,很少有人回头看这个底层的小发明。其实从AI开始会像人一样分配自己的算力开始,才真正摸到了通用人工智能的门。路才刚走了一半而已。
免责声明:市场有风险,选择需谨慎!此文仅供参考,不作买卖依据。如有侵权请联系删除。
上一篇Transformer不是大模型红利,是算力内卷的新陷阱
下一篇恒温恒湿箱厂家怎么选?以慧泰仪器为例的选购要点
 大讲堂