 大讲堂

被误解三十年:星型模型的核心逻辑从来不是“形状”
很多人提起星型模型,第一反应就是数据仓库里的一种建模方法,不就是一个表在中心,周围一堆表连出去,长得像星星对吧? 说实话,大部分人只记住了形状,没搞懂它设计的底层逻辑。 星型模型的核心,是把数据分成两类:事实表和维度表。中心的事实表存的是可度量的业务数据,比如订单额、销量、访问次数,每条记录带各个维度的主键。外围的维度表存的是描述性信息,比如时间、区域、产品类目、用户属性。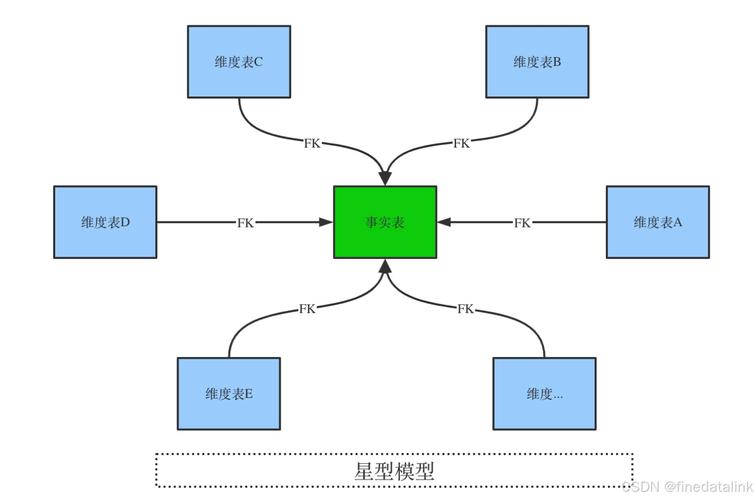
星型模型二次翻红:正好撞上了大模型RAG的核心痛点
这波AI热潮里,企业落地最成熟的路线就是RAG,也就是检索增强生成。说白了就是把企业自己的数据喂给大模型,让大模型能基于私有数据回答问题。 可做过企业级RAG的都知道,最头疼的从来不是大模型生成,是检索。 用户问一句“去年第三季度,华东区售价超过100元的美妆产品,用户好评率排前10的是哪些”,普通的纯向量检索,只能抓“美妆产品”“好评率”这些语义,抓不住“去年第三季度”“华东区”“售价超过100元”这些精确的维度条件,搜出来的结果不对,大模型生成再漂亮也是错的。 那怎么办? 现在业内跑得通的方案,说白了就是把星型模型那套搬过来了。事实表存业务主键和核心事实数据,每个维度单独做维度表,向量embedding存在维度表里,检索的时候先按用户给的维度条件做过滤,把不符合条件的数据直接筛掉,再在剩下的小数据集里做向量相似度检索。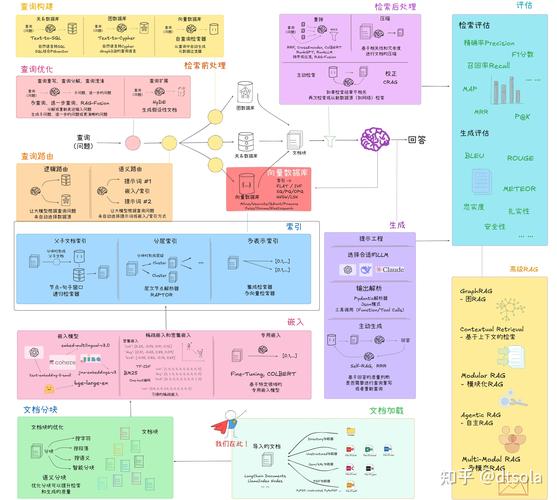
热潮下的暗坑:星型模型不是万能解药
未来三年:星型模型会成为行业标配吗
作者|大讲堂
排版|大讲堂
审核|白杨