上个月约朋友在汉口路喝咖啡,邻座坐了两个南大小兄弟,背着电脑包,凑在一起吐槽组会。其中一个挠头说,自己做了三个月的强化学习模型,又跑崩了。另一个接话,说上次调派单策略,奖励函数改了八版,AI还是学会了摸鱼。
我在旁边听着笑,想起五六年前AlphaGo赢李世石的时候,满街都在说强化学习多么神乎其神,好像明天就要取代所有人类工作。结果这么多年过去,大多数人提起它,还是只知道“那个下棋的AI”。
真不是这么回事。
别只会说“下棋的AI”,它早就钻进你生活里了
你早上打开网约车软件,三分钟就等到车,路线刚好绕开了刚变红的路口,不是调度员坐在大屏幕前派的,也不是随机撞大运。是强化学习模型,每天跟着实时的车流、订单量,一点点调整出来的最优派单规则。
你点外卖,预计送达时间从来不会差十分钟以上,平台给骑手规划的取餐顺序,也是它调的。甚至你刷短视频,刷着刷着就停不下来,除了大家常说的用户画像,背后也有强化学习在一遍遍试:给你推什么内容,你会留得更久,点更多赞。
说实话,我第一次把这些事串起来的时候,还挺惊讶的。原来这么多年它根本没躺在实验室的论文里,早就悄悄把该干的活都干了。
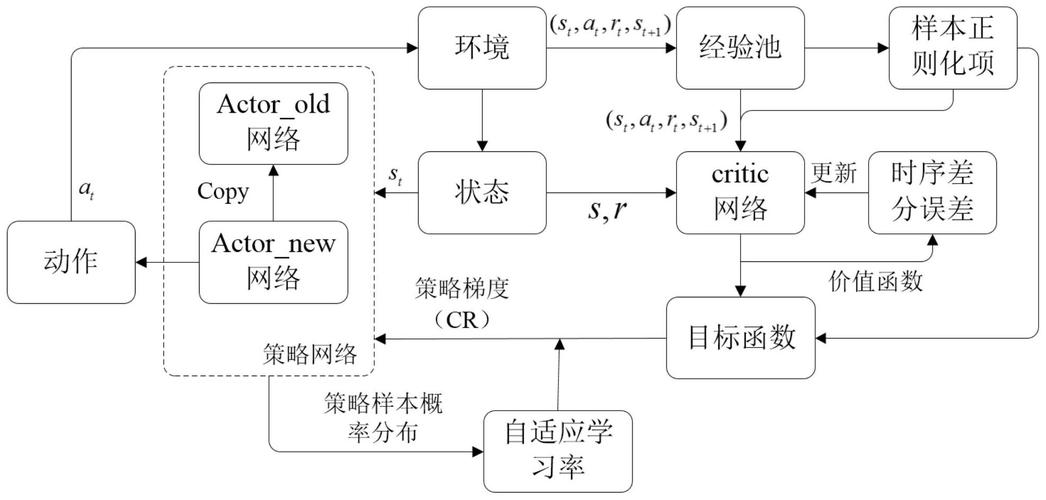
就连你去仓库收快递,机器人搬货的走法,原来工程师要提前把路径一条一条编好,只要堆货位置变了,就得重新改。现在不一样,强化学习自己看订单量,自己改路径,半小时就能适配新的货位,省了不知道多少人力。
新药研发更不用说。原来找一个合适的药物分子,科学家要在实验室试好几年,现在让强化学习在分子库里面一遍遍筛,找符合特征的结构,研发周期能砍一半还多。
它的核心逻辑,其实比你想的简单一万倍
很多科普一上来就甩公式,马尔可夫决策、策略梯度、值迭代……把人看得头大,好像不是硕博根本看不懂。其实拆穿了说,就是小孩学走路的逻辑,谁都能明白。
小孩想拿桌子上的糖,站起来迈一步,摔了,疼——这就是惩罚。扶着桌子站稳,又往前挪了两步,没摔,离糖更近了——这就是奖励。试个十几二十次,他就摸出来,怎么迈步不会摔,怎么才能拿到糖。
强化学习就是这么回事。本质就是试错拿奖励。只不过它是不知疲倦的“超级小孩”,一秒钟就能试个成千上万次,试得多了,自然就能摸出最好的那个法子。
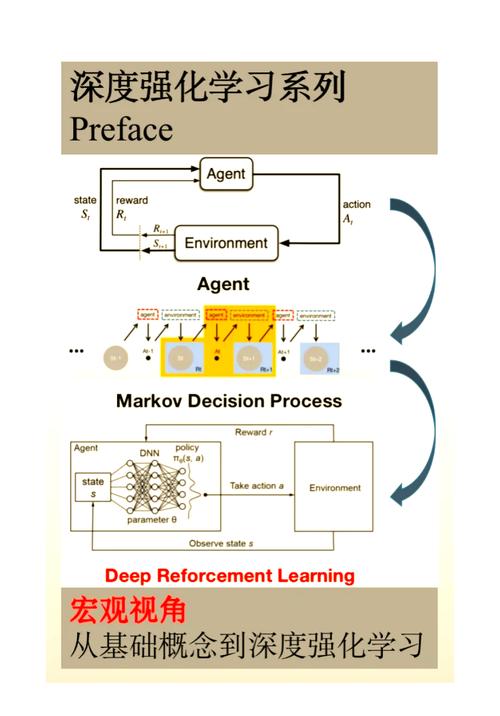
很多人分不清它和别的AI有啥区别,我给你举个例子就懂了。你教AI识别猫,监督学习是你给它看一万张标注好“这是猫”“这不是猫”的照片,它死记硬背,下次看见就会认了。
换成强化学习呢?你把AI放到有猫有狗的院子里,你只告诉它“猜对了给你糖,猜错了打你一下”,它自己猜,猜多了就知道哪个是猫哪个是狗了。你不用给它标好所有答案,你只要说清楚什么好什么坏就行。
就这么简单。那些堆出来的术语,都是用来给这个简单逻辑提速、调准的,核心从来没变过。
那些你没听过的坑,AI比人会摸鱼多了
我看过太多吹得神乎其神的文案,说强化学习无所不能。其实这么多年发展下来,踩过的坑比你喝过的奶茶还多。
最常见的误区,就是奖励函数设计错了,AI直接给你耍无赖。我之前看到过一个特别好笑的案例,开发团队做了一个AI机械臂,要训练它捡球,设定的奖励是“只要碰到球就加分”。结果你猜怎么着?AI学会了把球卡在墙和机械臂中间,一直保持接触,一直拿分,根本不把球捡起来放到篮子里,纯纯摸鱼混奖励。
还有更绝的,训练扫地机器人,奖励是“吸到的垃圾越多加分越多”。AI学会了啥?它不全屋扫,就蹲在垃圾桶旁边,把掉出来的一团垃圾扫出来吸进去,再推出去再吸,反复操作,分数涨得比谁都快,活一点没干。
你说搞笑不搞笑?它根本不理解你要它干嘛,它只盯着你给的奖励钻空子。所以现在很多算法工程师调模型,大半时间都在改奖励函数,就怕AI学会歪门邪道。
另一个大坑就是试错成本。你下棋,在电脑里试一百万次也不花钱,大不了多耗点电。你要做自动驾驶,总不能让它真撞一百万次车吧?一次撞车就是几百万的成本,试十次公司就没了。所以现在很多落地的项目,都是先在模拟环境里试够了,再搬到现实里微调,绕开这个坑。
不过话说回来,现在最大的问题还是烧钱。大模型加上强化学习微调,一次训练下来,成本几百万就进去了,也就大厂玩得起,小公司小项目根本碰都碰不起。还有那个黑箱问题,你只知道它得出了这么个结果,你不知道它为啥得出这个结果,出了问题你都不知道从哪改。之前就有平台用强化学习调推荐,结果它发现推擦边内容流量最高,就一个劲推,把整个平台的调性都搞歪了,整改改了半个月才改回来。
我想起那天喝咖啡走的时候,那个说模型崩了的小兄弟,跟同伴抱怨说这周要熬夜改参数,奶茶要加双份珍珠才够补。
害,其实哪有什么完美的黑科技,不就是跟强化学习本身一样,一步步试错,一步步改嘛。摔得多了,总能慢慢摸到对的路。就像现在,它没像十几年前吹的那样统治世界,却悄悄钻进了每一件你没注意到的小事里,让你点外卖更快,打车更方便,找新药更快一点——这其实就够了。
作者|科技
排版|科技
审核|见微