你以为的“知识宝库”,其实根本没存下任何东西
很多人对大模型的第一认知,是它把整个互联网的公开内容都存进了硬盘,需要什么内容就直接调取出来。 错。 它根本没有“记住”任何具体的知识点。 那天工程师给我演示,当我们在输入框里打出“床前明月光”五个字的时候,屏幕上没有弹出任何“检索资料库”的进度条,反而跳出了一长串密密麻麻的概率数值——系统在计算,下一个字最可能是什么。在它见过的几百万次文本训练样本里,“床前明月光”后面跟着“疑”字的概率,比跟着其他所有汉字的概率加起来还要高99.2%。
所谓的“理解能力”,本质是个会找关联的概率玩家
肯定有人会问,要是全靠猜,那它怎么能理解上下文的意思?比如你说“我把刚买的苹果放在桌上,回来的时候发现它被碰掉了”,它怎么知道这里的“它”指的是苹果,不是你家的猫? 这就要说到大模型算法里最核心的那部分设计了。 你就把它想成一个读文章的时候会自动盯着关键词的读者。读上面那句关于苹果的话时,它会自动把“碰掉”这个动作和前面最近的名词“苹果”绑定,不会傻乎乎把“碰掉”和离得更远的“买”“桌”凑成奇怪的关联。 我当时听到这个类比的时候差点把咖啡喷出来。合着这折腾了五六年的复杂算法,本质上就是个会找上下文关联的概率玩家啊!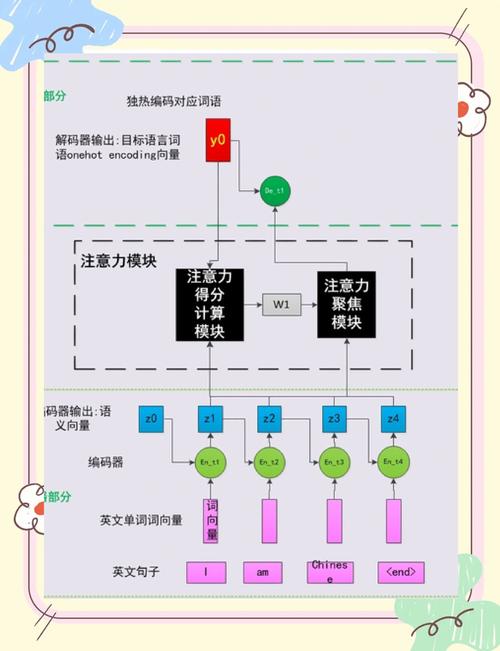
那些被吹上天的“算法魔法”,全是抠出来的笨功夫
现在网上好多关于大模型算法的渲染,总觉得这是某个天才团队灵光一闪搞出来的神级技术,普通人这辈子都摸不到门道。 真不是。 之前翻OpenAI公开的技术博客,他们为了让模型输出的内容不瞎编、不违反常识,前前后后找了上千个标注员,给模型生成的不同回答打分,告诉它“这个回答靠谱,有依据”“那个回答是瞎编的,不能说”,来来回回调整了好几个月的参数。这里面没有什么魔法,全是一点一点抠出来的细节。 好多人觉得模型的参数堆得越多就越好用,其实根本不是。之前有公开的测试结果显示,同样的算法框架下,参数少一半的模型,只要喂进去的是经过严格筛选的高质量标注数据,最后出来的实际使用效果,比参数多但训练数据杂乱的模型好不少。算法的效果从来不是靠堆参数堆出来的,你给它喂什么料,它就长什么本事。 那天临走的时候我问那个熬了两个通宵的工程师,现在外面好多人说大模型算法马上就要替代所有程序员了,你怕吗?他靠在实验室的门框上笑,说”你刚才见我改bug改了两个小时,你觉得这东西能自己改自己的bug吗?” 我从实验室出来的时候,刚好赶上晚高峰,软件大道上的车排成长龙,风里飘着路边梧桐树的味道。之前总觉得大模型算法是飘在天上的东西,离普通人的生活远得很,那天之后才反应过来,你刷短视频时收到的精准推荐,你用输入法时弹出的联想词,你点外卖时看到的适配你口味的商家,背后都有类似的算法逻辑在跑。 它不是什么遥不可及的黑科技。 就是一堆人把概率计算、上下文关联、人工标注这些零散的小事拧到了一起,搞出来的一个好用的工具而已。作者|科技
排版|科技
审核|见微