上周三加班到九点半,外卖小哥把黄焖鸡米饭塞到我手里的时候,我随手拍了张照发给异地的朋友,刚敲下“今天的汤放多了好咸”几个字,手机上的多模态助手直接弹了条提示:“这是常见的重口款黄焖鸡,汤汁占比超三成,下次备注少汤能淡不少。”
我盯着屏幕愣了两秒。以前这种事,得我自己对着照片回忆口味,或者搜半天外卖评论才能得出结论。现在它看着一张没加任何标注的外卖图,就把我没说出口的吐槽接过去了。
它不是“能发图的聊天机器人”
说实话,网上好多对多模态大模型的解释,都把它说偏了。很多人觉得,这就是原来的聊天机器人加了个发图功能——你把图片传上去,它先给图片写段文字描述,再把这段描述丢进原来的文字模型里生成回答。说穿了,还是“文字转文字”的老路子,根本没摸到多模态的核心。
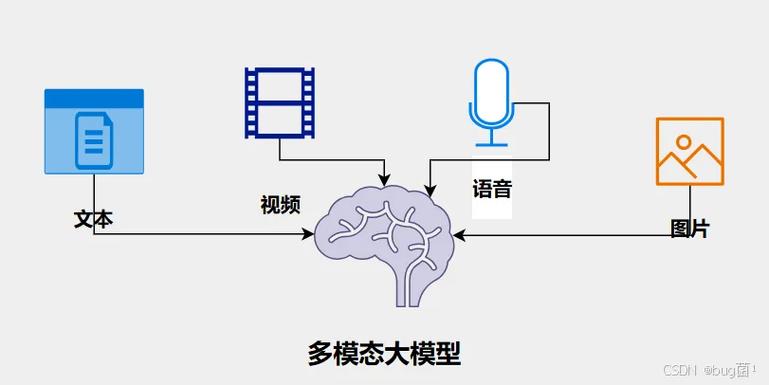
它的核心从来不是“能处理几种输入”,而是让不同类型的信息在同一个语义空间里完成打通。就像你自己看到一张图的时候,大脑不会先把画面拆成“像素块”“色彩值”,再把你说的话拆成“汉字”“语法结构”,两个模块各跑各的流程最后拼出个答案——你是瞬间就把猫的眼神、地上碎掉的手办、你话里带的那点无奈情绪捏成了一个完整的认知,多模态大模型要做的,就是模拟这个自然的认知过程,而不是把不同模态的内容硬凑到一起。
没有魔法。训练的时候,它见过亿万张带文字标注的图片、带语音解说的视频、配着画面的音频片段,慢慢学会了“猫”这个字对应的毛茸茸的软毛质感、“下雨声”对应窗玻璃上蜿蜒的水痕、“开心”这个情绪对应人弯起来的眼角。这些关联不是靠程序员写死的规则教出来的,是它自己从海量数据里摸出来的对应关系。
我上周测到的最让我起鸡皮疙瘩的细节
周末我妈给我发了张家里阳台的照片,没配任何文字。我把图丢给多模态大模型,只问了一句:“我妈今天在阳台忙了啥?”
三秒钟之后,回答跳出来:“你妈应该刚给三盆绿萝浇完水,把之前开败的长寿花残枝剪了,本来想找个通风的地方晾那半袋大米,结果被靠在墙根的拖把挡了路,正准备挪位置。”
真的,当时看到回答的瞬间鸡皮疙瘩都起来了!我妈当天打视频的时候,真的在吐槽拖把挡着米袋,挪了半天没腾出来地方。
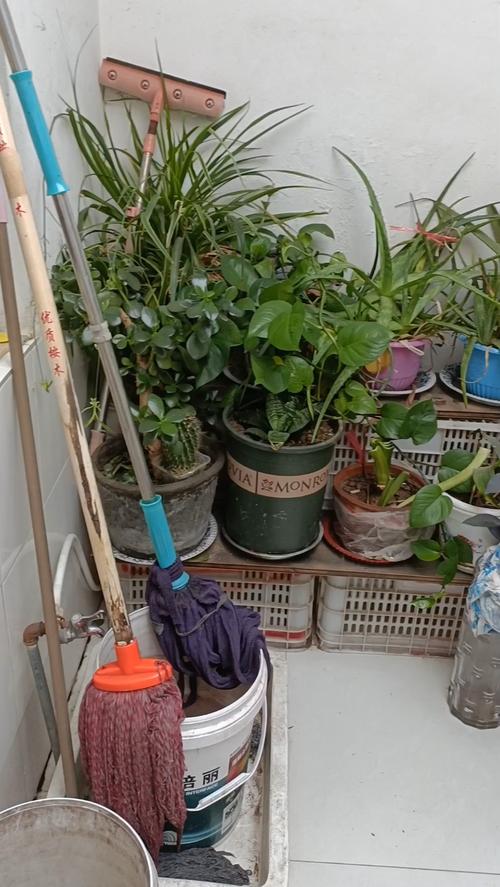
换作以前的老模型看到这张图,只会干巴巴罗列元素:三盆绿植、半袋大米、一个拖把。它不会把这些零散的碎片串成有时间线的行为逻辑——它甚至能注意到长寿花枝桠上留的新鲜剪口、绿萝叶片上挂的还没干的水珠、大米袋朝窗的开口方向,把这些没人特意标注的细节,拼出完整的生活场景。
这才是真的“看懂”。不是对着图片背标准答案,是能顺着细节摸到图片背后的人在做什么。
别被网上的宣传吹得飘起来
当然,我也不是要把这东西吹得天上有地下无。拉倒吧,它现在离“全知全能”差得远呢。
我上次拿自己拍的日落照片做测试,让它把画面里的白杨树换成梧桐树,把天空调成傍晚六点的橘色,再配一段适合发朋友圈的文案。结果生成的图里,梧桐树的树干直接长在了人行道的栏杆上,配的文案还说“今天的风带着满街桂花的香气”——可我拍照片的那条街,行道树都是悬铃木,连半棵桂花树都没有。
很多人对它的误解,是把“跨模态识别”等同于“跨模态理解”。它现在能认出图里有什么,能把常见的元素拼到一起,但很多时候,它的关联是从训练数据里摸出来的“常见组合”,不是真的建立了对物理世界、生活常识的认知。比如你给它看一张倾斜的玻璃杯,问它杯子里的水会往哪流,它有时候会一本正经地回答“往杯口的方向流”——根本不对,它只是从之前见过的“倾斜杯子”的图片里找了个最常见的描述,根本没意识到重力的存在。
更搞笑的是我上次拿自己做的蛋炒饭照片测试,问它“我这盘蛋炒饭放了多少盐”,它一本正经地说“从菜品颜色判断,大概放了3克盐”。拉倒吧,我自己做饭的时候放了多少盐我都记不清,它隔着一张二维照片就能精准算出来?纯纯瞎蒙。
那这东西到底有啥用?说穿了,它最擅长的就是帮你省那些细碎的、麻烦到你根本不想动手的小事。比如做电商的朋友,拍了一堆产品图,不用对着屏幕绞尽脑汁想标题、写卖点,把图丢给它,它能顺着图里的细节写出贴合的描述;比如手机里存了几千张旅行照片,不用一张张翻着分类,跟它说“把所有拍了山的、拍了吃饭的、拍了朋友合影的挑出来”,它能直接给你分好相册;比如路边碰到好看的花,拍张照问它“这花好不好养,我家朝南的阳台能不能活”,它能顺着品种给你讲明白养护注意事项,不用你打开好几个APP来回搜。
昨天我又试了下,对着我家猫打哈欠的照片,说“这货是不是又想拆家了”。它回我:“它现在是刚睡醒的松弛状态,暂时没有拆家计划,你可以喂个猫条转移下注意力。”
你看。
哪有什么黑科技。
不过是慢慢学会了,看懂你没说出口的那半句话而已。
作者|科技
排版|科技
审核|满满