你以为的”记忆”,其实是网在牵线
很多人遇到这种被精准戳中喜好的时刻,第一反应是手机在窃听。 真不是。 你上周三买过一次微辣的卤鸭头,上周六因为胃不舒服没吃冰,三天前刷短视频的时候给一个讲羊汤熬制的视频点了赞,昨天下午跟同事聊起最近降温想喝热的。这些零散的、你自己转头就忘的碎片,根本不是被当成”搜索记录”存在某个冰冷的表格里的。 它们被拆成了一个个带标签的节点:你(用户)、微辣卤鸭头(商品)、胃不舒服(身体状态)、羊汤熬制(内容标签)、降温(环境事件)。节点和节点之间扯着细而韧的线:你买过鸭头→你能接受中辣以下的口味;你胃不舒服→你最近被推荐的饮品不能加冰;你刷过羊汤视频→你对热汤类餐品的关注度比其他餐品高。这些线的粗细,就是两个节点之间的关联强度——离你越近的线,推给你的概率就越高。 很多人对这种个性化推荐的误解,觉得就是APP存了你的搜索记录、买过的东西,列个表格给你推相似的。那种最原始的标签推荐,早就被淘汰了。比如你上次买了一次婴儿奶粉,算法要是只靠”买过奶粉”这个标签给你推,接下来半年都会给你推母婴用品,但实际上你那是帮刚生娃的同事带的,你自己连猫都没养。 但这张网就不一样,它拆出来的节点不是孤立的:”买婴儿奶粉”这个行为,关联的是”同事关系””临时代购”这个属性,跟”有育儿需求”这个节点之间的连线,弱到几乎看不见,自然不会随便给你推纸尿裤。
别被”AI新贵”的名头吓住,它最早是给图书馆做的
说真的,现在网上但凡提到知识图谱,总有人把它吹成大模型时代才冒出来的全新黑科技。 真不是。 早在上世纪七八十年代,图书馆的管理员就被检索问题折腾得头大。你想找一本讲”唐代长安城的葡萄酒贸易”的书,关键词打”唐代””长安””葡萄酒”,出来的结果有讲唐代服装的,有讲长安建筑的,有讲现代葡萄酒庄园的,翻半小时都找不到要的东西。 那时候他们就琢磨,能不能把每本书里提到的所有东西都拆成小碎片,再把这些碎片按关系连起来:哪本书提到了长安,哪本书提到了葡萄酒贸易,哪本书的作者曾经在唐代做过官,甚至书里提到的某幅壁画上画了酒肆。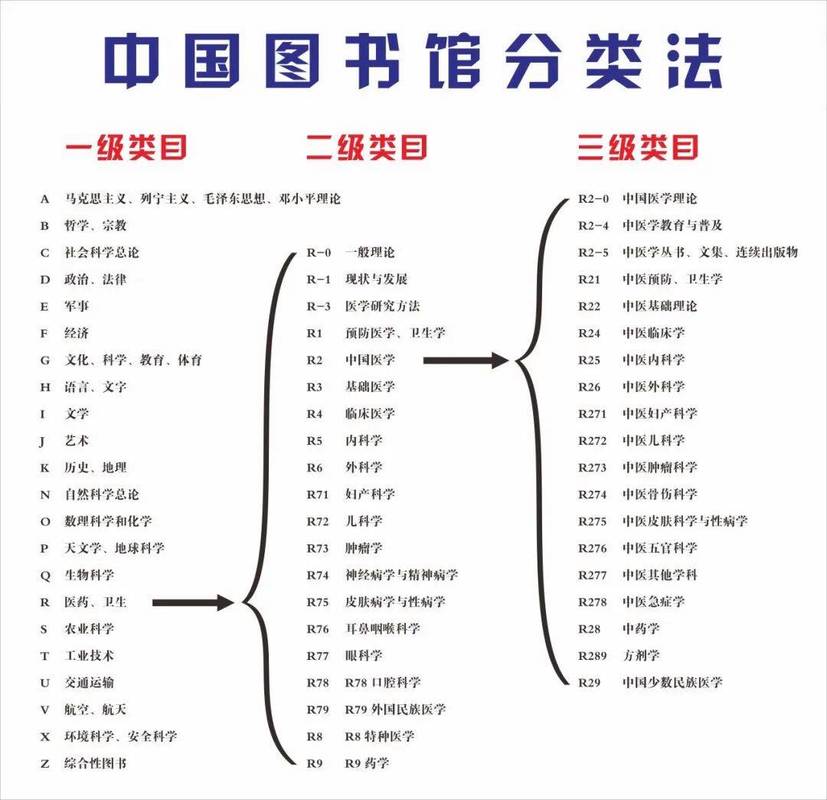
现在吹得太狠的”万能图谱论”,真的错得离谱
我前阵子帮朋友看他们公司做的内部知识图谱,整整花了三个多月,拉了十几个员工加班,最后做出来的东西连个找内部报销流程都不准——为啥?因为他们当初建图的时候,把所有能搜到的内部文档都往节点里塞,既没区分哪个是2019年的旧制度,也没区分哪个部门的流程适用于哪个岗位,整张网全是死结。你说这能好用吗? 很多人对知识图谱的误解,就是把它当成了一个一劳永逸的”信息大仓库”,建完就可以放那不管了。 哪有那么好的事。 知识图谱从来不是什么”万能的大脑”,它本质上是一张帮AI”少犯低级错误”的导航图。就像你开车去一个陌生的地方,导航不会替你决定今天要去哪,但是它能告诉你哪条路堵了,哪个地方有摄像头,哪条路离你要去的餐馆最近。大模型的问题是什么?是它记性太好,但是经常把记混的东西当真——比如把”鲁迅的原名是周树人”和”鲁迅写过《呐喊》”混着混着,就说成”周树人写过《彷徨》是郭沫若的作品”,这时候知识图谱就跳出来指着节点说:不对,《彷徨》的作者是鲁迅,跟郭沫若没关系,线不能这么连。 我前阵子见个创业团队,说要做个覆盖全人类所有知识的知识图谱,未来要让所有人的问题都能从这张图里找到答案。我当时听了都愣——连图书馆的管理员都不敢说自己能把所有书的关系都理清楚,他一个十几个人的小团队,凭啥啊? 你想啊,你自己的喜好都在变,上个月你还无辣不欢,这个月吃了顿火锅得了肠胃炎,以后看到辣的就犯恶心。这张网要是不跟着你的喜好实时更新,过俩礼拜还给你推爆辣火锅,那跟那些只会偷看你搜索记录的破算法有啥区别? 上次跟那个做算法的朋友吃夜宵,他说现在行业里越来越少有人提”超级图谱”了。大家都开始做小的、专的:给连锁餐厅做个管供应链的小图谱,给出版社做个管作者版权的小图谱,甚至给宠物医院做个管病历的小图谱。 这些小图谱没有什么惊天动地的功能,就是能帮人少翻几个表格,少犯几个低级错误,少走点冤枉路。 其实想想也对。 你第一次被APP猜中喜好的那个瞬间,根本不是什么多么神奇的科技奇迹,就是一张网里,两根离得近的线轻轻碰了一下而已。 哪有那么多玄乎的东西。作者|科技
排版|科技
审核|见微