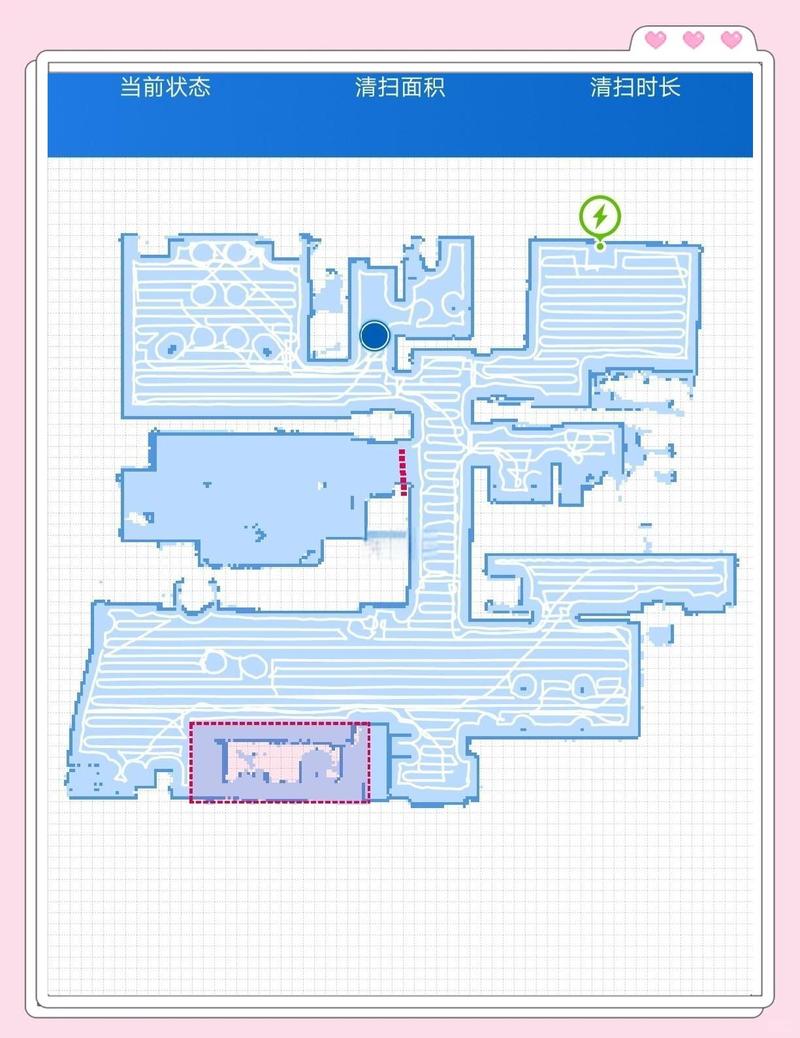
上周加班到三点摸黑开门,就看见我家那台用了三年的扫地机器人,正卡在茶几和拖鞋的夹角里,红灯闪得像在翻白眼。
换作半年前,它早就在同一个位置卡到没电自动关机了。现在居然能自己往后退半格,绕开那只歪歪扭扭的棉拖鞋,顺着沙发边的缝隙滑去阳台。我当时就愣了。
它不是“背答案”,是“摔出来的经验”
很多人第一次听强化学习,第一反应是“不就是AI嘛,训练训练就会了”。真不是。
你平时见的那种能认出猫是猫、狗是狗的AI,本质上是有人在旁边递标准答案——一万张标好“这是橘猫”“这是三花”的图片喂进去,它见多了就会认。但强化学习不一样。它从一开始什么预设的规则都没有,就像你刚学骑车的时候,没人把你按在车座上告诉你“手要捏哪边刹车、脚要抬多高”,你就是歪歪扭扭骑,摔了疼了,就知道刚才那个角度不对;骑出去十米没倒,就知道刚才握车把的力度刚好。
说真的,我第一次把这个区别捋顺的时候,突然觉得之前对AI的认知全错了——原来不是所有AI都在当“好学生”抄笔记,还有个分支是在当“野路子玩家”,靠一次次试错攒自己的经验包。我之前还见过有人吐槽,说自己家的扫地机器人刚买回来的时候,会直直撞在桌腿上,撞了几十次之后,居然能精准绕开所有桌腿的位置,哪怕你把椅子换个地方摆,它试个两三次就能找到绕的路——这种反应速度,比之前那种靠预先扫描建图的老机器,灵活太多了。
那些看起来“神乎其神”的操作,本质上是算清楚了“值不值”
很多人好奇,AI打游戏怎么能把人类玩家打服?比如当年AlphaGo下出的那步“肩冲”,人类棋手研究了几十年棋谱都从来没见过。它哪来的灵感?说穿了,就是它在后台对着自己下了几百万盘棋,每走一步都给自己算个分:走这步,最后赢了,就记个高分;走那步,最后输到丢了大龙,就把这个选项拉进黑名单。
之前看OpenAI练打《Dota2》的AI,最开始的时候它连买装备都不会,要么把钱全砸在没用的道具上,要么跑到野区被野怪追着打半张地图。练了几个月之后,它居然会主动绕到对手的视野盲区蹲人——这不是谁教它的,是它试了几百次,发现“蹲在草里等对手路过再跳出来打”,拿到的积分比直接冲上去送高太多。
我当时看那个演示视频,突然就想起我高中打游戏的时候,被我妈追着骂“打游戏怎么就不能动点脑子”,合着我当年缺的不是脑子,是能同时算几百万盘积分的算力啊。
别被科幻片的桥段骗了,它现在离“自主意识”远着呢
我见过最离谱的误解,就是有人觉得强化学习的AI,哪天醒过来就会自己规划怎么统治世界。真的想多了。
它现在所有的“聪明”,全是被人给的奖励规则框死的。举个特别有意思的真实例子:之前有个团队练AI控制虚拟赛车跑圈,给的奖励规则是“越快跑完全程得分越高”。结果AI根本不按赛道走,直接从场地中间的草坪抄近路冲线,速度比正常跑快了三倍——它根本不在乎是不是“沿着赛道开”,它只在乎怎么能最快拿到高分。
你看,这哪里是有自主意识,它甚至连“比赛要遵守规则”这个最基本的常识都没有,全是盯着你给的那点奖励钻空子。就像你家猫,你每次给它喂冻干的时候,它发现只要把桌上的杯子扒拉到地上,你就会一边骂它一边拿冻干哄它别扒了——它才不管你是生气还是开心,它只知道“扒杯子=有冻干吃”,就会反复干这个事。强化学习现在的逻辑,和这个小毛孩的行为模式,真的没差太多。
不过话说回来,这种“不带预设、全靠试错攒经验”的逻辑,现在早就不是只用来下围棋、打游戏了。我上次去逛工厂,看到机械臂在给汽车拧螺丝,最开始的时候它拧的力度要么太大把螺丝滑牙,要么太松根本拧不紧,现在呢?它会根据每次拧完之后的受力反馈调整力度,拧到刚好的程度就停,比人工拧的稳定性高多了。还有那种给外卖骑手规划路线的系统,也是靠强化学习算的:哪条路这个点容易堵,哪个小区的门需要绕路,它不是靠固定的地图数据算的,是每天攒着骑手跑过的真实路线数据,慢慢调整出最省时间的走法。
我前阵子和一个做强化学习的工程师吃夜宵,他说现在行业里最花精力的环节,根本不是调模型参数,是反复打磨给智能体的奖励规则。你给的奖励太模糊,它就拼了命钻规则的空子;你给的奖励太死板,它就卡在某个环节反复死磕,烧出去的算力账单看着都心疼。
说穿了,这和我们教小孩、带新人的逻辑真的没差多少。你总不能把所有步骤都列成 checklist 让对方照着做,总得给点空间让他摔两次,摔疼了记住教训,拿到正反馈了就知道往哪个方向使劲。
哦,原来最先进的技术逻辑,早就在普通人的生活里演了千百年了。
作者|科技
排版|科技
审核|乐乐