 大讲堂

他们之前用开源13B模型做表面缺陷检测,要两张A10显卡才能跑满30帧的推理速度,硬件成本摊下来一年快小二十万。结果换了INT4量化版本之后,直接在车间用了五年的老工控机上跑起来了,帧率没掉,缺陷识别率和原来的FP16版本差不到1个百分点。
这不是什么黑科技。
就是模型量化。
很多人现在把大模型落地的瓶颈全推给“算力不够”,但很少有人提,现在大家用的大模型,从训练到推理,其实有一大半的算力是被“浪费”掉的——那些占了32位存储空间的浮点参数,大部分根本不需要那么高的精度,就能让模型输出正确的结果。
模型量化的本质:不是丢精度,是换记账方式
别被网上那些营销稿忽悠了,量化不是把模型参数随便砍一半。
你可以把大模型的参数想象成你记账的数字:原来你记每一笔账,都精确到小数点后三位,比如今天买菜花了12.345元,其实你根本不需要记到厘这个单位,只要记到元,甚至记到十块的区间,你完全能知道自己这个月花了多少钱。
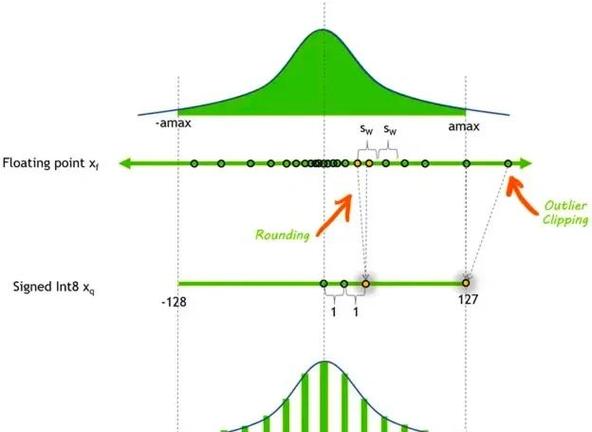
量化的核心逻辑,就是把原来用32位浮点数(FP32)存储的连续参数,映射到一个只有256个离散值的整数区间(比如INT8),甚至只有16个离散值的区间(INT4)。整个过程不改动模型的结构,不减少参数的数量,只是给每个参数找一个最接近的“替代值”,把原来占32位存储空间的数字,压成8位甚至4位。
当然,它不是万能的。
技术边界非常清晰:如果你的场景对精度的要求是“差0.1%的结果就会出人命”——比如做航空发动机的仿真计算、做高精度的药物分子模拟,那量化基本没用,掉的那点精度可能直接让结果完全失真。但90%以上的通用场景:对话、文案生成、工业质检、代码补全,用户对1-2个百分点的精度损失根本感知不到。
我见过最离谱的一个测试,有人拿INT4量化的7B模型做高考模拟题,分数比FP16版本低了3分,但同一份卷子,不同人做的分差可能都不止10分。这种程度的损失,在实际落地的时候完全可以接受。
现在的量化赛道:从实验室小技巧变成落地刚需
最早的量化根本不是针对大模型做的。
十几年前大家做计算机视觉的小模型,就已经开始用训练后量化(PTQ)——就是模型训练完了,再把参数压成低精度。后来发现PTQ的精度损失太大,又搞出了量化感知训练(QAT)——就是在训练的时候就模拟量化的误差,让模型提前适应低精度的参数,最后再压缩。
但这些方法在大模型时代之前,都是实验室里的小技巧,根本没人当真。直到2023年之后,开源大模型的参数从7B涨到70B,再到几百B,大家突然发现,原来的推理硬件根本跑不动了。
然后就有了现在大家耳熟能详的GPTQ、AWQ这些专门针对大模型的量化算法,能在几个小时内把一个70B的模型从FP16压成INT4,精度损失控制在2%以内。
现在整个赛道的生态已经变了。
Hugging Face上下载量最高的Top20开源模型,一半都直接提供INT4、INT8的量化权重包,用户下载完就能跑,不用自己调。国内的云厂商在推自己的开源大模型时,也会把量化版本作为标配——毕竟谁都知道,用户拿到一个模型,第一反应不是“我要花多少钱买A10跑全精度”,而是“我能不能用手里的旧电脑跑起来”。
我那个做工业质检的客户,后来算过一笔账:原来他们要给每个车间配一台两万块的推理盒子,现在用量化后的模型,直接用原来的工控机就行,一个100个车间的工厂,光硬件就能省两百万。

但现在的卡点也很明显。
根本不是算法不够好。是跨硬件适配的问题。你在英伟达的卡上用量化工具压出来的模型,拿到昇腾、寒武纪这些国产芯片上跑,可能速度直接掉一半,精度还崩了。现在大部分做量化的团队,都是针对单种硬件做优化,没有一套通用的量化标准,这也是为什么现在很多企业落地大模型的时候,一提到量化就头疼——不是不好用,是换个硬件就得重新调一遍。
别把量化当万能解药:藏在压缩比背后的坑
我见过太多厂商吹自己的量化压缩比能到8:1,零精度损失。
纯纯扯淡。
大部分这种宣传,都是拿通用测试集做的结果——就是那种网上随便能找到的对话测试、知识问答测试集,INT4量化在这些测试集上的分数确实和FP16差不了多少。但实际落地的时候,你会遇到大量测试集里没有的长尾问题,这时候量化的隐性损失就出来了。
比如你拿INT4量化的模型做电商客服,平时回答“怎么退货”“发票怎么开”这种标准化问题完全没问题,但遇到用户问“我去年12月买的那个带logo的保温杯,现在盖子摔碎了能不能单独配配件”,模型可能就开始胡言乱语,把别的产品的配件信息安上来。这种问题在标准测试集上根本测不出来,但对用户来说就是实打实的糟糕体验。
还有更隐蔽的风险。
已有学术研究指出,过度激进的量化操作,可能会降低模型的隐私防护能力,让攻击者更容易从模型输出中反推出训练集里的敏感信息——比如训练集里的用户手机号、企业内部的合同条款。之前有个做金融模型的团队,为了把模型跑在本地服务器上,直接把70B的模型量化成INT2,结果测试的时候,模型能直接背出训练集里某条客户的身份证号,给他们吓出一身冷汗。
很多小团队现在做模型落地,根本没有能力做量化后的全场景精度校验,直接拿开源的量化包就上线。这种情况如果发生在政务咨询、医疗辅助诊断这些场景里,出了问题谁担责?
我上次看到一个厂商的宣传,说他们的量化模型在政务咨询场景的准确率是98%,我拿他们给的演示包跑了下,问了一句“外地户口在本地办护照需要带什么材料”,模型直接给了三年前的旧政策。合着他们的测试集,全是五年前的老题是吧?
未来3-5年:量化会变成模型的“默认出厂设置”
别觉得以后硬件性能上来了,量化就没用了。
现在大模型的参数增长速度,比硬件性能提升快太多了。你就算明年的消费级显卡能流畅跑70B的FP16模型,后年出来的200B参数的通用模型,你还是得靠量化才能跑起来。这就像你家网速再快,看视频还是要压缩——不压缩的话,4K视频一秒钟就要传几百兆,再好的网络也扛不住。
我对未来几年的判断其实很明确:
第一,以后新发布的大模型,不会再只提供FP32或者FP16的全精度权重包,会直接把INT8、INT4的量化版本作为标配,就像现在的视频平台会给用户提供不同清晰度的选项一样,用户可以根据自己的硬件能力选最合适的版本。
第二,量化会从推理端往训练端渗透。现在大模型的训练成本动辄几千万,要是在训练的全流程都用上低精度量化,能把训练的硬件成本降个30%-40%,这个诱惑没有哪个厂商能扛得住。
第三,会出现专门的量化适配中间层。以后不会再出现“在英伟达卡上量化的模型换个硬件就崩”的情况,会有一套通用的量化标准,不管你是什么芯片、什么模型,这个中间层自动帮你做最适配的量化,让模型在任何硬件上都能跑的又快又准。
最后说句实在的。
模型量化从来不是什么高大上的技术,它本质上就是大模型落地过程中的“减磅动作”——就像你要开车走山路,得把车上没用的东西搬下来,才能跑的更快。但很多人现在把这个减磅的动作吹成了能让车飞起来的黑科技,这就有点过了。
它能帮你把原来跑不起的模型跑起来,能帮你把硬件成本砍一半,但它救不了一个本来就训练的稀烂的模型。
就这么简单。
作者|fawen
排版|fawen
审核|见微