2026-09-26 21:52:07 分类:科技
Sora炸场之后,所有人都在聊文本到视频生成的突破,少有人注意到,底层的文本到动作生成方向,卡了行业快十年的核心问题,就是文本到动作生成运动连贯性。
为什么运动连贯性是技术落地的生死关
你给AI一段文本描述,“一只猫从树上跳下来,落地后抖了抖身上的水,慢悠悠走到食盆边低头吃饭”。
现在大多数模型能生成每个拆分动作,拼起来就出问题。跳下来的时候身体旋转角度不对,落地重心歪了,抖水的时候只有头动身体僵着,走的时候顺拐,甚至一半身子已经到食盆了,另一半还在树下。
这种问题不是无关痛痒的小bug。做数字人直播,动作卡三秒,观众直接划走。做游戏动画,动作违和,玩家直接出戏。做虚拟主播,动作跳脱,哪怕台词对得上,也没人愿意待。
 文本到动作生成连贯与卡顿效果对比图
说实话,这种拼接出来的动作,那种违和感真的刻在骨子里,人类一眼就能识破。本质上,运动连贯性要求的不是把单个动作按顺序拼起来,是三个层面的统一:第一是符合生物运动的物理规律,重心不能乱,关节转动不能超出生物极限;第二是符合文本语义的时序逻辑,动作转换要自然,不能说“开门”动作做完了,手还保持推门的姿势僵着;第三是长时序下的误差不累积,做十分钟连续动作,不能越跑越歪,最后角色直接飘在空中。
缺了任何一个,都谈不上合格的连贯性。
现有技术路线的突破与遗留盲区
最早的解决方案是动作库拼接。把常用动作切分成片段存起来,按文本语义匹配拼接。优点是快,成本低,缺点是拼接处永远有肉眼可见的卡顿,换个角色体型就适配不上,遇到训练库没有的新动作直接崩盘。
扩散模型火了之后,行业转向端到端生成:把文本语义编码之后,直接逐帧生成连续的动作序列,效果好出来一大截。去年几个头部科技公司和游戏厂商出的新模型,已经能做到一分钟级的单人连续动作没有明显卡顿。
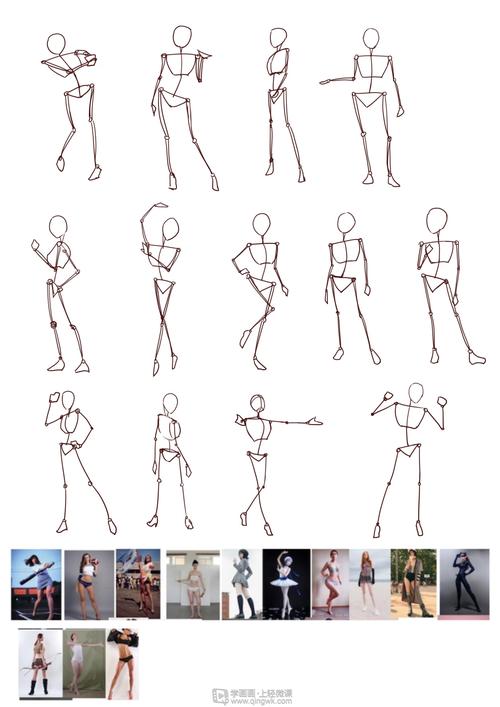 文本驱动连续动作生成角色骨架追踪图
现在的核心进展,是不少团队把运动先验约束塞进了训练过程,提前把人类、生物运动的统计规律喂给模型,生成的时候每一步都约束关节和重心的位置,不让它乱飘,之前常见的抖动摇晃问题,解决了一大半。说实话,我上个月在一个游戏技术沙龙上看了国内厂商内部模型的演示,一段三百多字的剧情动作描述,生成出来接近两分钟的连续动作,除了转身的时候裙摆稍微有点穿模,肉眼几乎看不出卡顿。那时候我才意识到,这个卡了十年的问题,真的快摸到量产的边了。
不过话说回来,盲区还是很大。现在做得好的都是单人简单场景,一旦加了交互,比如两个人握手拥抱,一边走路一边聊天同时翻书,这种多复合动作,十次有六次会出问题。要么两个人身体穿模,要么一个人动作正常另一个直接僵住。还有就是长尾场景,比如残疾人的运动,特殊职业的专属动作,训练数据少,生成出来的连贯度直接掉一半,根本没法用。
产业落地的路径与未来三年预判
 产业落地的路径与未来三年预判
现在最先落地的,肯定是游戏和影视内容生产端。原来做一个二游的支线剧情动画,一个熟练动画师做一分钟要三到五天,成本大几千,如果用文本生成连贯动作再加人工后期微调,半天就能出成品,成本直接降十分之九。对中小团队来说,这个诱惑力真的太大了,原来没钱做长剧情的,现在也能做内容了。
其次是ToC的数字人赛道。现在的实时数字人,要么用预录动作,要么靠动捕设备,门槛还是高,如果能直接按直播台词实时生成连贯动作,那中小主播也能轻松用上数字人,成本直接打下来。
落地的障碍其实也很明显。第一个是模型大小,现在能生成长连贯动作的模型,参数都不小,端侧跑不起来,云端生成有延迟,实时交互场景还是没法用。第二个是版权问题,现在训练用的动作数据大多来自动作捕捉库,很多没有商用授权,真的量产的时候很容易踩法律坑。
现在也有不好的倾向,不少厂商为了凑AI概念,把低连贯度的模型包装成“AI生成动作”推给市场,一堆卡顿动作出来,反而把用户对AI动作的体验做砸了,本来用户接受度就不高,这么搞等于自废武功。
回头说未来三到五年的判断:
1-2年内,运动连贯性的问题会先在离线内容生产场景落地解决,大量中小游戏公司会把AI文本转动作当做产线的标配工具,替代80%以上的中长尾动画工作,只需要人工微调,整体产能至少提五倍。
3-5年,随着小模型压缩和稀疏注意力技术的进步,端侧能跑的高连贯度文本转动作模型会成熟,实时互动的数字人、VR/AR里的AI角色,都能用上原生文本生成的连贯动作,那时候才是真的改变整个虚拟内容的生产生态。
会不会有一天,我们根本分不出来眼前的数字人动作是AI生成的还是专业动捕出来的?我觉得,用不了五年。
免责声明:市场有风险,选择需谨慎!此文仅供参考,不作买卖依据。如有侵权请联系删除。
文章名称:破解文本到动作生成运动连贯性:产业落地的核心卡点
文章链接:https://www.lfdjt.com/info_23_22161.html
 大讲堂
