2026-10-11 16:32:02
作者:
科技
九月二十三号的南京,落一下午黏糊糊的秋雨。我躲进珠江路巷口那家开了快十年的老咖啡馆,找了个靠门的位置蹭暖气。
木桌子沾着前桌撒的桂花拿铁渍,擦了两遍还是留印子。
戴黑框眼镜的学生凑过来,说听过我聊科技,攒着胆子问个问题。他面算法岗终面,面试官问“你说你懂大模型,那大模型算法到底凭什么变大就变聪明了”,他背了一堆Transformer的定义,面试官听完摇摇头,没给过。
太正常了。太多人刷了一屏幕科普,看完还是只记住了“参数大”“算力高”,核心的算法逻辑,全是懵的。
大模型不是堆参数堆出来的,算法才是骨架
很多营销号说大模型就是靠砸钱堆GPU堆数据,把全世界的文字全塞进去就厉害了。
真不是这么回事。参数就像你家房子的面积,算法才是打地基搭骨架搞装修的人。给你一千平的毛胚房,摆东西全乱堆,你还是住不舒服。
Transformer出来之前,做语言模型的算法是什么路子?就像你闭着眼睛走独木桥,只能一步一步往前挪,看了后面忘了前面。处理一段话,读到第十个词的时候,第一个词的信息已经磨得差不多了。碰到长句子,直接乱套。
Transformer里的自注意力机制,把这个路子彻底改了。说白了,就是让模型每处理一个词,都能同时扫一遍整段话里的所有词,立刻能找到哪个词和它有关系,关系有多近。
举个最俗的例子:“李华去南京玩,他带了一只盐水鸭回去给朋友”。以前的算法,走一步看一步,可能到最后“他”是谁,已经记不清了。大模型靠自注意力,一眼就看到开头的李华,一秒锁对。
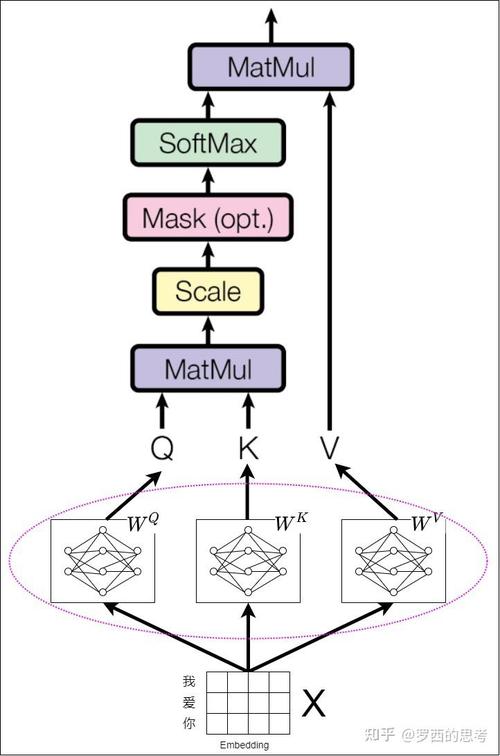 Transformer自注意力机制工作原理示意图
就这一步改变,给大模型拉开了序幕。后来这些年,大模型能越长越大,全靠算法顺着这个框架不停改。原来算一次自注意力要吃掉半块GPU的内存,算法工程师改了计算逻辑,把没用的重复计算砍了,一下子省出好几个G的空间,就能塞更长的文本,放更多的内容。
说白了,没有这些算法优化,你堆一万块GPU,也跑不出一个能聊天的可用模型。
别被骗了:大模型根本没“记住”所有知识
我刷到过不下十个博主,张嘴就说“ChatGPT把整个互联网都存在它的参数里了”,听得我一口咖啡差点喷出来。
这是对大模型算法最大的误区。
大模型的参数里,存的从来不是一本一本的百科全书,也不是一段一段的聊天记录。它存的是文字和文字之间的关联规律。
什么意思?你给它喂了一千万篇提到“南京盐水鸭”的文字,它没背下来哪篇文章写了盐水鸭的做法,它只是摸清楚了:说“南京”的时候,后面跟着“盐水鸭”的概率,比跟着“热干面”高多了;说“做法”的时候,下一步说“处理鸭子”的概率,比说“坐飞机”高多了。
它给你写出来的盐水鸭做法,本质上就是顺着它摸出来的概率,一个字一个字拼出来的。
它根本不需要“记住”哪篇原文。
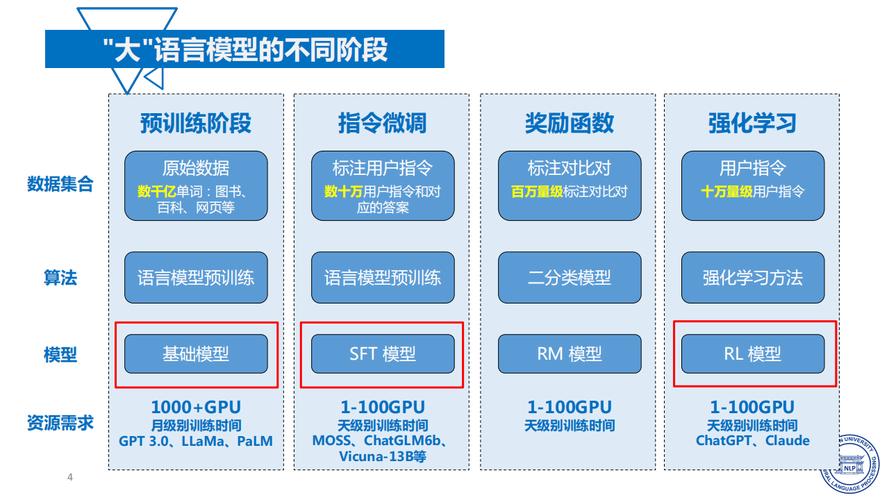 大模型预训练知识存储逻辑对比图
哦对,这个道理能解释好多怪事。为什么大模型有时候会一本正经说瞎话?因为它拼概率的时候,刚好拼出来一串逻辑通顺但完全不对的话,它自己根本不知道错了,因为它本来就不知道什么是“对”“错”,它只懂概率。
为什么大模型不会随便把你刚才的聊天内容泄露给别人?除非你的聊天内容被拿去训练了,否则它根本没地方存你的内容,下一次生成是重新拼概率。那些说“大模型会偷偷记住你所有发言”的焦虑,大半都是瞎扯。
接下来的大模型算法,风向早就变了
 接下来的大模型算法,风向早就变了
前两年圈子里全是比参数,你千亿我万亿,仿佛个头越大越厉害。
最近半年,风向转得不要太快。
大家回过神来了:要那么大个头干嘛?普通用户用个聊天功能,写个文案,手机本地就能跑的小模型,它不香吗?延迟低,还不用传数据到云端,隐私还安全。
那小模型怎么能有大模型的能力?靠算法。现在火的“知识蒸馏”,不就是让已经训练好的大模型当老师,把它会的东西,浓缩教给小的,小模型只要学到大模型的规律,不用那么多参数,就能干差不多的活。这全是算法的功劳,和堆钱堆参数没关系。
还有多模态,原来的大模型算法只处理文字,现在要把图片、音频、视频全揉到一块,原来的自注意力机制就得改,得适配不同类型的信息,得能找出来文字和图片里内容的关联,这又是一堆新的算法活。
说实话,我特别烦现在行业里的歪风,拿参数当卖点,像菜市场卖菜似的,比谁分量足。南京买鸭子,没人买最大的,三斤左右的湖熟麻鸭,皮脆肉嫩,刚好。太大的鸭子,肉老柴,没人要。
大模型算法不也是这个道理?能把活干好,适合场景,就是好算法,管它参数多少。
不过话说回来,现在好多新出来的概念,也都是吹出来的。什么通用人工智能马上就来了,什么模型会自己进化,听听就好,真落地还早着呢。
那天聊完,学生抢着买了单,说原来之前背的那些定义全是虚的,现在一下子通了,下次面试肯定不会懵了。我出门的时候,秋雨停了,巷口卖鸭子的摊子冒热气,斩半只带走,皮脆得咬开咔嚓响。
大模型算法哪里是什么黑魔法啊,不就是一帮聪明人攒了几十年,一步一步改出来的工具,刚好走到了能用的地步而已。哪有那么多玄乎的东西,好吃的鸭子比什么玄乎的术语都实在。
免责声明:市场有风险,选择需谨慎!此文仅供参考,不作买卖依据。如有侵权请联系删除。
文章名称:咖啡馆里聊大模型算法:原来它不是魔法
文章链接:https://www.lfdjt.com/p/keji/a/8947.html