2026-10-09 21:39:57
作者:
科技
上周六在南京新街口附近赶稿子,约了做算法的朋友喝咖啡,刚咬了一口桂花拉糕,手滑掉了小半块在桌角。朋友掏出手机点开一个内测工具,拍了张照,对着话筒说“你看这个,掉了三分钟,桌面刚擦过,还能吃吗”。
几秒钟出结果。不说“食品掉地上不能食用”这种正确的废话,它对着图圈了掉在外头那层面,说“外层沾了桌面浮尘,切掉这部分就可以,南京本地桂花拉糕一般用的是糯米和糖,没那么容易染菌,丢了可惜”。
我当时就愣了。换做两年前的AI,根本做不出这种回答。这就是现在大家聊烂了的多模态大模型,但是大多数人,其实都没搞懂它到底厉害在哪。
别翻百科了,先讲你能摸到的多模态
很多百科给你说“多模态大模型是能够处理和理解多种模态信息的大语言模型”,讲了跟没讲一样。
说白了,原来的AI都是“近视眼”或者“聋子”。只会认字的就只能跟你打字聊天,你发张图过去它认不出是什么;只会看图的就只能给你分类打标签,你跟它说“帮我看看这张图里的发票金额加起来是多少,我上个月出差超了多少”,它根本理不清你的需求。
多模态就是给AI把所有感官拼上了。你说话、发图、拍视频,甚至甩个录音文件过去,它能把所有信息放一块理解,不是分开干完再拼结果。
 普通用户手机端多模态大模型交互演示
就拿刚才我掉拉糕那个例子来说,分开处理的话,图像识别只会说“这是一块桂花拉糕,掉在木质桌面上”,语言模型只会回答“掉在桌上的食物能不能吃看污染程度”,根本给不出那个切了就能吃的具体回答。多模态是真的把图里的场景、你说的上下文,揉成一个完整的意思来回答你。
说实话,就这一点点进步,用起来体验真的差好多。
最容易踩的三个误区,很多人搞反了
很多人觉得,能生成图文音视频才叫厉害的多模态大模型。不对。很多落地挺好的多模态模型,根本不生成图,就是做理解,已经足够改变很多场景了。
比如小区的快递驿站,老板拍个快递柜的图,随口说“帮我把所有收件人手机号摘出来,发我短信模板”,它直接就弄好了,根本不需要老板一个个输,也不需要生成什么新东西,就把你要的信息从图和话里抠出来整理好,这就够有用了。
还有人说,多模态就是给C端用户做聊天生成的,To B没用。刚好反过来。最早吃到多模态红利的,都是工业、服务业的B端。
我上个月跟朋友去浦口的工厂参观,车间里的维修工人,现在遇到看不懂的故障灯,掏出手机拍个机器的图,直接说“今天早上开机之后这个灯一直闪,昨天还好好的”,模型直接调出对应的维修手册,给你圈出来哪一步查什么,比原来翻半天手册快太多了。
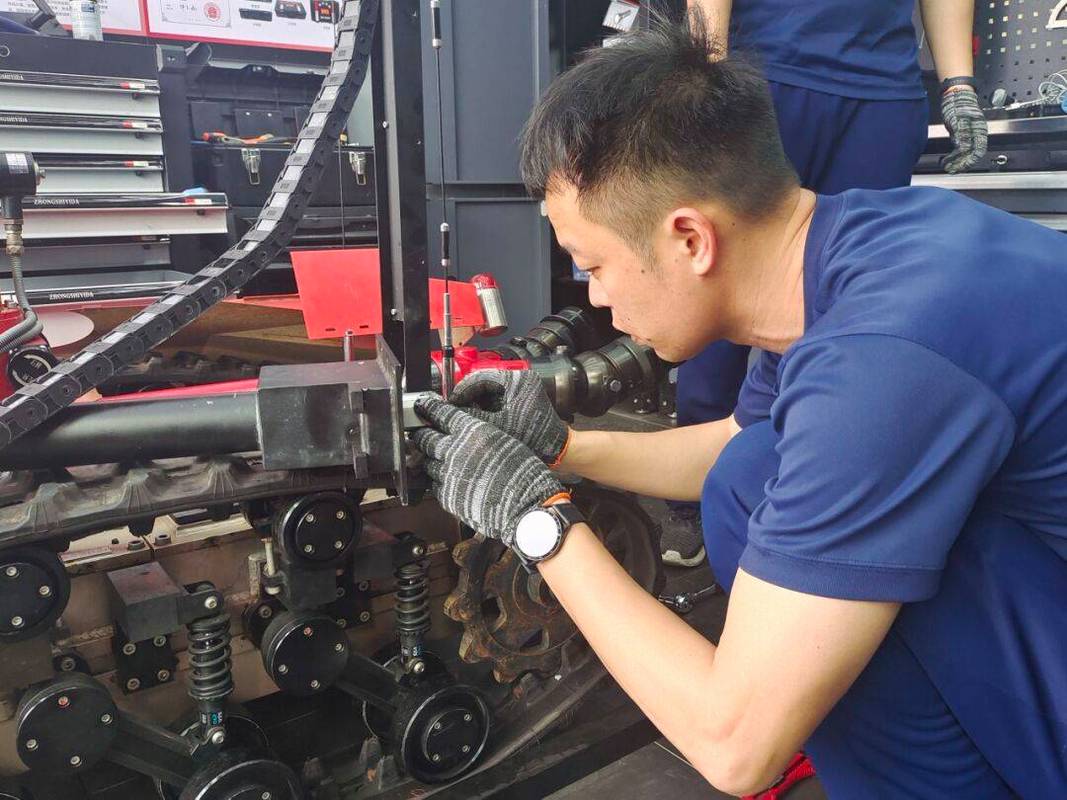 工厂维修工人用多模态大模型排查设备故障
更多人说,多模态一定会抢内容创作者的饭碗。我认识好几个画插画的,现在都把多模态当免费助手用。你想画一个老门东下雪的街角,跟模型说清楚要求,它几分钟出十张参考草稿,你挑合适的改改就行,省了你自己找素材拼构图的时间,原来一天出一张稿,现在能出三张,赚的更多了,哪来的被抢?
不过话说回来,也不是完全没冲击,那种只会拼素材抄参考的低端活,确实没人找了,优胜劣汰而已,哪行不是这样?
我看到的趋势,没大家吹得那么玄乎
 我看到的趋势,没大家吹得那么玄乎
现在到处都是“多模态是下一代人机交互”“多模态带来通用人工智能”这种口号,听着吓死人。我反而觉得,多模态最后会变成水和电,根本没人天天提它。
就像你现在用手机输入法,它背后也是深度学习模型,你会天天把“我在用深度学习输入法”挂嘴边吗?不会。你只会觉得,输入法就应该能纠错,就应该能猜你想打什么,本来就是这样。
以后多模态也一样。你拍个菜,说“帮我记下来这个菜的热量,我今天减肥”,它直接给你算好存进笔记;你给爷爷奶奶发一张你新家的图,他们点一下说“这个阳台多大,能放我那盆兰花吗”,它直接算好尺寸给回答,没人会说“哇这就是多模态大模型”,只会觉得手机本来就该这么用。
当然,问题也不少。现在拍个糊一点的图,说一半留一半的话,它经常理解错意思,离谱的时候能给你答得驴唇不对马嘴。还有版权的事儿,训练用的那些图啊文啊,很多都没说清楚授权,哪天出个大官司,整个行业都得变。
这些坎没跨过去之前,吹什么颠覆都是瞎扯。
但是你不能不承认,它确实把AI往“像人一样跟你交流”的方向推了一步。原来你跟AI说话,得按着它的规则来,它要什么你给什么,现在反过来了,它按着你的规则来,你想怎么说就怎么说,想发图就发图,想随口说就随口说,这不就是我们本来想要的AI吗?
那天喝完咖啡走在路上,朋友说,其实多模态没什么黑科技,就是攒了好多年的技术,突然就通了。我想想也是,哪那么多从天而降的革命,都是一点点改,一点点补,补着补着,就变了样。
对吧?
免责声明:市场有风险,选择需谨慎!此文仅供参考,不作买卖依据。如有侵权请联系删除。
文章名称:咖啡店试玩多模态大模型:原来我们都理解错了它
文章链接:https://www.lfdjt.com/p/keji/a/8298.html