昨天在南京珠江路巷口的社区咖啡店蹭网,对面坐了两个计算机系的学生,凑着电脑屏幕小声嘀咕。一个说“我投了好几家机器学习岗的实习,连面试通知都没有”,另一个说“这不正常吗,现在招机器学习的,都要会调大模型对吧?”我捧着冰美式抿了一口,差点笑喷。
你天天用的服务,早就藏着机器学习了
很多人觉得机器学习是实验室里飘着的黑科技,只有大公司的天才研究员才碰得到。真不是。你昨天扫的共享充电宝,你点外卖给你推的商家,你刷短视频给你选的内容,全都是机器学习在后台干活。
说实话我之前帮一个做共享设备的朋友梳理过他们的点位逻辑。早年他们铺点位,全靠区域经理拍脑袋,觉得商圈人流大就多放,结果周末漫展开展,半个下午全借空了,眼睁睁赚不到钱。冷门的写字楼角落,堆了二十台,放半个月都动不了几个,运维成本堆得吓人。
现在呢?
把过去半年的每日人流、天气、周边活动、工作日周末的数据全部喂进去,模型自己会找规律,哪天哪个点会有多少人借,需要备多少台,算得比十年经验的区域经理还准。错峰补货的成本直接降了三成,空柜率掉了快一半。
这就是机器学习。说白了,就是机器帮你在一大堆乱七八糟的数据里,找出来你要的规律。不用你自己一条一条写规则,你给够例子,它自己学。
对门卖卤菜的阿姨现在都在用。她开了十年店,原来每天备多少菜全靠感觉,遇到下雨周末经常剩一大堆,天热的时候只能倒掉。现在她用了个小程序,把过去大半年每天的销量、天气、星期几输进去,小程序每天给她报个备菜量,剩菜比原来少了快七成。你说这算不算机器学习?当然算。
别迷信“全能模型”,好用的机器学习都是偏科生
最近两年大模型火了,好多人说起机器学习,开口就是千亿参数,通用人工智能,好像参数不够大就不配叫机器学习。
我上个月跟一个做医疗AI的医生聊天,他给我吐槽了个真事。他们医院想做一个眼底照片筛查糖尿病的辅助模型,本来找了个团队,用专门针对医疗影像训练的小模型,准确率已经到了96%,完全满足临床辅助的需求。结果院领导听了大模型的发布会,非要换成一个千亿参数的通用大模型,说“够先进,够大”。
结果呢?换完之后准确率直接掉到了91%,掉了五个点。为啥?
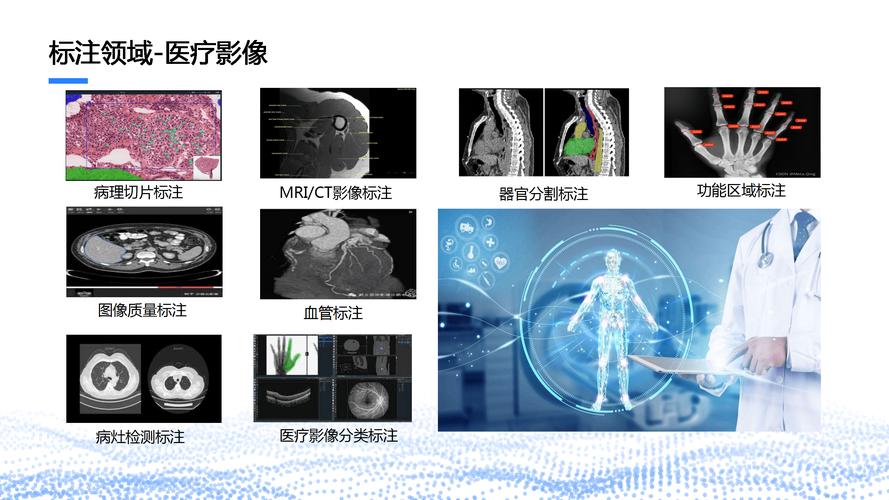
通用大模型什么都学,从猫脸狗脸到论文歌词,什么特征都往里塞,真正对糖尿病病变有用的细微血管特征,反而被一大堆没用的特征给盖住了。那个专门训练的小模型呢?它这辈子就只学眼底照里的病变特征,偏科偏到了姥姥家,但是干活就是准,成本还只有大模型的百分之一。
好多人对机器学习有个最大的误区,觉得越全能越牛。其实现在真正落地赚钱、给普通人方便的,百分之九十都是这种偏科的小模型。你手机里的人脸解锁,就只学人脸的特征,你让它认你家的猫,它肯定认不出来。导航软件算路线的模型,就只学路况和时间的关系,你让它给你写情书,它肯定写不出来。
这一点都不丢人。本来机器学习就是来解决具体问题的,不是来当神仙的。对吧?
普通人想学机器学习,先避开这几个坑
好多刚接触的新手,上来就踩坑。我见过最多的就是两种。
一种是上来就啃厚厚的教材,从线性代数啃到概率论,啃了半年,公式背得滚瓜烂熟,连个最简单的分类程序都跑不起来。问他为啥不跑,说“我还没把基础学完呢”。
还有一种就是被培训班割韭菜,上来就学调参,三个月跑了十几个开源项目,全都是拿别人现成的模型改改参数,跑个准确率就完事了。问他为啥这个参数比那个参数效果好,说不上来。找工作的时候,面试官稍微问深一点,直接露馅。
说实话,机器学习根本没那么玄乎。你要是感兴趣,根本不用花大几万报班,也不用啃完三大本厚书再动手。找个公开的小数据集,找个入门教程,自己跑一遍,比什么都强。比如那个经典的泰坦尼克号生还预测,一千多条数据,你喂进去,跑一遍,马上就能明白,哦原来机器就是这么从已有数据里找规律,预测新结果的。
不过话说回来,很多人说,现在大模型都出来了,普通人学机器学习还有用吗?怎么没用?大模型也是机器学习的一种啊。就算你不想做这行,搞懂了机器学习到底是怎么回事,你就不会被网上那些“AI要取代所有人”的鬼话吓到,也不会被那些七天学会年薪几十万的骗局割韭菜。
它就是个工具。和你家厨房的切菜刀,办公室的打印机,没什么区别。切菜刀就是用来切菜的,你不能要求它给你洗衣服,打印机就是用来打文件的,你不能要求它给你做饭。机器学习也是一样,解决具体问题,帮人省点时间省点力气,就已经完成任务了。
那天临走的时候,我听见那个找实习的学生说,“早知道这样,我就不天天盯着大模型背参数了,原来他们要的是会解决具体问题的啊”。
我隔着桌子笑了笑。没好意思说,可不就是这样嘛。
作者|科技
排版|科技
审核|白杨