上周六,0923,南京刚入秋,下过一场小雨。我跟着朋友躲进新街口的超市避凉,他掏出来一台还没发布的开发机,说给我试个新东西。
我随便站在晴王葡萄的货架边,他举手机给我拍了张照,随口对着手机说:帮我把背景换成门口的梧桐落叶,再说说这套穿搭适合去哪约会。
三秒钟,手机直接出了图,还蹦出来一行字:卡其色风衣配直筒裤偏休闲,换梧桐落叶背景偏文艺感,适合去颐和路看老洋房或者玄武湖划船,记得带杯热拿铁。
我当时鸡皮疙瘩都起来了。这不是那种你输文字再生成图的老玩法,它真的看懂了图里的我,听懂了我朋友没说出口的需求,还把两样东西揉到了一块给答案。
这就是现在吵得很热的多模态大模型,但绝大多数人都还没真的摸过用过。
不是图文拼一块,是真的存在同一个“脑子”里
很多人对多模态的理解,就是能同时处理文字和图片嘛,有啥稀奇的。
不对。
之前我们用的大部分AI,都是分科的。OCR模型管识字,文生图管画图,语音模型管听说话,各干各的,就像公司里不同部门的人,你要办个业务,得跑市场部签字再跑财务部盖章,最后拼起来给你,慢不说,还经常对不上信息。
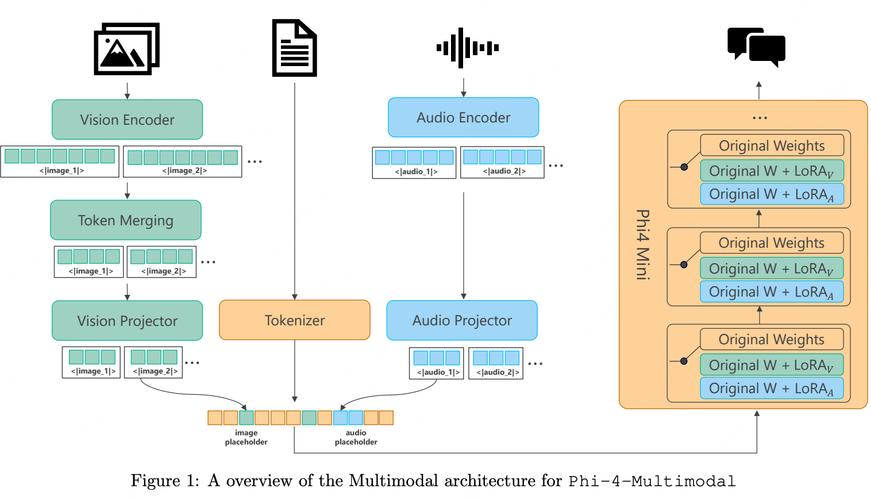
原生多模态大模型不一样。它从训练开始,就是把文字、图片、声音、甚至视频所有信息,都放在同一个“知识抽屉”里存着。就像我们自己的脑子,你看到苹果,脑子里同时会跳出“甜”“红色”“牛顿”“手机logo”这些所有相关的信息,不用翻不同的本子找。
说个能懂的例子。你拿一张挤在人群里的演唱会合照,问它:戴红色鸭舌帽那个女生手里举的灯牌上写的什么字。
以前的拼接AI,先找人,再找灯牌,再识字,灯牌歪一点糊一点,直接识别成乱七八糟的字。真的多模态,它知道红色鸭舌帽是你要找的人,知道灯牌在她手上,哪怕字糊了一半,它能结合演唱会的主题、常见的应援词,顺出来正确的内容,差不了太多。
别被商家骗了,九成带图文的AI都不是真多模态
说实话,现在这股风里,浑水摸鱼的太多了。
好多厂家把原来的OCR模型加文生图模型拼个APP壳,就敢叫自己多模态大模型,割不懂行的普通人的韭菜。
怎么分辨?很简单,你考它一个需要跨信息拼的问题就完了。
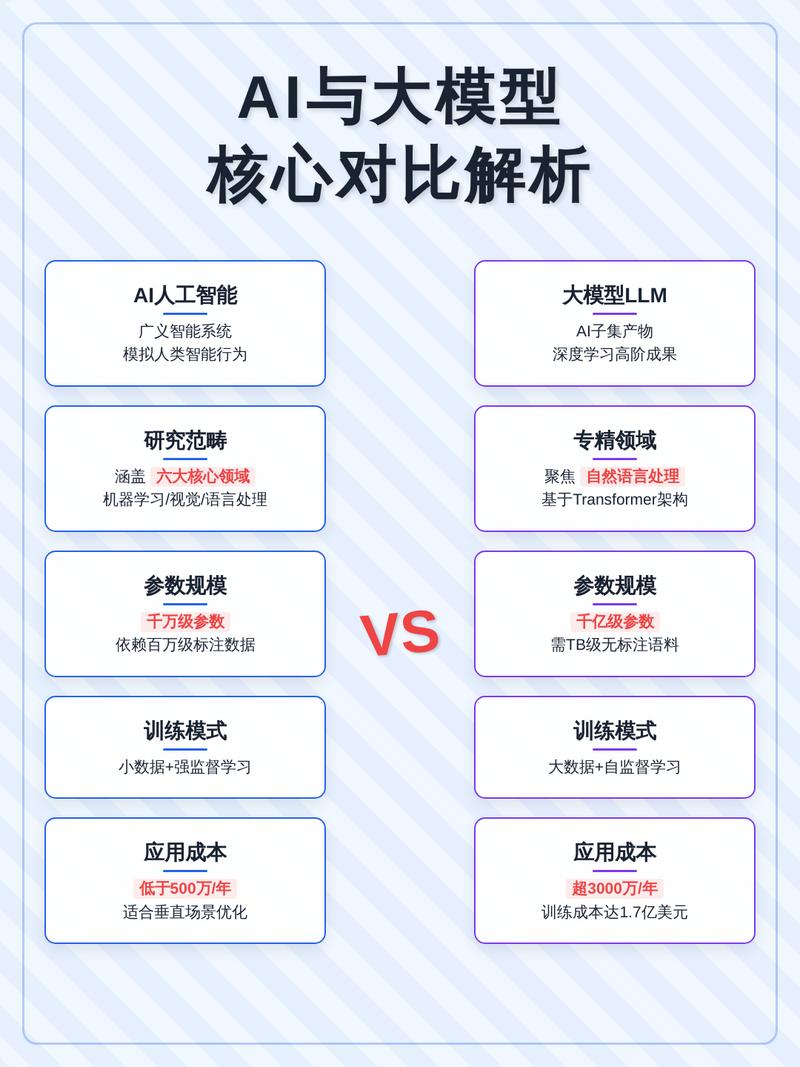
你就拿一张你自己书桌的照片,问它:帮我数一下桌子上能用来写东西的道具有几个,分别是什么。
拼接AI大概率会错,它要么把你的笔记本漏了,要么把装笔的笔筒当成笔算进去,因为它认东西是一个一个认的,不会结合问题把信息串起来。真的多模态,能听懂“能用来写东西”这个要求,会排除没用的东西,给你数清楚。
我那天在超市就试了,拿一包包装模糊的鸭肫干,问它:这个保质期多少天,成分里有没有加蔗糖。它看了两秒,直接给我报对了数字,还说“配料表里写的是麦芽糖浆,没有额外加蔗糖,但碳水含量不低,一次别吃太多”。
换那种拼出来的AI,早就卡壳了。
不用等十年,明年你的手机就会全是它
很多人说,多模态是未来十年的技术,和现在的我们没关系。
错。我摸过实机我敢说,再过半年,你买的新手机,基本都会带上端侧多模态大模型,就是不用联网,不用传你的照片到云端,本地就能跑,打开就能用。
到时候你会发现,很多原来麻烦的事,会变得特别简单。
你去博物馆玩,不用对着文物扫半天二维码找讲解,你直接举手机拍一下,问它“这个东西是用来干嘛的,有什么故事”,它直接给你说,你想听八卦它还给你讲野史。
你整理旧照片,不用翻半天找你要的那张,你直接对着相册说“找出来我前年夏天在海边穿白裙子拍的照片”,它一秒给你筛出来,不用你一张一张翻。
你孩子写作业,不会做的几何题,把题目和图一起拍进去,问它“这个辅助线要怎么画”,它能看懂图也能看懂题,直接给你讲明白,不用你手动输入题目。
不过话说回来,它也不是完美的。我那天试的时候,拿了一张我很多年前拍的老南京城门的照片,问它这是哪个门,它认错了,把中华门说成了挹江门,毕竟老照片太模糊,信息太少,它也会错。
还有人说,多模态出来以后,做设计做内容的都要失业了?我倒不觉得。它就是个帮你省力气的工具,原来你要找图找半天,再改半天文案,现在它给你出个初稿,你改改调调就行了,把时间省下来做更有意思的创作,不好吗?
昨天翻朋友圈,看到那个做开发的朋友发了一张用多模态改的图,他周末去中山陵拍的梧桐,原本阴雨天的灰调子,改成了暖金色的入秋效果,配文就是“南京的秋天真的来了”。挺自然的,一点没有之前AI出图那种假假的塑料感。
原来真正的新技术,从来都不是喊出来的,就是这样,悄悄跑到你身边,帮你把不起眼的小事,变舒服一点而已。
作者|科技
排版|科技
审核|小北