 大讲堂
你拍了一张冰箱内部的照片。乱。鸡蛋、半盒豆腐、两根蔫葱,还有一罐没开封的豆瓣酱。你问:今晚能做什么?它回:葱烧豆腐、蒸蛋,豆瓣酱可以炒个肉末。你愣了一下。它怎么知道的?
这事背后,站着一个被聊烂了但很少被讲清楚的角色:多模态大模型。它不神秘。也不像科幻片里那种“有眼睛的脑子”。更像一个翻译官,把看到的、听到的、读到的,全部塞进同一套语言里。
先别急着说“它看懂了”
“看懂”这个词太滑了。人看冰箱,知道鸡蛋不能放冷冻,知道葱蔫了还能用。模型看冰箱,先做的是把图像切块。对,切块。一张图被切成很多小方块,每个方块变成一个向量。这个过程叫 patch embedding。挺粗暴的。但有效。
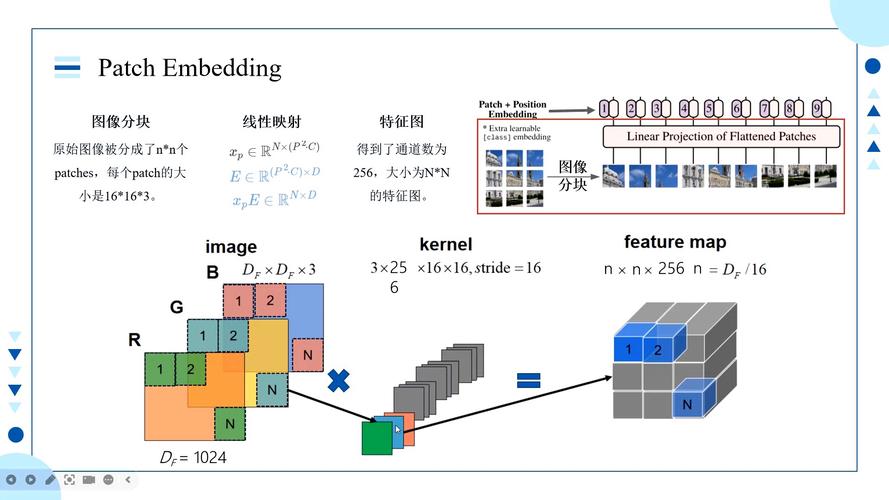
然后呢?这些视觉向量要经过一个投影层,翻译成语言模型能吃的 token。注意,不是直接翻译成“鸡蛋”这个词。而是变成一串数字,和文本 token 混在一起。模型接着做它拿手的事:预测下一个词。它看到图像特征,看到你问“做什么菜”,然后一个词一个词往外蹦。
所以它“看”到的,其实是一堆压缩过的特征。细节丢了不少。你图里冰箱门上贴的便签,它可能完全没注意。它盯着鸡蛋和葱,是因为训练数据里这类图文对很多。对吧,数据决定注意力。
一张图,怎么变成一句话?
把流程拆开,没那么玄。图像进视觉编码器,比如 ViT 或者类似结构。文本进 tokenizer。两边各自变成向量序列。中间有个对齐模块,名字五花八门:投影层、Q-Former、适配器。说白了,就是让图像向量和文本向量待在同一个语义空间里。
对齐怎么练?拿海量图文对。图配文,文配图。对比学习拉近匹配的,推开不匹配的。CLIP 当年就是这么干的。但它主要做理解,不负责生成。后来大家发现,把视觉特征喂给大语言模型,也能让它写描述、答问题、甚至编菜谱。于是多模态大模型就长成了现在这样。

音频也类似。声音切成频谱图,再编码。视频多一个时间维度,麻烦成倍增加。你让模型看一段十分钟的做饭视频,它不可能记住每一帧。它只能采样。抽几帧,或者把时间压成特征。所以你要问“视频里三分钟那儿他放了几勺盐”,它大概率懵。
说实话,很多演示视频剪得漂亮,只展示成功案例。真实场景里,反光、遮挡、手抖、方言口音,全是坑。模型不是不能处理,是处理得不够稳。
误区比能力更值得聊
有个误区:多模态大模型等于全知全能。差得远。它可能认得图里的猫,但数不清猫有几根胡须。它可能读出海报上的字,但把年份认错。它可能根据 X 光片说“疑似肺炎”,但那不是诊断,是概率游戏。
另一个误区:参数越大越厉害。不一定。数据干净、对齐策略、指令微调,这些影响很大。有些小模型在特定任务上跑得挺欢。端侧部署还要考虑内存和耗电。你手机跑一个多模态模型,发热掉电,体验直接崩。
还有个误区:它像人一样有常识。它的常识来自文本统计。文本里说“鸡蛋不能冷冻”,它可能知道。但你家冰箱门没关,它看不出来。它没有身体,没有触觉,没有真正的因果模型。
隐藏误区:以为多模态就是“图像+文本”。音频、视频、传感器数据、3D 点云,都是模态。多模态大模型只是其中一种统合方式。不是唯一答案。
问答:那些被问烂的问题
问:它和 Sora 那种视频生成模型什么关系?
都是多模态方向。但目标不同。一个偏向理解,一个偏向生成。理解模型要回答“这是什么”,生成模型要回答“接下来该出现什么”。训练目标、数据管线、评估方式,差别很大。别混为一谈。
问:为什么它数不清图里有几个苹果?
视觉 token 被压缩了。注意力还会分散。训练时也没人拿计数题狠狠罚它。它更擅长描述大致场景,不擅长精确计数。你硬要它数,它可能一本正经胡说八道。
问:能本地跑吗?
能。但小模型精度会掉。量化之后可能更明显。如果你的场景简单,比如识别发票、读仪表盘,本地小模型够用。如果要复杂推理,还是得靠云端大模型。代价是延迟、隐私、费用。
问:会取代设计师吗?
会改变工作流。草图、文案、参考图,可以来回迭代。但审美判断、客户沟通、版权风险,还是人的事。工具变强了,人的责任没变轻。
时间线?不,是几股浪叠在一起

早期有图像描述、视觉问答。模型看图说话,磕磕绊绊。后来 CLIP 把图文对齐做扎实了。再后来,大语言模型火了,大家把视觉编码器接上去,发现效果不错。GPT-4V、LLaVA、Qwen-VL 这些名字,你可能听过。开源社区卷得厉害。
但它不是突然蹦出来的。算力堆上去了。数据多了。Transformer 架构能扩展。指令微调让模型听得懂人话。几股浪叠在一起,才推到现在这个位置。
冷思考几句。评测很难。文本有 MMLU,多模态有 MMMU 之类。但榜单会过拟合。真实世界没有标准答案。模糊、遮挡、方言、反光,都是考题。数据版权和隐私也是雷。训练能耗不小。端云协同可能是折中方案。
回到冰箱。模型给你菜谱,你还是要自己开火。它可能把老抽当成生抽,把火候说得含糊。你得盯着锅。多模态大模型是一把很奇妙的瑞士军刀。但刀柄在谁手里?你。
作者|科技
排版|科技
审核|小北