我在后面听着,没插嘴。其实很多人对这玩意都是这个印象,要么觉得神得不得了,能统治人类,要么觉得就是一堆资源堆出来的骗局,没啥真东西。
今天就掰扯掰扯,说点普通人能听懂的实话。
原来大模型不是”算答案”,是猜下一个字
你有没有发现,你用任何大模型聊天,它都是一个字一个字往外蹦,不是一下子把整段话都给你?很多人以为这是网络延迟,或者故意做出来的效果,其实不是。这就是大模型算法最核心的本质。
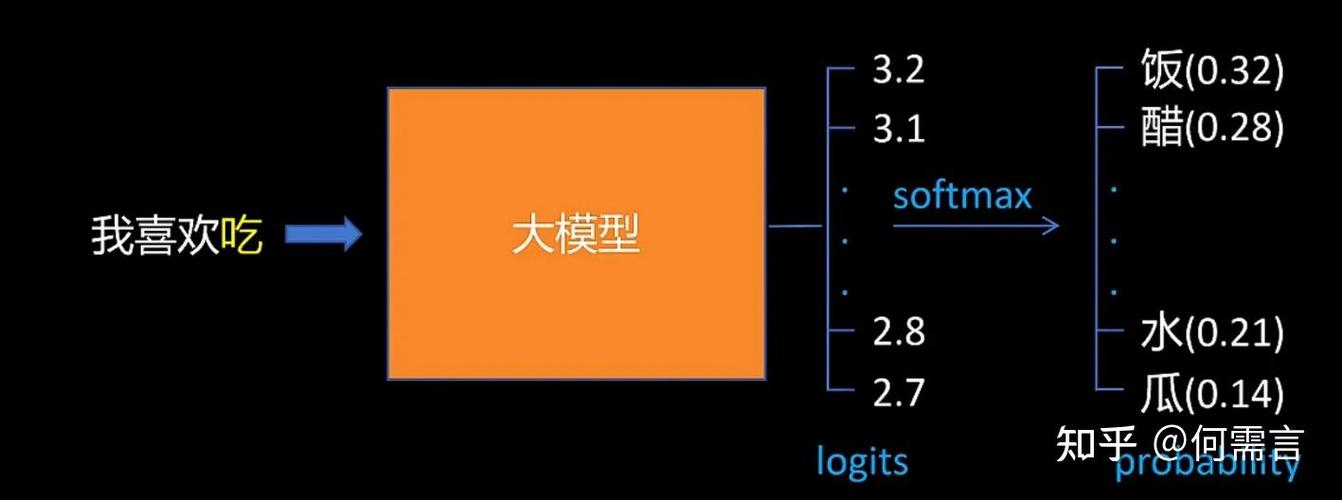
它从一开始就没打算”算”出一个完整的答案给你。它每输出一个字,都只干一件事:根据你前面输入的所有文字,加上它已经输出的所有文字,算出来「下一个位置,哪个字出现的概率最高」。
概率最高的那个,就是它输出给你的字。输出完这个字,再拿着整段新的文字,重复算一遍下一个字的概率,循环往复,直到它算出来”这里应该结束了”,才停下。
举个最直白的例子,你给它输入”床前明月”,它一算,整个互联网上的文字里,”床前明月”后面接”光”的概率超过90%,它就先出个”光”。出完”光”,变成”床前明月光”,再算下一个,概率最高的是”疑是”,就出”疑是”,以此类推。
就这么简单。
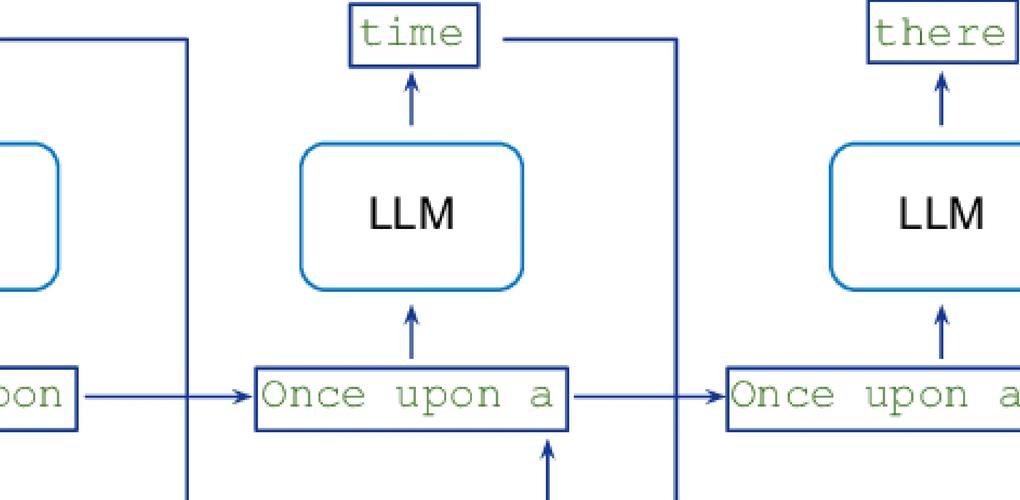
是不是和你想的不一样?你之前是不是以为大模型会先在脑子里把整段话构思好,再慢慢吐出来?其实真不是,它就是一步一步,猜着往前走。
你听说的”大模型训练”,本质就是给大模型做选择题
那大模型怎么就知道哪个字概率高呢?都是训练出来的。很多人听”训练”两个字,觉得是什么特别高深的黑科技,其实过程说穿了,和你上学的时候做选择题刷题没区别。
刚初始化的大模型,就是一堆随机的参数,说白了就是什么都不懂的傻子,你给它”床前明月”,它随机瞎猜,可能给你出个”床前明月吃”,啥玩意儿不是。
训练的时候,我们就给它喂海量的人类文字,从新闻到论文,从小说到聊天记录,什么都有。每喂一句话,我们把其中几个字挡住,让它选,挡住的位置应该是哪个字。
选对了,我们就调整它的内部参数,让它下次选对的概率变得更高。选错了,就调整参数,让它下次选错的概率变低。
一遍一遍,几千万次,几亿次,几十亿次的刷,刷完整个互联网上能找到的公开文字,它就慢慢摸出人类说话写字的规律了。哪两个字经常搭,哪句话开头之后经常接什么内容,门儿清。
说实话,这个过程真没有某些自媒体吹的那么玄乎。什么”突然诞生自我意识”,哪那么容易。它就是把人类文字里的关联规律,全都记到自己的参数里了而已。
不过话说回来,规律摸到这个程度,已经足够好用了。你让它写个周报,写个文案,回答个常识问题,它猜出来的下一个字连起来,就是通顺能用的内容,足够帮我们省很多时间。
很多人都跳不出来的误区:大模型算法不是参数越大越厉害
好像参数堆得越多,算法就越厉害。真不是这么回事。
我之前接触过几个创业团队做的行业大模型,张嘴就是我们有百亿参数,比这个比那个强,结果我拿他们行业里一个常见的问题去问,回答得颠三倒四,连基本的常识都错。
为啥?训练的数据都是乱凑的,脏得一塌糊涂,很多内容都是错的,它学出来的规律就是错的,参数再大又有什么用?它猜出来的下一个字,当然也是错的。
还有更过分的,拿开源的大模型,改了改最外面一层输出,拿点行业数据微调了两下,就敢说自己是全新自研的大模型算法,参数百亿,纯纯割投资人韭菜的。
当然我也不是说参数大没用。要处理很长的文档,要同时理解文字和图片视频,参数大确实能装下更多信息,能捕捉到更细微的规律。但核心从来不是参数的大小,是算法的逻辑能不能让它真的把学到的规律用对。
比如当年Transformer出来,为什么一下子把之前的算法干趴下了?核心就是那个注意力机制,解决了老算法记不住长句子里前面内容的问题,能分清楚”哪些内容对现在要猜的字更重要”,原来老算法写长文章写到后面就忘了开头说啥,现在不会了,这才是大模型能起来的核心。不是堆参数堆出来的,是算法逻辑对了。
现在很多人聊大模型,要么捧上天,要么踩下地,其实没必要。你想明白了它算法的本质就是猜下一个字,就知道它能干啥不能干啥。
它会编瞎话,也就是大家说的幻觉,本质就是它只要概率对,不管事实对不对,当然会瞎编。它能帮你整理信息,帮你写初稿,帮你省时间,但做不了真正的原创创新,因为所有的内容都是从人类已有的文字里学来的规律,跳不出这个框。
它是个特别好用的工具,真的改变了我们干活的方式,但它不是魔法,也不是洪水猛兽。
那天买完奶茶,我听见那个学生说,”要是大模型能帮我写选修课论文就好了”,我笑了笑,没说什么。其实啊,它能帮你敲完所有字,但真正的思考,还得是你自己来。
作者|科技
排版|科技
审核|白杨