2026-09-29 01:59:00
作者:
科技
上周六在南京新街口的咖啡厅赶稿,邻座坐了两个穿校服的学生,凑在一起聊AI画图,其中一个突然问:“你说大模型算法到底是个啥?为什么它能画出我脑子里想不出来的图?”
我握着咖啡杯差点笑出来。这个问题,我问过三个做算法的博士,得到的答案一个比一个绕,最后还是撸串的时候那个喝醉的博士说的最明白。
别背百科定义,大模型算法就是会“猜”的疯子
你有没有在输入法里打过半句话?比如你打“今天下班去”,输入法会给你推“吃火锅”,大概率猜的还挺准,对不对?
大模型算法本质上干的就是这个事儿。只不过它猜的范围更大,不只是下一个词,还能猜下一个像素,下一个音符。见过几千万几亿篇文本之后,它摸清楚了文字和文字之间的概率关联,知道哪句话接哪句话最合理。
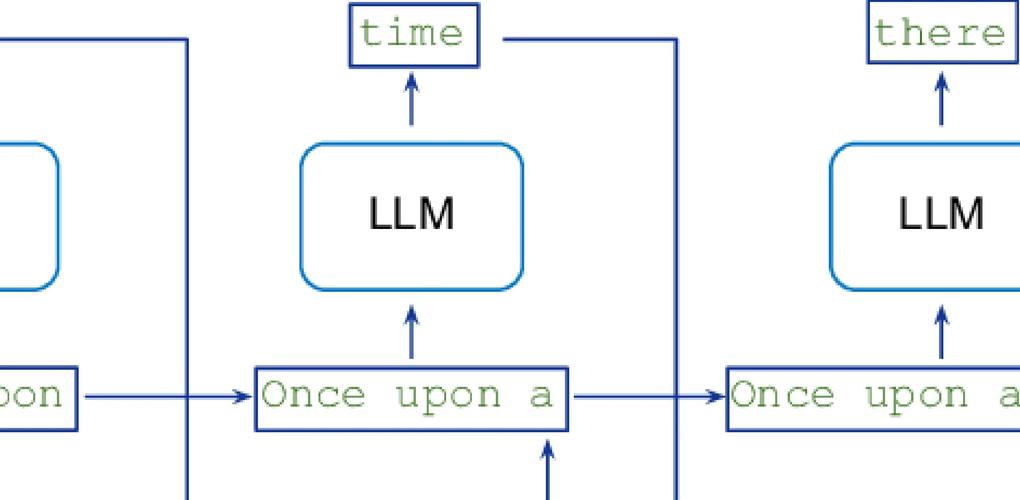 大模型自回归预测下一个词示意图
很多营销文把它吹得像开了灵智,什么“拥有自主思考能力”,扯。去年跟算法朋友撸串,他啃着烤筋给我说,现在顶流的大模型,核心框架还是十几年前Google提出来的Transformer,根本不是什么天顶星黑科技。
无非是现在有钱,能堆更多参数,喂更多数据,把猜概率的准确率磨得越来越高罢了。高到什么程度?你给它一个开头,它能顺着给你写一本逻辑通顺的小说,能给你写出能运行的代码,换谁第一次用不得吓一跳?
参数堆得越多越厉害?算法里藏着偷懒的小聪明
说实话,现在圈里歪风邪气很重,一开口就是我家大模型多少亿参数,多少万亿训练数据,好像参数多就一定厉害。
其实大模型算法早就学会“偷懒”了,哪用得上所有参数一起干活?就像你去超市买东西,不会把整个超市的货架都背一遍,只需要记住你要买的东西放在哪就行。大模型的稀疏激活就是这个逻辑,你问它一个问题,它只唤醒跟这个问题相关的一小部分参数,剩下的都在摸鱼。
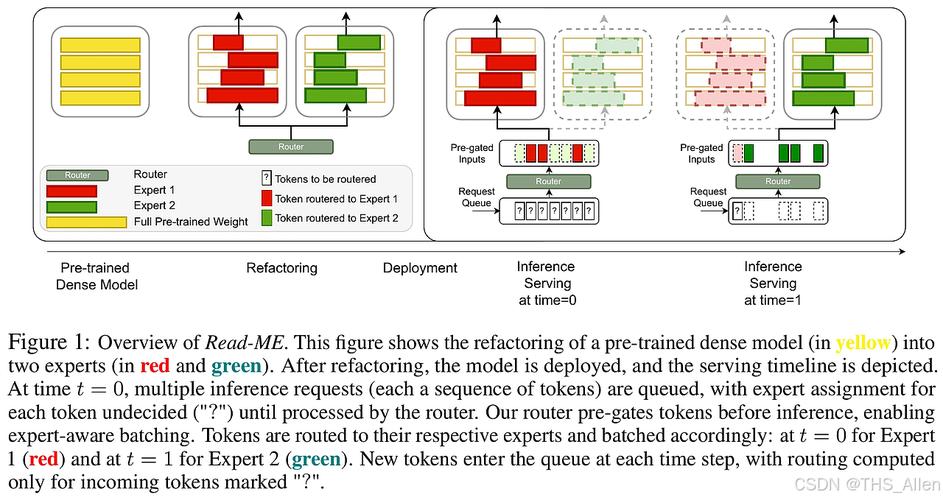 大模型稀疏激活原理示意图
我之前帮一个做ToB的朋友测试模型,同样的问题,拿7B参数的小模型和13B参数的大模型测,日常写方案、找问题,普通用户根本分不出差别。那些喊着千亿参数的,大部分时候你用起来,激活的参数还不到十分之一。说白了,堆参数就是营销话术,割投资人的钱罢了。
当然,也不是说参数没用,参数多了见多识广,处理复杂问题确实更稳,但对普通用户来说,真的没必要追那个数字。
大模型算法现在卡在哪?圈内人都不说透的事儿
 大模型算法现在卡在哪?圈内人都不说透的事儿
说出来你可能不信,现在大模型算法最大的痛点,还是老问题:幻觉。什么是幻觉?就是它一本正经的跟你胡说八道。我上次让它查一下“南京长江大桥哪年建成的”,它说1972年,错的离谱,而且说的斩钉截铁,比真的还像真的。
为什么会这样?回到最开始的本质,它就是猜下一个词,只要上下文通顺,它才不管内容对不对。遇到它没见过的知识,它就顺着语气猜一个最合理的,错了也不知道。
现在算法圈都在想办法解决这个问题,最主流的思路不是堆更多参数,是把大模型和检索绑在一起,回答之前先去可信的知识库搜一遍,把搜到的真实内容塞给它当参考,它再组织语言,这样错的概率就低多了。
还有一个不能说的秘密,就是成本。训练一次大模型,耗的电够一个小县城用一个月,电费就是好几千万,后续微调、部署,每一步都烧钱。现在好多创业团队,上来就是要训千亿大模型,拉了好几亿投资,连具体要解决什么用户问题都没想清楚,就是蹭风口,最后钱烧完了,留下一堆没人用的模型权重,一地鸡毛。
不过话说回来,大模型算法的进步真的改变了很多普通人的生活。我小姨父是做建筑设计的,之前甲方改一次图纸,他要带着团队重画三天,现在把要求丢给大模型,半天就能出初稿,剩下的时间他就在家楼下钓鲫鱼,接孙子放学,这是实实在在的好处。
我上次让大模型帮我写一个给我妈用的智能手机操作指南,它写的比我写的还贴心,把字体调大,步骤拆的细,连怎么连wifi都写得清清楚楚,我妈学了一上午就会用视频号了。你说,这不好吗?
别把大模型算法当洪水猛兽,也别把它当无所不能的魔法。它就是一个被数据喂大的超级猜题家,会干很多我们以前不想干的脏活累活,也会犯很低级的错误。
昨天路过南大校门,看见校园里摆了大模型算法的分享展架,好多学生围着看,我在门口买了一块热乎的梅花糕,咬一口糖流得满手都是,突然想明白,不管算法多复杂,最终还是要服务于人,省下来的时间,本来就是要用来吃梅花糕、钓鱼、陪家人的啊。
免责声明:市场有风险,选择需谨慎!此文仅供参考,不作买卖依据。如有侵权请联系删除。
文章名称:咖啡厅漫谈:大模型算法到底在“算”什么
文章链接:https://www.lfdjt.com/p/keji/a/4370.html