2026-09-26 10:23:51 分类:正文
上周去南京夫子庙逛,路边蹭到两个大学生聊AI,说现在的大模型都用上强化学习对齐了,听起来不明觉厉。其中一个说,强化学习不就是AI自己跟自己下棋吗?能有啥用在我们身上?
我当时在旁边买梅花糕,差点笑出来。其实你我每天都在玩强化学习,只是自己没察觉而已。
别被术语吓住,核心就是试错拿反馈
很多科普一上来就搬定义,全是八股,看着就累。换个普通人能懂的说法。
你小时候学走路,是不是摔了几次就知道哪条腿该先迈,重心该放哪?
摔了疼,这就是给你的负反馈。走成了没摔,能扑到妈妈怀里拿糖吃,这就是正奖励。整个过程没有老师给你写板书讲公式,全靠你自己一遍一遍试,对了就多做,错了就改,这就是强化学习。
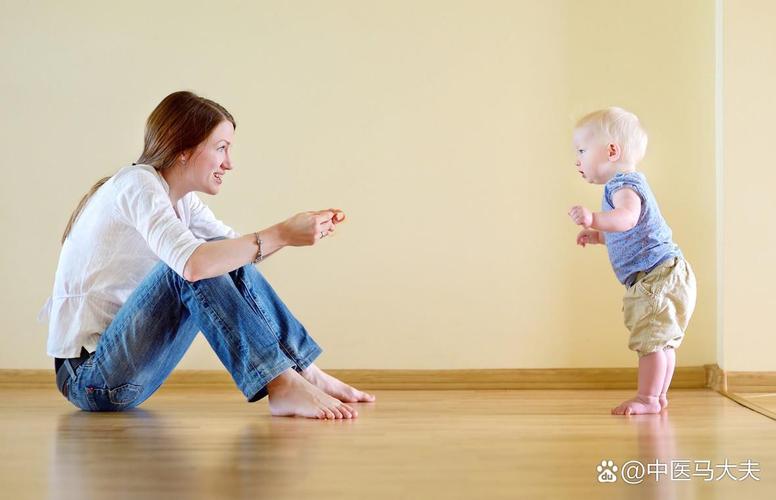 婴儿学走路试错行为分解图
很多人觉得这是AI时代才冒出来的新东西,不对。几十年前的程序员就开始玩这套逻辑了,只不过那时候算力不够,跑不起来复杂的任务,才没闹出太大动静。现在显卡够好了,能支撑百万次甚至上亿次试错,才把这个老逻辑玩出了新花样。
能赢围棋冠军,为什么搞不定日常跑腿?
AlphaGo赢李世石那回,所有人都在吹强化学习神了。那你有没有想过,为什么直到现在,外卖平台的路径规划,还不如跑了两年的骑手自己选的路顺?
核心区别在规则的确定性。
围棋的规则是死的。19路棋盘,361个落子点,赢就是赢,输就是输,每一步走了之后,能拿到多少奖励,算的清清楚楚。AI可以自己跟自己对弈几百万局,把所有可能的走法试个遍,慢慢就能摸到胜率最高的那一套思路。
但是送外卖不一样。今天新街口地铁口封了办漫展,明天中山东路挖管线改下水道,后天顾客临时改地址,路上还可能碰见洒水车溅一身水,所有情况都是变的,根本没有固定的规则给你反复试错。哪怕你试了一百万次,下一次碰到的情况还是全新的。所以强化学习在这种完全不确定的场景里,根本发挥不出优势。
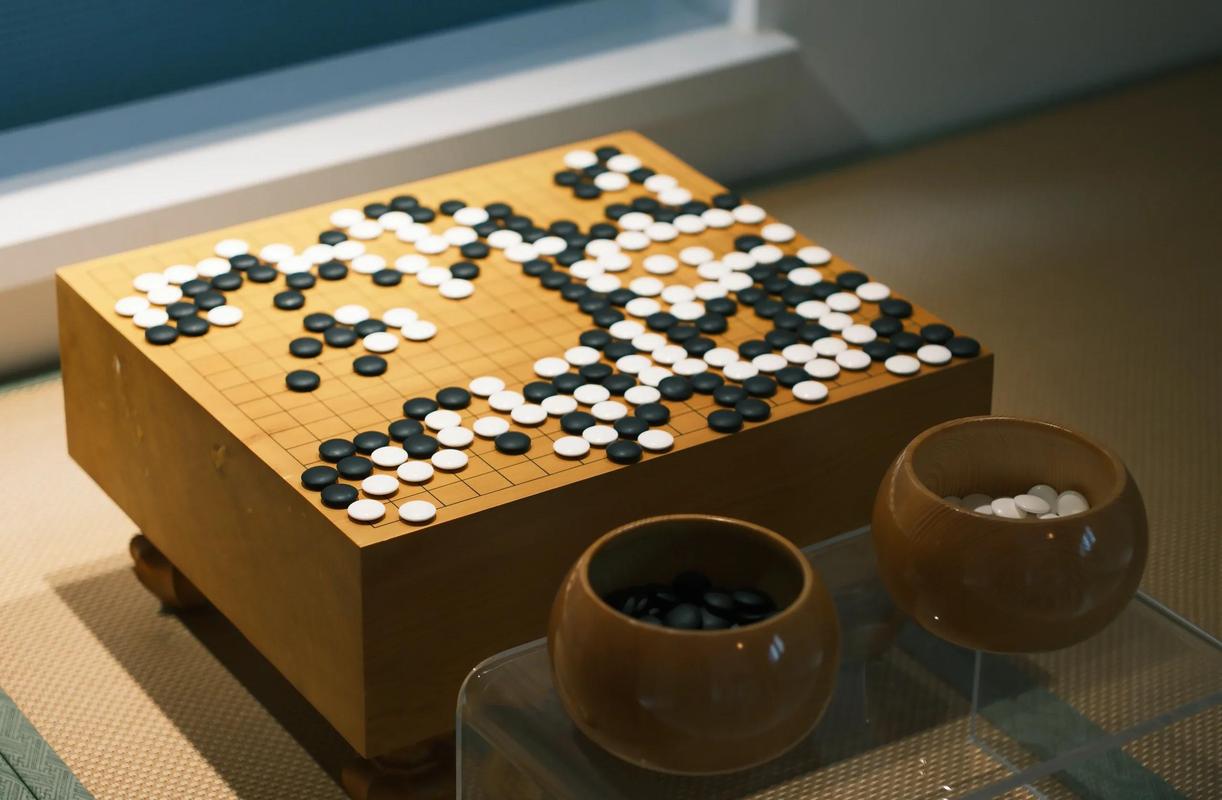 AlphaGo强化学习围棋对局决策示意图
还有一个常见误区,很多人把深度强化学习直接等于强化学习,不对。深度强化学习是用深度学习处理图像文本这类复杂的感知输入,再加强化学习做决策,说白了是两个技术的结合,强化学习本身的核心,还是那五个字:试错拿奖励。
普通人怎么把强化学习的逻辑用在自己身上?
 普通人怎么把强化学习的逻辑用在自己身上?
说实话,我最近半年调整状态,就是用的这套思路。没搞什么复杂的年度计划,也没逼自己每天必须完成多少KPI。我给自己设了个极简单的奖励规则:当天完成了定下的两件核心事,就奖励自己玩一个小时开放世界游戏,没完成,就当天不能刷短视频。
一开始当然经常破戒,半个月下来,我就慢慢找到能让我舒服又能推进事情的节奏,不像之前做完美计划,半个月就坚持不下去放弃了,对吧?
投找工作投简历也是一样。你投了十份出去,发现投某一类岗位的回复率是另一类的三倍,你自然就会调整方向,多投这类岗位,这不就是你自己在做强化学习?整个过程没人教你,全靠你自己试错拿反馈,慢慢摸到最优方向。
不过话说回来,我也不吹这套逻辑万能。比如你选大学专业,试错成本太高了,总不可能读四年不行换一个,试个四五次吧?这种时候,还是得多问过来人,多查真实信息,不能全靠自己瞎试。
强化学习本来就适合试错成本低、能反复调整的事,搞清楚这个边界,才不会走歪。
昨天刷短视频,看见有人用强化学习训练AI打植物大战僵尸,AI居然自己悟出了留一个僵尸不杀,攒够阳光再摆完所有防御阵容的套路,比很多人类玩家玩的还溜。
你看,不管是AI还是普通人,本质上都是这么回事。找对属于自己的正反馈,慢慢试,错了就调,总会摸到属于自己的门道。
免责声明:市场有风险,选择需谨慎!此文仅供参考,不作买卖依据。如有侵权请联系删除。
文章名称:强化学习:你天天在用的决策逻辑,比你想的更接地气
文章链接:https://www.lfdjt.com/p/keji/a/3264.html