 大讲堂
九月的南京,晚风从鼓楼那边吹过来,地铁口卖桂花糕的阿姨正收摊。我站在路边回一条消息,手机忽然卡了一下。不是死机,是那种——你懂吧——电量还剩 30%,它却像在犹豫要不要把屏幕亮度调低。那一刻我脑子里蹦出一个不相干的词:类脑计算。
别笑。真不是硬蹭。我们手里的芯片,很多时候像一群打卡上班的会计:时钟一响,所有人齐刷刷翻开账本,哪怕今天没几笔账,也得把流程走一遍。脑子不这么干。脑子里的神经元有时候闹腾,有时候装死。安静的时候,真安静。这个差别,正在把一类新的计算架构推到台前。

传统芯片的底层逻辑,说白了,是把计算和存储分开。CPU、GPU 算得飞快,但数据得在内存和计算单元之间来回搬。搬一次,耗一次电。AI 大模型火起来之后,这个搬运量有点离谱。于是有人回头看脑子:神经元和突触挨在一起,信号到了就处理,处理完顺手改一下连接强度。存算一体,不是新词,但真做进硅片里,麻烦一箩筐。
它想学的不是“聪明”,而是“省着聪明”

类脑计算里常被提到的一个词是脉冲神经网络(SNN)。普通人工神经网络里,神经元输出一个数值,比如 0.73、-1.2。SNN 里更像发电报:有脉冲,或者没脉冲。时间点也有意义。早到一点、晚到一点,信息不一样。这听起来很酷,对吧?但训练它,比训练传统网络更难。因为脉冲不可导,梯度没法直接传。研究者得用代理梯度、ANN-to-SNN 转换之类的办法绕路。绕得通,但没那么丝滑。
还有一个容易被忽略的点:事件驱动。没有事件,电路可以少干活。少干活,理论上就省电。不过话说回来,硅片会漏电,外围电路要待命,内存要刷新。省电不是白捡的。你让它识别一个一直不动的画面,它可能很省;你让它处理高速动态视觉,它也可能因为稀疏事件而占便宜。任务不对,优势就缩水。
三块芯片,三条不太一样的脾气
IBM 的 TrueNorth 是很早的公开代表。它把大量神经元和突触集成到一块芯片上,走的是异步、事件驱动的路子。你可以把它理解成一块为脉冲神经网络定制的实验田。它的出现让很多人忽然意识到:原来芯片可以不围着时钟转。
Intel 的 Loihi 系列,更像是把类脑计算往研究平台上推。它支持在线学习、可编程神经元模型,适合高校和实验室折腾各种脉冲算法。Loihi 2 还引入了更多可编程特性。说实话,这东西不是拿来跑《黑神话》的。它跑的是另一类问题:稀疏、时序、事件流。
曼彻斯特大学的 SpiNNaker,名字里就带着“Spiking Neural Network Architecture”的味道。它用大量 ARM 核来模拟神经元,目标之一是实时模拟大规模脉冲网络。你去看它的公开资料,会发现它更像一台为脑模拟搭的并行计算机,而不是一块单纯的加速卡。
国内这边,清华的天机芯在 2019 年登上《Nature》封面,是个绕不开的节点。它尝试把人工神经网络和脉冲神经网络放在同一套架构里,让两者互补。这个思路挺有意思:不把类脑和深度学习对立起来,而是让它们在同一块板子上各干各的活。
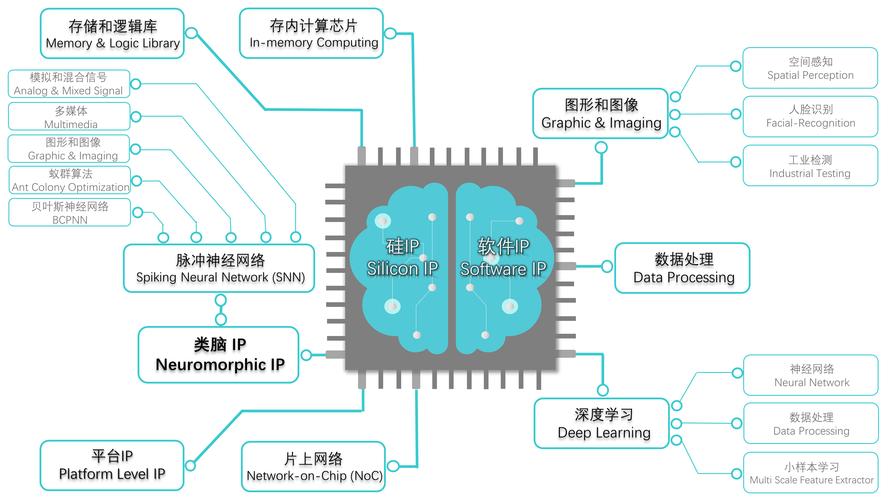
当然,这些项目不是同一条赛道上的选手。它们更像不同实验室里养出来的不同性格的猫。有的高冷,有的黏人,有的专门抓老鼠。你非要说谁更聪明,那就跑偏了。
别把“像脑”理解成“造脑”

这是常见的误会。类脑计算不是要把人脑复制出来。人脑有 860 亿左右的神经元,这个数量级本身就很吓人,更别说胶质细胞、神经调质、激素环境这些还没完全搞清楚的东西。类脑计算更多是借几个关键机制:脉冲、稀疏、异步、存算一体、可塑性。借来用,不是搬家。
另一个误会是:类脑芯片会立刻取代 GPU。短期内不现实。训练大语言模型,仍然高度依赖现有 GPU 生态、CUDA 工具链、矩阵乘法优化。类脑芯片擅长的场景,往往是边缘端、传感器前端、机器人控制、低功耗视觉、脑机接口信号处理。你把一个万亿参数模型塞进类脑芯片?工具链先哭了。
还有个误区:脉冲神经网络一定比传统网络省电。不一定。脉冲稀疏的时候省,脉冲密集的时候,通信开销可能比传统网络还高。而且 SNN 的训练和部署工具还不算成熟。写代码的人少,调参经验少,踩坑的人多。这个阶段,有点像早期 GPU 编程。前景有,但别急着封神。
问答时间:它和现在的大模型,到底是什么关系?
有人问,类脑计算是不是要革大模型的命?我觉得,先别急着站队。大模型走的是规模路线:更多参数、更多数据、更多算力。类脑计算走的是机制路线:更稀疏、更事件化、更像生物神经系统。两条路可能会碰头。比如用类脑硬件做低功耗推理,用大模型做知识底座,再让脉冲网络处理实时感知。听起来像拼装,但工程上常常就是这么长出来的。
还有人问,类脑计算能做人形机器人的大脑吗?部分可以。人形机器人需要低延迟、低功耗、多模态融合,这些正好是类脑架构的甜点区。但运动控制、平衡、抓取,传统控制理论仍然很强。更可能的情况是混合:类脑芯片管感知和反射,传统处理器管规划,大模型管任务理解。别指望一颗芯片包打天下。
对了,脑机接口也常被拉来和类脑计算一起聊。两者确实有交集。脑机接口需要处理神经信号,信号本身就是脉冲序列。用脉冲神经网络去解码,省掉一步“脉冲转数值”的转换,听起来顺理成章。不过,从实验室到临床,中间隔着可靠性、生物相容性、伦理审查。这不是写个 Python 脚本就能跨过去的。
冷思考:热闹背后,缺的是什么?
缺工具链。真的缺。你不能让每个研究者都去手写底层映射。缺基准。不同芯片之间怎么比?比准确率、比延迟、比能耗、比面积?任务不同,结论可能翻个面。缺 killer app。现在类脑计算有点像 2006 年的 GPU,硬件有苗头,但大家还在找那个非它不可的场景。
不过,也别太悲观。神经形态传感器已经用在一些事件相机里。工厂流水线上的高速检测、无人机避障、可穿戴设备,都在试。它们不显眼,但真实。技术落地常常不是一声巨响,而是一堆小动静。先是某个传感器变省电了,再是某个机器人反应快了一点。然后你回头看,发现底层已经换了。
南京的夜里,地铁口那家桂花糕收完了。我手机还是那块手机,芯片还是冯·诺依曼的老结构。但实验室里,有人正在让硅片学着像脑子那样,安静、稀疏、偶尔忘事。忘事不一定是坏事。对芯片来说,少算一点,可能意味着多跑一会儿。至于它会不会在某天突然变得“聪明”——谁知道呢。先让子弹飞一会儿。
作者|科技
排版|科技
审核|见微