 大讲堂
凌晨一点半,我盯着手机相册。
它把三年前在南京老门东拍的一张照片归进了“猫”这个文件夹。照片里其实是一团蹲在墙头的橘色影子,糊得很,连我自己都不太确定那是不是猫。但它猜对了。
这事本身不稀奇。稀奇的是我问了一句为什么,得到的回答是四个字——深度学习。像句咒语。念完就没下文了。
它把“规则”这件事,扔掉了
老一代做图像识别的人,是手写规则的。先找边缘,再找角点,拼出形状,判断这是不是猫耳朵。工程师坐在屏幕前,一条一条调参数,调到自己都烦。
这办法不是不行。受控环境里挺能打的,流水线上认个零件,又快又稳。可光线一变、角度一歪、猫打个哈欠——全崩。
深度学习干的事,说白了就一句:把这些手写的规则扔了,让机器自己去试。你喂它几十万张标好的图,它自己去找哪些像素组合反复出现。没人告诉它猫有胡须,它自己发现某种纹理总跟“猫”这个标签一块儿冒出来。
所以它学到的压根不是规则,是统计上的相关性。这点很要命。后面所有的坑,都是从这儿长出来的。
“深”这个字,被误解得最惨

很多人以为深就是聪明。层数堆得越高越厉害。早几年确实有这个风气,论文里比谁层数多,一百层、上千层,听着像盖楼。
但深的本意只是,中间隔了很多层变换。
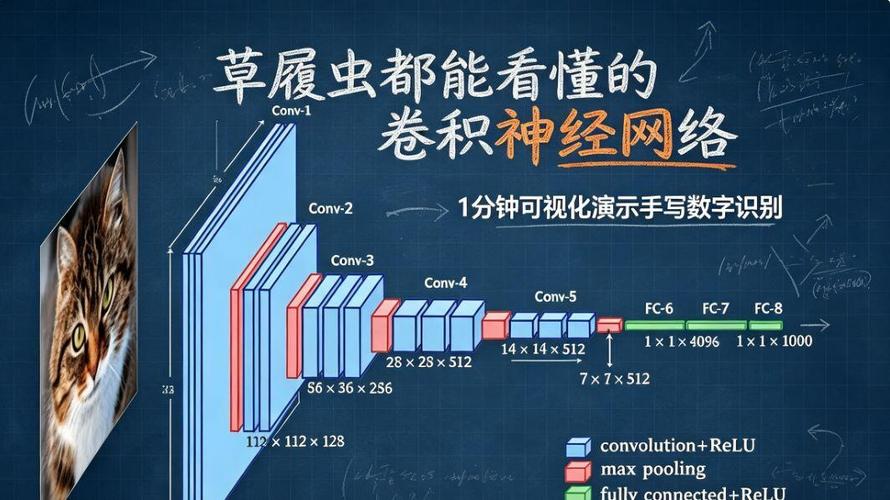
一张图进去,是一堆数字。出来,是一个判断。中间那几十层在不停地重新表示它。靠前那几层可能只看得见亮暗边界,中间开始看得见部件,靠得近的层才隐约对得上“猫”这么一个概念。
这个过程有个听上去很玄的名字,叫特征表示。其实你可以当成榨汁。原料进去,一层层过滤,剩下的是浓缩液。麻烦在哪儿呢——你没法完全确定它到底榨出了什么玩意儿。中间那些层对人是半透明的。这就是可解释性难题的来源。不是谁偷懒没做,是结构上就摆在那儿。
梯度下降:摸黑下山
“训练”这个词听着挺体面。实际过程挺笨的。
想象你被空投到一座山上。大雾。看不见路。手里只有一根能测脚下坡度的棍子。你要走到谷底。你只能做一件事:朝脚下最陡的下坡方向挪一小步,再测,再挪。
步子大了会冲过头,来回震荡。步子小了天黑都到不了。
那个“步子多大”,业界叫学习率。调它是门玄学。也是很多工程师半夜睡不着的直接原因。
而深度学习真正的转折点,是反向传播。机器输出一个错答案之后,从输出那端往回倒着查,每一层各背多少责任,然后各自改一点点。改完再来一遍。几十万张图,几十万次。参数就是这么被磨出来的。

几个我实在想吐槽的误区
误区一:它像人脑。
不像。神经网络里的“神经元”只是借了个名字。它没有放电,没有递质,没有睡眠周期。说它像大脑,跟说飞机像鸟差不多。早期借鉴过。今天是两码事。
误区二:数据越多越好。
多,但得干净、得有代表性。喂进去一堆标错的图,它会非常忠诚地把这些错误学得滚瓜烂熟。垃圾进垃圾出,这话在深度学习里基本是物理定律级别的存在。
误区三:它会“理解”。
这个得小心。它干的事是在高维空间里找边界。你问它为什么,它给不出理由,只能给你一个概率。所以会出那种事——图里加几个几乎看不见的噪点,人看还是猫,它斩钉截铁说这是烤面包机。不是它瞎,是它看的东西跟我们压根不一样。
跟做算法的老同学聊了四十分钟
我问他,你们天天挂在嘴边的模型,到底在忙什么。
他说:八成时间在洗数据,一成在调参,剩下一成在解释为什么这次又不行了。
我:那模型本身呢。
他:模型大多是现成的,拿来改改。真正麻烦的是数据里那些你以为对、其实错的东西。
我又问,你们最怕什么。
他想了会儿。最怕上线之后出那种没人能复现的错。用户投诉,你复现不出来,只能加一层规则硬拦。拦完又冒新的。
这段我印象挺深的。外面的人以为深度学习是自动的、端到端的、一劳永逸的。一线实际是这样的:缝缝补补,边跑边修。
说点冷的
我不敢说这条路会一直顺下去。
现在它吃的东西——文字、图像、声音——本质上都是已经被数字化过的、量大管饱的素材。再往前一步,要它在那些没有海量标注、没有明确反馈信号的地方干活,瓶颈就会露出来。比如车间里只出过三次的罕见故障,你上哪找三十万条样本。
还有能耗。训练一个大模型,电是实打实烧掉的。这不是道德批评,这是账。算力往上堆,收益却在变缓。这话是我从好几个做这行的人嘴里听到的,他们平时不太愿意公开讲。
不过话说回来。我倒是觉得眼下最值得关心的,不是它什么时候超越谁。而是一个特别朴素的问题:它犯错的方式,我们能不能接得住。
自动驾驶认错一块广告牌,和相册把猫认成面包,是两个量级的后果。技术本身不会替你回答这件事。
那台相册还在自动分类。前几天它把我妈认成我外婆。两个人笑了半天。我猜它以后会改好。也许不会。
谁知道呢。
作者|科技
排版|科技
审核|小北