 大讲堂
它不认识猫,它只是在划一条线
把机器学习拆开看,其实没那么玄。你有一堆样本,每个样本被拆成一串数字——图片就是像素亮度,文本就是词的编号,传感器就是电压值。然后有个函数,吃进这串数字,吐出一个答案。函数里面有成千上万,甚至上亿个可以拧的旋钮。 训练做的事,就是拧旋钮。 怎么拧?先让它乱猜,猜完跟正确答案比一比,看看差了多远。这个差距叫损失。然后沿着让差距变小的方向,把每个旋钮微微动一下。重复几百万次。就这么回事。听起来笨得不行,可它管用。 我更喜欢另一个比方:你在纸上撒了一把红豆和绿豆,让机器画一条线把它们分开。二维平面上一条直线就够。要是豆子堆成螺旋形,直线就没辙了,得换成弯弯曲曲的曲线。所谓模型变复杂,说的就是这条线能弯到什么程度。
真正卡住人的,往往不是算法
我见过太多团队在这上面栽跟头。他们花三个月调模型结构,结果发现效果上不去,是因为标注数据里有一批标错了。或者更隐蔽:训练用的照片全是白天拍的,一到晚上,灯光偏黄,模型就开始胡说。这叫分布漂移。数据变了,模型还停在原地。 还有过拟合。这个词被讲烂了,但它的直觉其实很朴素——模型把训练集的每一个细节都背下来了,包括噪声。就像学生把练习册答案全记住,换个题型就懵。你在训练集上看它准得吓人,一上真实场景就露馅。 所以做这行的人有一半时间不在写模型,在处理数据。清洗、去重、补标签、做增强、划分验证集。枯燥。非常枯燥。但差分就出在这儿!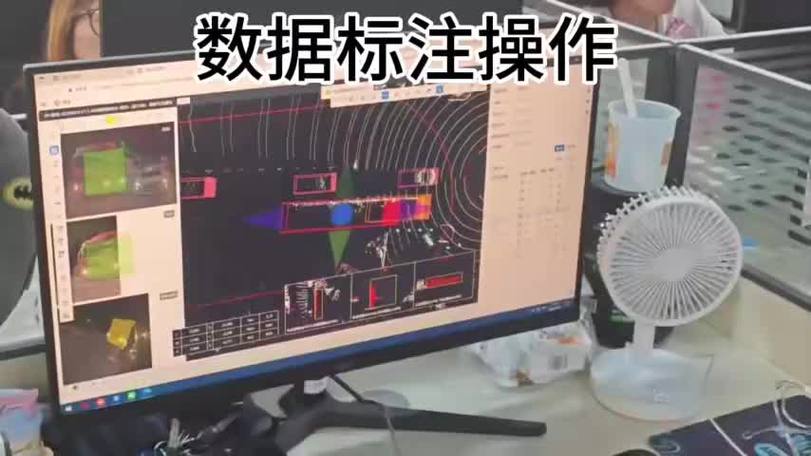
几个我被问过很多次的问题
把期待值调低,反而看得更清楚
作者|科技
排版|科技
审核|知知