那颗会“敲门”的芯片:类脑计算到底在算什么

实验室那台示波器,我盯了快一个钟头。 屏幕上不是常见的方波,是一簇一簇挤在一起的尖峰。密的密,疏的疏。密的时候像有人在敲门,疏的时候——就像快睡着了。 工程师说,这就是一颗类脑芯片在“想事情”。 一点也不浪漫。但那确实是另一种计算方式在呼吸。

先泼盆冷水:它跟很多人想的不是一回事

先泼盆冷水:它跟很多人想的不是一回事
先泼盆冷水:它跟很多人想的不是一回事
一听“类脑计算”,不少人脑子里立刻跳出一个画面:造一颗会思考的脑袋。 不是。至少眼下不是。 它做的是一件更朴素、也更别扭的事——把“算”和“存”塞回同一个地方,让数据变成稀疏的、带时间戳的脉冲。 传统芯片里,数据在内存和计算单元之间来回搬。这条路又长又费电。人脑不是这么干的:突触就长在神经元旁边,信号来了就地处理,就地留下痕迹。搬运这个动作,被取消了。 所以类脑计算在现阶段,模仿的是结构,不是功能。这中间差着十万八千里。

脉冲:把“时间”也当成了一个变量

这点特别容易被忽略。 我们熟悉的神经网络,每个神经元每一轮都要算一遍。哪怕它这一轮什么信息都没收到,也得算。算完还得把结果写回内存。 脉冲神经网络不是。只有“发放”的那一下才产生计算,其余时刻基本静默。 这意味着什么?意味着功耗跟着活动量走,而不是跟着芯片规模走。夜里没车的高速公路,不用为每一米都开着路灯。
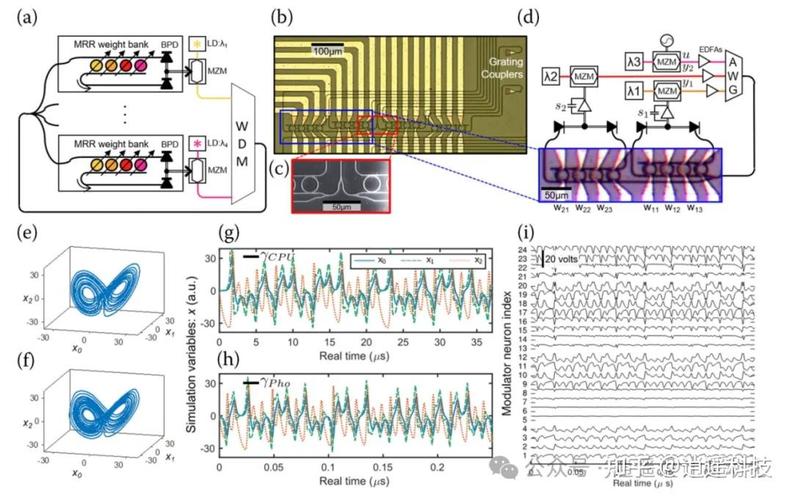
神经形态芯片脉冲神经元电路结构显微图
神经形态芯片脉冲神经元电路结构显微图
时间在这里也变了味道。一个脉冲,什么时刻来的、跟上一个隔多久,本身就是信息。同一组信号,时间差一点,结果可能完全不同。这在图像上无所谓,在声音、在触觉、在那种连续不断变化的传感信号上,就很要命。

真做出来的那些家伙

不是纸上谈兵。 2014年,IBM 拿出 TrueNorth,四千多个核心,集成规模大约是百万级神经元,运行时的功耗在毫瓦量级——这个数字放到今天看依然扎眼。 后来 Intel 做了 Loihi,曼彻斯特大学那边搞了 SpiNNaker 系列,走的是另一条路:拿大量通用小核去模拟脉冲,慢是慢点,但灵活。 国内,清华的天机芯在 2019 年登上过《自然》封面。思路挺实在:让类脑的脉冲网络和常规的深度学习网络跑在同一块芯片上,不硬拗,两种模式各管各的。 南京这边,几所高校也有组在磨神经形态器件。我去过一次,房间不大,仪器堆得挺满,桌上摆着一片片镀过膜的硅片。说实话,看着不太像“未来已来”,更像是个手艺活的作坊。
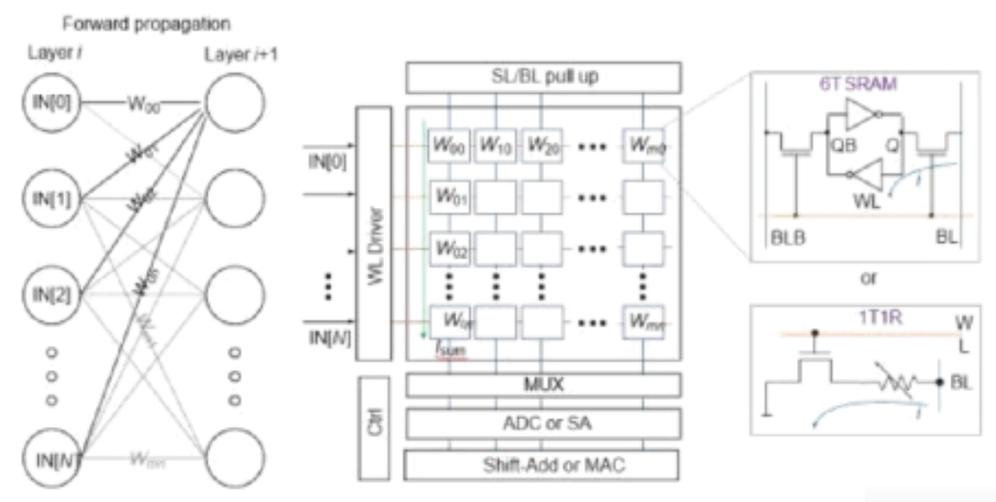
忆阻器交叉阵列存算一体芯片结构示意图
忆阻器交叉阵列存算一体芯片结构示意图

几个常见误会,顺手拆了

几个常见误会,顺手拆了
几个常见误会,顺手拆了
误会一:它是个更快的 AI 加速卡。 不是。你拿它去跑大语言模型,大概率跑不动,也没必要。它擅长的是稀疏、事件式、低功耗长时在线的场景——传感器前端、边缘设备、那种电池要撑几个月的活儿。 误会二:类脑就等于省电。 看负载。输入很稀疏的时候,优势明显;一旦信号密集到接近连续,那点省下来的功耗很快就被吃掉。别拿理想工况的数字去套所有任务。 误会三:它在模仿神经元,所以离人脑很近。 差得远。现在能模拟的,多数还是简化过的脉冲神经元模型。真实神经元里那些离子通道、树突的非线性、几十种神经递质……基本都还在门外站着。

几个常被问到的问题

问:那它现在能商用吗? 能,但范围窄。已经在一些传感器信号处理、始终在线的唤醒电路里冒头了。至于大规模替代谁?短期内看不到。 问:为什么听着热闹,身边却没人用? 软件生态是硬伤。编程范式不统一,换个平台就得重写;脉冲怎么训练,本身就是个没完全解决的问题——反向传播那套在这儿不太灵。 问:那它还有戏吗? 有。它的戏不在取代谁,在于补上那块一直空着的拼图:极低功耗、实时、事件驱动。这块需求真实存在,而且越来越大。

说点不客气的

说点不客气的
说点不客气的
我看了几年这个方向,最怕两件事。 一件是把它吹成“下一代计算革命”,然后三年后发现还在实验室里;另一件是把它贬成“学术玩具”,无视它在特定场景里已经跑起来的事实。 两个都省省吧。 它更可能的样子是——不会成为主角,但会像微控制器那样,藏在很多设备的角落里,安安静静地数脉冲。你手机震动的那一下,背后可能就有它在干活,而你永远不会知道。 回到开头那台示波器。敲门声还在继续。 密一阵,疏一阵。它不解释自己在算什么。它只是,一下,一下地敲。

作者|科技

排版|科技

审核|知知

免责声明:市场有风险,选择需谨慎!此文仅供参考,不作买卖依据。如有侵权请联系删除。
文章名称:那颗会“敲门”的芯片:类脑计算到底在算什么
文章链接:https://www.lfdjt.com/p/keji/a/25117.html