2026-09-24 14:48:50 分类:正文
上周跟朋友约在南京珠江路边上的老咖啡馆见面,他掏出来手机翻了个新出的AI工具,对着桌上我喝了一半的冰美式拍了张照,随口说了句“他胃不舒服,想换点热的,附近哪里有”。
十秒不到,AI弹出来三个选项,连每家店的热饮糖度平均水平都标了,还提醒我冰美式刚喝完别立刻喝太烫的。
我当时拿着手机愣了两秒。这放在三年前,可是只有顶流实验室里才能跑通的demo。现在掏出来个手机就能玩。
别背定义了,你早就用过它了
很多人一听到“多模态”三个字,第一反应就是高深的科技名词,跟我这种普通用户没关系。
扯。你刷短视频的时候,系统自动给视频加的字幕,算不算?你上传照片到云盘,搜“猫”就能出来所有猫的照片,算不算?这些其实都是多模态技术的落地,只是早几年的版本太初级罢了。
以前的AI,都是单科状元。做图像的只会认图,做语音的只会听声,做文字的只会聊天,各干各的,谁也不打扰谁。
现在的多模态大模型不一样。它是真的能同时看懂你发的图,听懂你说的话,读懂你打的字,然后把这些信息捏到一块理解你的意思。
你发一张随手画的歪歪扭扭的猫,再打一行字“帮我写个摸鱼的朋友圈文案,要符合这只猫的气质”,它能看懂图里猫瘫着不想动的劲,接得住你“摸鱼”的梗,写出来的段子能直接用。
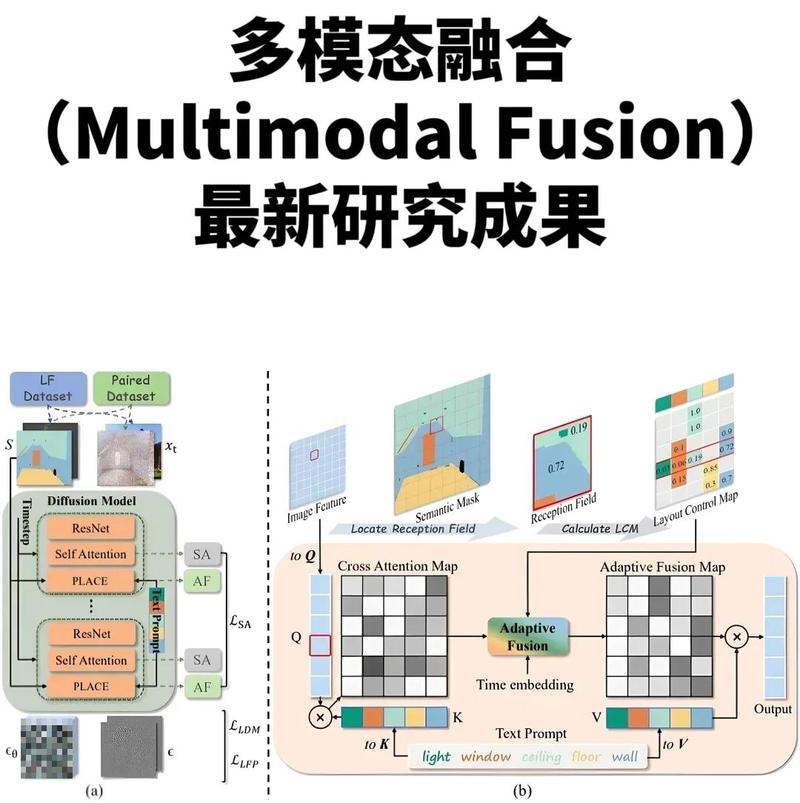 多模态大模型处理用户图文请求操作界面
它到底聪明在哪?不是拼接,是「一起想」
说实话,我以前也误会过。觉得这不就是把图像模型、语音模型、文字模型拼一块,套个壳卖新概念嘛。
直到上个月跟一个做模型训练的朋友喝酒,他两三杯酒下肚给我讲明白,这里面差着一整个时代呢。
早年的所谓多模态,就是你传一张图,我先调用图像模型把图转成文字描述,再把这段文字丢给大语言模型生成内容,中间转了整整一道手。信息折损了多少?
比如你图里猫耳朵上沾了一点咖啡渍,你刚好问AI“它身上沾的是什么”,图像模型转文字的时候只会写“一只猫蹲在桌子上”,根本不会提那点不起眼的咖啡渍,AI自然答不出来。
现在的原生多模态大模型不一样,从训练第一天开始,就把文本、图像、音频、甚至视频帧混在一起喂,让模型自己学不同信息之间的关联。相当于一个人同时长了眼睛、耳朵和嘴巴,所有信息进了同一个大脑一起处理,不是看完了再传话给另一个大脑想。
差就差在这一点。原生多模态能接住那些跨模态的隐式需求,早年的拼接式多模态做不到。
我上周试过,发了一张我家猫躲在快递箱里的照片,问它“你猜它为什么躲在这里”。它说“快递箱有你的味道,猫咪喜欢待在有主人味道的地方,你应该出门很久了吧,它在想你”。
换做以前的拼接模型,它最多给你输出“这是一只猫在纸箱里”,根本说不出这种话来。
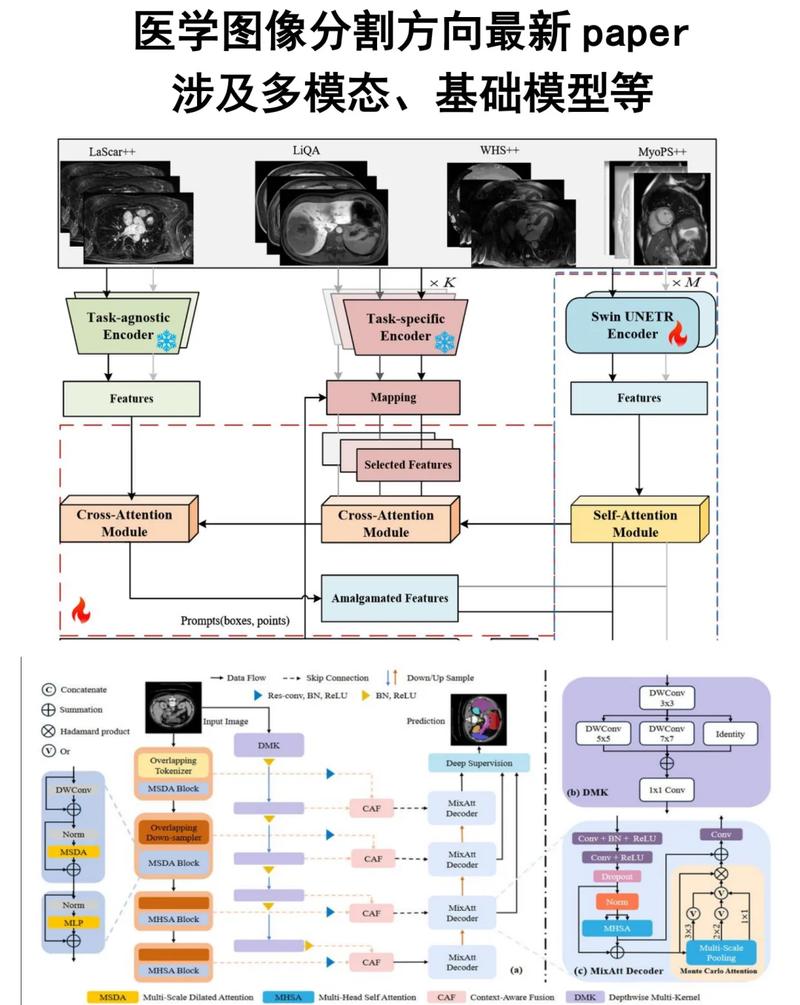 原生多模态与拼接多模态处理流程对比图
现在吹的和骂的,好多都不对
 现在吹的和骂的,好多都不对
一种错得离谱的说法是,多模态大模型马上就要取代设计师取代摄影师了。我呸。
上周我让它给我生成一张“秋天南京梧桐树下的露天咖啡馆”,出来的图看着像模像样,仔细看,咖啡杯的把手歪成了麻花,玻璃窗外的树影糊成一团,连咖啡馆门牌号的数字都是错的,七扭八歪根本认不出来。
它学了一堆咖啡馆图片的特征,能拼出个看起来对的样子,可它根本不知道“一扇能推开的玻璃门”应该遵循什么物理规则,也不知道你想要的“梧桐落叶落在咖啡杯边”的氛围感,到底要怎么精准呈现。替代?还差得远呢。
另一种常见的误解是,说这就是换个概念割韭菜,全都是旧瓶装新酒。话也不能这么说。
你倒回两年前想想,那时候你能拿着手机,对着一张随手画的项目草稿拍个照,说“帮我把这个改成PPT大纲,再帮我算一下三个方案的大概成本”吗?那时候真做不到,现在随便找个正规的多模态工具就能做成,这就是实打实的进步。
不过话说回来,现在市面上确实有一堆割韭菜的。很多小APP打着多模态的旗号,本质就是套了个大厂的公开API,还是转一道手的拼接货,卖几十块钱的年卡,那种就是收智商税,别碰。
对普通人来说,现在的多模态大模型最大的用处,根本不是替代谁,是帮你省掉一堆乱七八糟的破事。
你攒了十几年的旧照片,要找出来所有跟家人一起出去玩的合影,以前你得一张一张翻,现在打开支持多模态的相册,说一句“帮我找所有有我爸妈的照片”,一分钟就给你整理好。
你上课听讲座,一边录音频一边拍老师的黑板,整理笔记要整理一两个小时,现在直接把音视频和照片丢给AI,它十几分钟就给你整理出逻辑通顺的完整笔记,连老师画的示意图都能给你转成规范的。
这些小事,攒起来能省出来多少时间,想想都舒服。
当然,问题也挺多。
比如隐私,你拍了自己的身份证、银行卡,传上去给AI处理,这些数据会不会被拿去做别的?现在各家都说自己管得严,可谁也不敢打百分百的包票。
比如版权,AI训练的时候用了一堆有版权的图片、文字,生成出来的内容版权算谁的,现在整个行业都还说不清楚。
还有个很有意思的小测试,我上次做的。把我和朋友的合影发进去,问它“你猜这两个人哪个更开心”,它说左边的,因为左边的人嘴角扬得更高。可那天明明是右边的朋友刚中了奖,笑到肚子痛,拍照的时候刻意收敛了表情,它能看到表面的五官特征,读不懂人藏在表情背后的情绪,这就是现阶段绕不开的局限。
昨天我路过新街口的电子城,门口摆摊的小伙子都支着摊子,摆着多模态AI的体验摊,十块钱给你画一张肖像再写一首藏着你名字的诗,围了一堆年轻人在那玩。
你说这东西离我们远吗?一点都不远。它不是实验室里飘着的黑科技概念,就是已经落到我们脚边的日常,说不定你今天刷手机存照片的时候,就已经用上了,只是你没发现而已。
免责声明:市场有风险,选择需谨慎!此文仅供参考,不作买卖依据。如有侵权请联系删除。
文章名称:路边咖啡馆试玩新AI:多模态大模型到底改变了什么
文章链接:https://www.lfdjt.com/p/keji/a/2425.html