2026-09-24 12:18:58 分类:正文
上周六泡南京珠江路路口的社区咖啡馆,邻座两个学生对着电脑吵,一个说大模型算法不就是堆显卡堆数据拼参数,骗经费的玩意,另一个急得脸通红说你根本没跑过训练,懂个屁。我喝冰美式喝出一半泡沫,忍不住多听了两句。
挺有意思的。很多人对大模型算法的印象,要么就是停留在参数越大越聪明,要么就是觉得就是把所有网上的东西存进去,要回答的时候调出来拼一拼。
真不是这么回事啊。
你敲出问题那一秒,算法到底在忙什么
你打开常用的大模型工具,输入“帮我写一篇南京国庆逛吃攻略”,屏幕开始逐字出内容的那一秒,你看不见的服务器机架里,大模型算法在做什么?
很多人以为它在搜数据库找现成的攻略,拼接一下抄给你。不对。它是一个字一个字猜下一个字是什么。
对,就是猜。它的核心逻辑,就是基于你已经输入的所有文字,算出下一个字每个可能性的概率,挑概率最高的那个放出来,放完再算下一个,循环往复,直到凑完你要的内容。
支撑这个“猜概率”的核心,就是现在主流大模型都在用的自注意力机制。说人话,就是你这句话里每个词,它会自己判断哪个和哪个有关系,关系有多近。比如你说“南京国庆去中山陵人挤不挤”,它会自动把“南京”“中山陵”“人挤”绑定在一起,不会把“国庆”和“挤”单独拎出来,理解成“所有国庆都一定挤”。
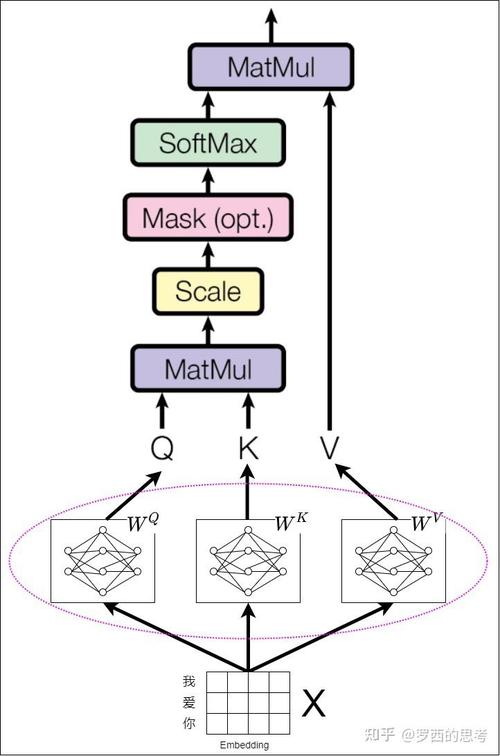 大模型transformer自注意力权重可视化热图
说实话,这个机制刚出来的时候,业内都惊了。以前的算法做语言处理,都是按顺序一个个处理,前面的词看完看后面,隔十个八个词就忘了前面说的核心是什么。自注意力不一样,它一眼能扫完你整段话,给每个词标好“谁和谁是一伙的”,所以才能抓住长句子里藏的逻辑。
你现在让大模型写一万字的长篇小说,它不会写着写着把主角名字写错,核心就是这个机制在撑着。
网上吵疯的“参数阴谋论”,到底错在哪
刚才咖啡馆那学生说的“不就是堆参数”,这话网上一大票人信。说大模型算法就是资本砸钱堆出来,没有任何技术含量。
这话听着解气,其实站不住脚。
参数是什么?说白了就是大模型里记住各种语言规律的“小节点”,每个参数就是一个可调的小开关,亿万个参数组合起来,就能记下从“的地得”怎么用,到写代码for循环要加括号,再到古诗平仄对仗的所有规律。
那是不是参数越多一定越好?也不对。这两年好多团队做小参数大模型,算法优化到位,效果不比超大参数模型差多少,普通人日常用根本感受不出差别。比如把没用的冗余参数剪掉,把重复的规律合并,小模型跑起来速度快好几倍,占用资源也少,适合装在手机本地用。
还有个常见误区,很多人觉得大模型训练就是把整个互联网都存进去了。说实话,我之前也这么以为,直到去年跟一个跑训练的朋友吃火锅,他说哪能啊。现在最大的大模型,总参数的存储量也装不下整个互联网的公开文字内容,根本存不下。
大模型学的不是“哪篇文章写了什么内容”,学的是文字和文字之间的规律是什么。打个比方,你读了一万本不同的侦探小说,不用把每本每个情节都背下来,你也能自己写出一本像模像样的新侦探小说,对不对?大模型学的就是这个“写侦探小说的路数”,不是背原书。
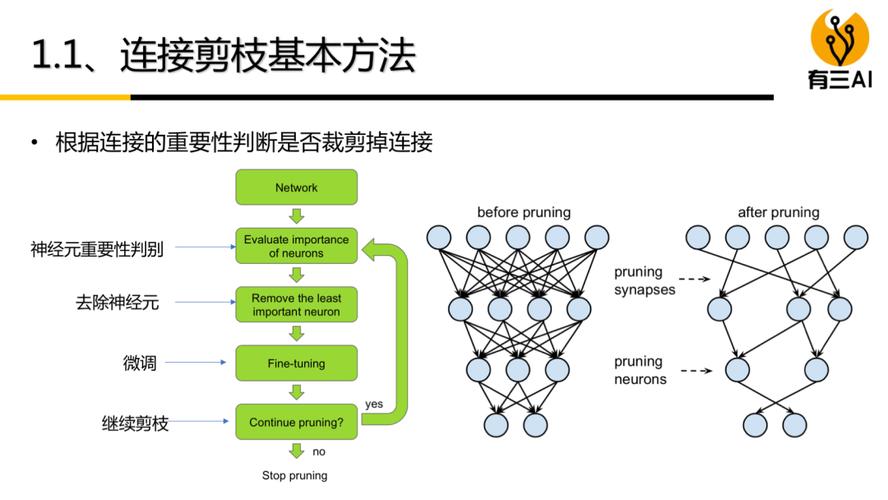 大模型参数稀疏剪枝优化示意图
那堆参数真的没有意义吗?也不是。参数够多,规律才能分得足够细,能接住更多奇奇怪怪的需求。只是单纯堆参数没有前途,算法的优化才是核心。
抛开造神和骂街,大模型算法接下来往哪走
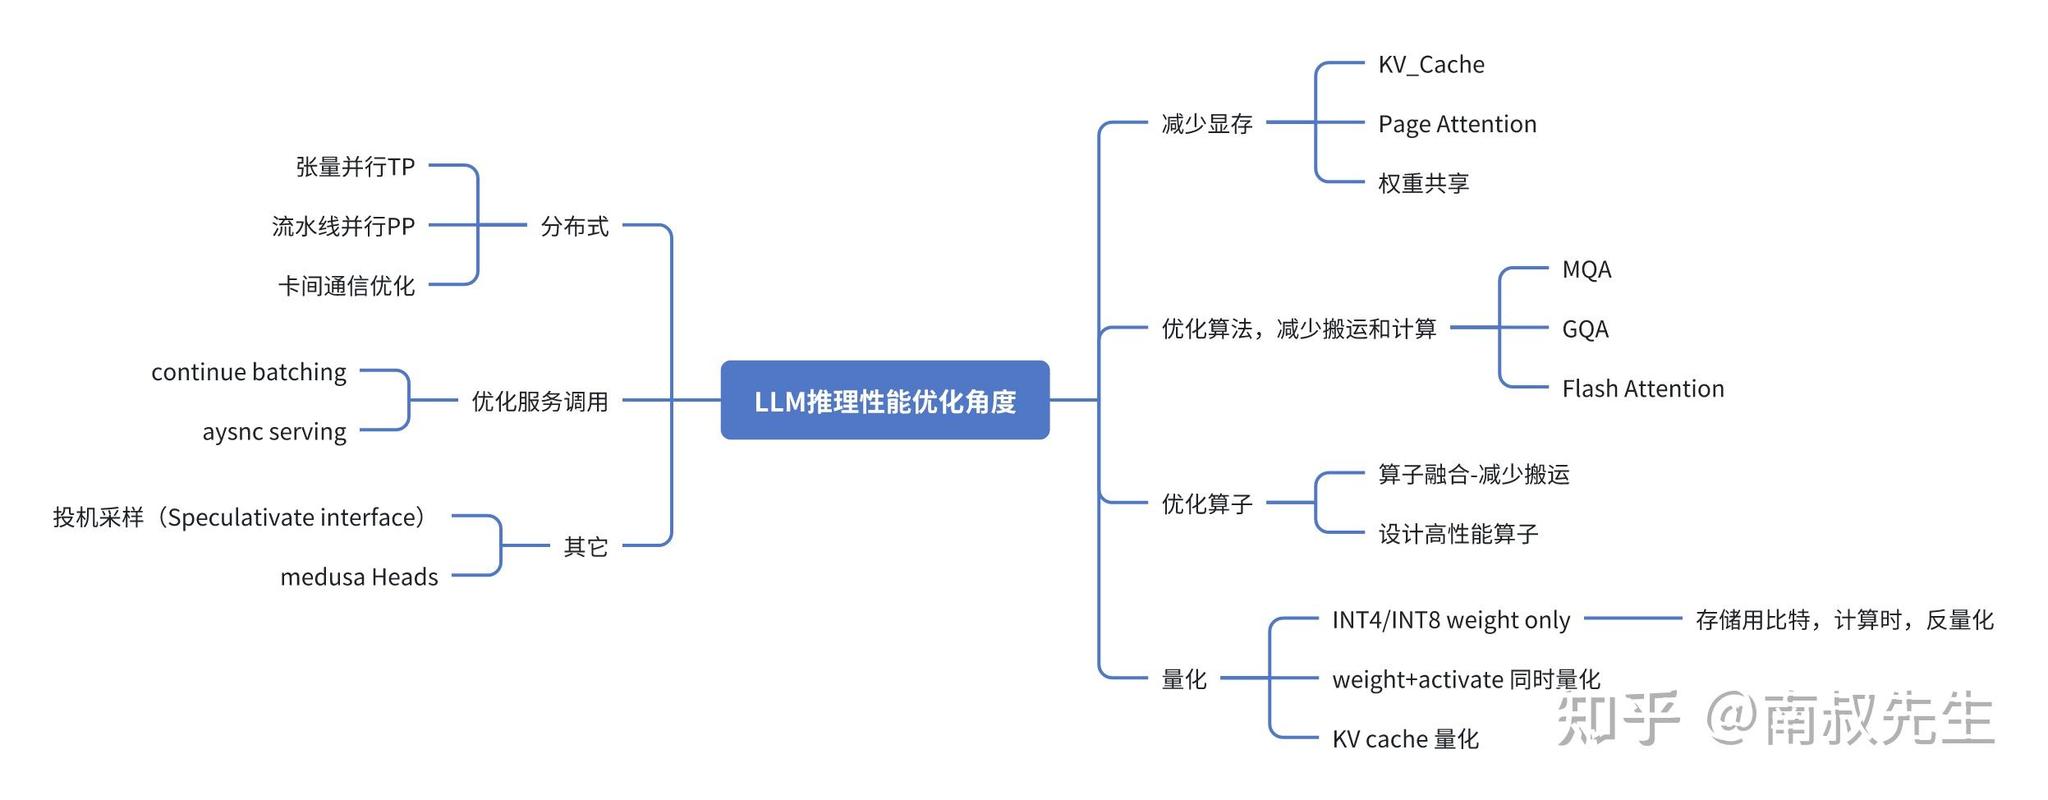 抛开造神和骂街,大模型算法接下来往哪走
不过话说回来,现在的大模型算法,毛病真的不少。最常见的就是胡说八道,大家叫它“幻觉”,本质还是那个猜字的逻辑——它只找下一个概率最高的字,只追求句子通顺逻辑自洽,不管说的内容是不是符合事实,所以会编出根本不存在的论文,根本没开过早饭的南京老馆子。
现在大家都在解决这个问题,路子挺多的。有的是给大模型加个搜索外挂,猜下一个字之前先去搜一遍公开资料,确认事实对不对再输出;有的是改训练逻辑,让模型训练的时候更看重事实准确性,不是光通顺就能拿分。
我最近看到挺多有意思的新方向,都不是往更大参数的路子走。比如往“专”走,做药物研发的大模型,算法就专门训练分子结构、医药实验相关的数据,不用学怎么写流量文案,不用学怎么做PPT,参数不用很大,效果比通用大模型好太多。
还有往“小”走,就是端侧大模型,直接把优化好的算法装到你自己的手机里,不用连云端服务器,你问它什么,它直接在你手机本地算,不用把你的隐私问题传到服务器,安全不说,速度还快,网不好的时候也能用。
很多人说大模型算法现在已经到头了,没什么新东西可挖了。我不这么想。从Transformer架构出来到现在,也就不到十年时间。十年前谁能想到,今天普通人掏出手机就能随便用大模型写东西画图?
当年深度学习刚火起来之前,不也有一堆人说AI已经死透了,不可能有新突破了?技术这东西,本来就是起起伏伏,你看着它现在好像就是拼参数拼钱,说不定哪天就出来一个完全新的算法框架,把现在这套整个换掉。
那天我走的时候,两个学生还没吵完,最后那个说“就是堆参数”的学生,加了另一个人的微信,说这周找个时间自己跑一遍小模型的训练试试。
挺好的。很多人对大模型算法的误解,都是离得太远,只看见网上吹的造神,或者骂的一无是处,没自己碰过。你真的找个开源小模型,自己调两次参数跑一遍训练,就知道那里面不是一堆堆的钱,是无数人试了无数次错摸出来的路。
冰美式喝完,太阳落进珠江路的楼缝里,南京的风已经带了桂花味,秋天真的来了。也就这样。
免责声明:市场有风险,选择需谨慎!此文仅供参考,不作买卖依据。如有侵权请联系删除。
文章名称:咖啡馆里的大模型算法:它真的懂你在说什么吗?
文章链接:https://www.lfdjt.com/p/keji/a/2377.html