第一次,拍了桌上刚做好的桂花拿铁拉花,让它给我写一段发朋友圈的文案,要带点南京秋天的意思。十秒出活,没有那种生硬的AI腔,最后还加了一句“桂花香飘出来的时候,才懂南京的秋为什么藏在巷子里”,不说我写的,朋友都信。
第二次,拍了我塞得鼓鼓的通勤包,里面乱七八糟揉着充电线、无线耳机、翻了一半的书,让它给我出个出差收纳方案。它看完直接说,你这个包看起来是16升的通勤款,侧袋刚好放笔记本电源,把充电线绕在电源上省空间,耳机放前置小隔层不会乱…末了还补了一句,你椅背上搭的薄外套起球了,出差记得换一件。
我抬头看了一眼,外套确实搭在椅背上,我拍包的时候根本没特意拍进去。
鸡皮疙瘩都起来了。
它不是会看图片的文本大模型
很多人对多模态的第一个误解,就是觉得它只是文本大模型拼了个图片识别接口。不。完全不是一回事。原来的单模态大模型,只练文本,从全世界的文字里学规律,想看图就得外接一个专门的识别模型,识别模型把图转成文字,再喂给文本大模型,相当于两个人分工干活,中间还要传话,传错了太正常。
多模态不一样。它从预训练阶段开始,就把文字、图片、音频甚至视频拆成同样格式的信息块,混在一起学。就像你从小长到大,不会先花十年学会所有汉字,再去学认苹果是什么样子,再去学听苹果的发音。你是看到苹果的样子,听到大人说“苹果”这两个字,摸过苹果的纹路,一起学会的。
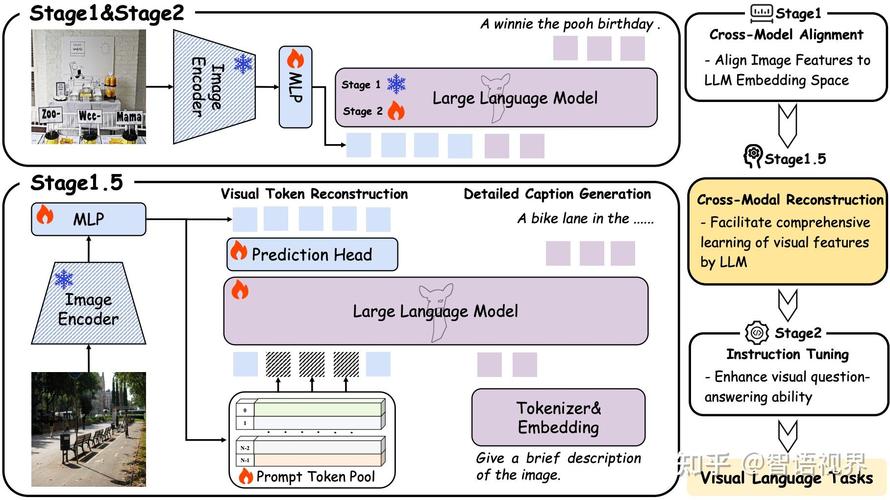
这个区别看着很小,实际用起来天差地别。你给它一张拍糊了的江边日落,只打了半句话“今天和老陈在江边,____”,它不是先识别“哦这张图里有江,有太阳,有两个人”,把这些转成文字,再补后半句。它从一开始就把图和你打的半句话当成同一个信息来处理,补出来的句子会带着图里的情绪,甚至能说出“风把头发吹乱的时候,太阳刚好落进江里”这种话,换那种拼接出来的模型,根本做不到。
说实话,现在好多科普都写错了这点,把拼接出来的产物也叫多模态,骗了好多刚接触的普通人。
你早就用上了,只是没发现
别觉得多模态大模型是大厂开发布会用的概念,离你日常用的东西远得很。不对。现在你手里拿的手机,更新了最近一年的新系统,大概率已经埋了多模态的功能。
你用的输入法的拍照转文字,新版本大多用了多模态。原来你拍一张上课记的手写笔记,歪歪扭扭的,识别出来错字连篇,因为原来的OCR只认单个字,认不出你整段话的逻辑。现在呢,它能看懂你写了半拉的“多模态”,那个歪歪扭扭的“态”不会被认错成“太”,甚至你把图和字写在一起,它能自动把文字摘出来,把图的说明帮你整理好,太省时间了。
还有手机相册的搜索。原来你要找一张照片,要么得提前打标签,要么就得自己翻,翻到天昏地暗。现在呢,你直接输入文字“去年秋天和朋友吃火锅的照片”,它能从你几万张照片里,把图里有火锅、背景有树、还有你穿黄衣服那张给你挑出来,哪怕你从来没给这张照片加过任何文字备注。
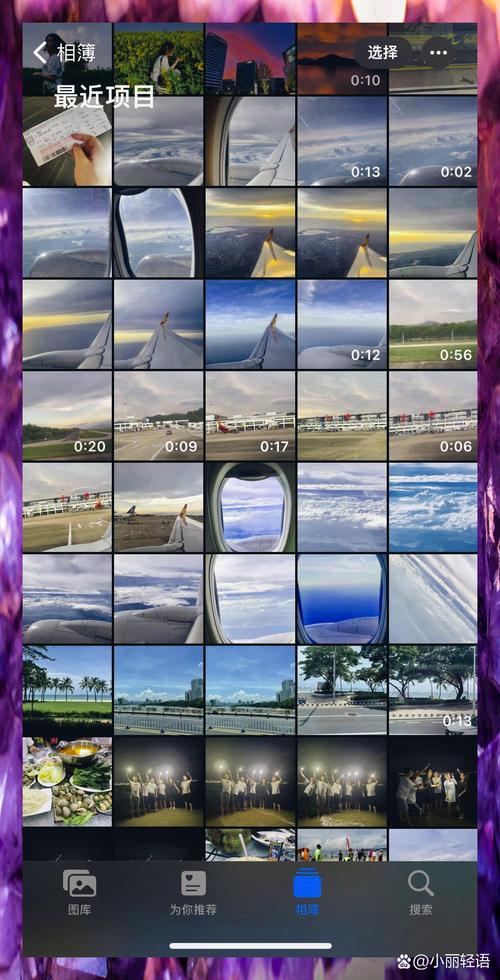
上周我妈让我找她去年去中山陵玩拍的照片,她只记得照片里有个卖糖芋苗的小推车,别的啥都记不清了。我直接在相册搜索框输入“有糖芋苗小摊的照片”,三秒就出来了。放一年前,我得翻半个钟头,翻到手机都发烫。
不过话说回来,现在好多厂商都不说这是多模态大模型做的,就悄悄当成一个新功能更进去了,用户用着觉得比以前好用,也不知道背后是什么,挺有意思的。
别吹太过,它现在还差得远
现在打开科技新闻,到处都是说多模态要取代这个取代那个,说得神乎其神。我玩了快一个月,说实话,它现在还差得远,根本没到取代谁的地步。
前阵子我试,让多模态大模型给我做一张南京秋天的文旅宣传图,我说要“中山陵台阶上落满梧桐叶,远处有紫金山,阳光从树缝里漏下来”,出来的图看着都对,仔细看,台阶数不对也就算了,还把“南京梧桐”写成“南京梧铜”,它自己根本发现不了错。它能拼出来像素的形状,但是它真的不懂“南京梧桐”四个字对这座城是什么意思,也不懂你要的那种踩在落叶上沙沙响的氛围感。你得调个十次八次,才能出来一张勉强能用的。
还有人说以后记者不用拍照片了,直接让多模态生成就行。扯什么呢。你去现场拍的那张,镜头上沾了点秋雨的雾,那个朦胧的质感,是你站在现场吹着秋风才有的,多模态能生成雾,生成不出那天的温度和味道啊。
更别说那些带情绪的东西了。你给它看一张你奶奶织的旧毛衣,领口补了两次,你带了二十年,它能说对“这是一件手工织的米白色旧毛衣”,但它读不出来你摸到领口补丁的时候,心里是什么感觉对吧?它学了上亿张图片,也学不到每个人独有的记忆啊。
昨天我又去那家巷口的咖啡店了,老板问我上次玩的是什么新东西,我给他演示了一遍,他拍了贴在墙上的手写菜单,让多模态给写一段新品桂花酒酿拿铁的朋友圈文案,五分钟出来,老板改了两个词,直接发了,晚上就跟我说卖了二十多杯。
你看,多模态大模型哪有那么玄乎。它就是个帮你省力气的工具。就像当年的计算器,不会算题的人拿它也考不了满分,会用的人,省出来的时间,就能多坐下来喝杯桂花拿铁,晒晒太阳,挺好。
作者|科技
排版|科技
审核|小北