 大讲堂

先拆穿神话:扩散模型到底是什么,不是什么
你就想象小时候做的墨水滴清水的实验——刚开始墨水是团轮廓清晰的形状,晃两下慢慢散成半透明的雾,再使劲晃,整杯水都浑成均匀的灰色,啥轮廓都看不见。 扩散模型的训练逻辑,就是把这个过程反过来。 先让AI反复练习“给一张清晰的图一步步加噪声,直到最后变成满屏的雪花点”,等它摸透了每一步噪声是怎么加的,再反过来教它:怎么从满屏的雪花点里,一步步把原本清晰的轮廓抠出来。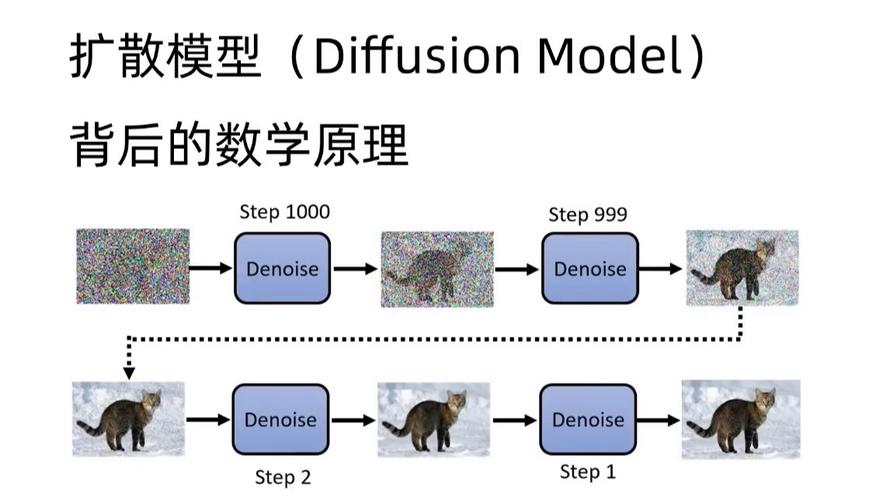
产业现状:已经悄悄跑通的三类落地路径
很多媒体追着写了两年大语言模型的商业化,其实扩散模型的落地进度,比大家想象的快得多。 第一类是大家最熟悉的内容生产端。早就不是停留在“画个头像”的阶段了。去年和米哈游的一个美术负责人吃饭,他说现在团队里一半的初级美术岗,日常工作已经从“从零画场景贴图”变成了“给扩散模型的生成结果挑错、修细节”。他们现在做开放世界游戏的森林场景,原来要美术团队熬三个月画完的资产,现在输入关键词加几张参考图,一周就能导出可直接导入虚幻引擎的3D模型。 第二类是很少被媒体关注的工业研发端。不管是锂电池的电极材料分子结构模拟,还是创新药的靶向蛋白设计,原来靠传统仿真算法要算几个月的任务,现在用扩散模型可以直接生成符合性能要求的结构候选。
没人敢明说的治理盲区
之前大家聊生成式AI的风险,总盯着大语言模型写假新闻、编虚假案例。其实扩散模型的风险,从落地第一天就藏在它的技术逻辑里。 扩散模型的生成没有“逻辑锚点”。 你用大语言模型生成一份假的公司公告,顺着上下文的逻辑查,总能找到前后矛盾的漏洞。但是扩散模型生成的假照片、假视频,光影、透视、物体的物理规律全是符合真实世界的,普通人根本分不出来。之前有个案例,有人用扩散模型生成了某科技品牌根本没办过的发布会现场图,比官方拍的高清图还细节,被几十家科技媒体当成新闻素材转了好几天。 还有更麻烦的版权问题。 现在所有商用扩散模型的训练集,都是爬取的全网公开图片,这里面有大量摄影师、插画师的原创作品。我去年帮一个南京本地的独立摄影师看他的作品,发现他三年前发在社交平台上的一组梧桐大道秋景,被拆成训练素材喂给了三个国内的画图模型。他自己现在去这些模型里输入“南京秋天的梧桐道,穿风衣的女生”,生成的图和他当年拍的角度、光影几乎一模一样,但是拿不到一分钱分成。 这很要命。 现在的扩散模型训练,本质上就是互联网时代的“圈地运动”。谁爬的图多,谁的模型效果好,但是原来的版权方,连上桌分蛋糕的资格都没有。 聊完这些,说几个和产业链上下游的人聊了快半年攒出来的判断,不是通稿里的正确废话。 第一,未来3年,扩散模型不会成为通用的AI底座,但是会成为所有生成类任务的标准基础设施。就像现在你做网站肯定要用数据库,以后只要涉及图像、视频、3D、声音这类连续信号的生成任务,底层肯定是扩散模型。大语言模型会退回到“调度员”的角色,负责理解用户的自然语言指令,把指令拆成参数传给扩散模型,生成具体的内容。 第二,未来3年推理侧的算力订单增长,至少一半来自扩散模型的需求。之前那些追着大模型训练侧算力跑的芯片厂商,现在得赶紧调整方向。大模型的训练竞赛已经进入收尾阶段,但是端侧、工业侧的扩散模型推理需求才刚起来——智能汽车的实时场景渲染、工业设计的实时生成、医疗影像的辅助诊断,这些场景都要求低延迟的本地推理,根本不会把敏感数据传到云端。 第三,相关的治理规则会在2-3年内落地,不会一直处于灰色地带。比如以后所有商用扩散模型生成的内容,必须加肉眼不可见的隐形水印,只要是AI生成的内容,平台必须能识别溯源。另外,训练集的版权分成机制也会慢慢跑通,不然靠原创吃饭的摄影师、插画师,根本没法在这个生态里活下去。 上周又去了那个南京的茶社。上次拍桌子的芯片创始人,现在已经把团队一半的研发精力,转去做扩散模型的推理加速卡了。 他说之前总觉得要追着最火的概念跑,现在才反应过来。 真正能赚长期钱的,从来不是站在聚光灯下的那个主角,是给所有跑在概念背后的发动机做零件的人。作者|fawen
排版|fawen
审核|满满