 大讲堂

别被神化了:Transformer的本质根本不是”万能”
说穿了。 它就是个能同时算清所有输入元素之间关联权重的计算器。 当年RNN和LSTM的问题是什么?你读一篇长文章,得顺着句子从第一个字读到最后一个字,前面的信息传到后面的时候,早就被层层衰减磨得只剩个模糊影子,就像你让一个人站在队伍最后传悄悄话,传到队首的时候早就把”晚上吃火锅”改成了”晚上打火锅”。 Transformer跳开了这个顺序传递的逻辑。自注意力机制的核心逻辑,就是把所有输入的元素——不管是文本里的单词、图片里的像素块,还是音频里的采样点——全部摊开在同一个平面上,一次性计算任意两个元素之间的关联强度,哪个元素对理解当前内容的贡献大,就给哪个元素更高的权重。
现在的产业链,已经绕不开Transformer了
从2018年BERT模型发布,到2022年ChatGPT把Transformer的规模拉到千亿参数,整个全球AI产业链的分工,已经完全顺着Transformer的技术需求重排了。 上游是算力。原来英伟达的高端GPU主要卖给做图形渲染的游戏公司、做基础科研的超算中心,现在一半以上的H100订单,全是给跑Transformer大模型的厂商的。公开能查到的信息是,单跑一个700亿参数Transformer模型的全量微调,占用的算力相当于一个普通三口之家10年的用电量。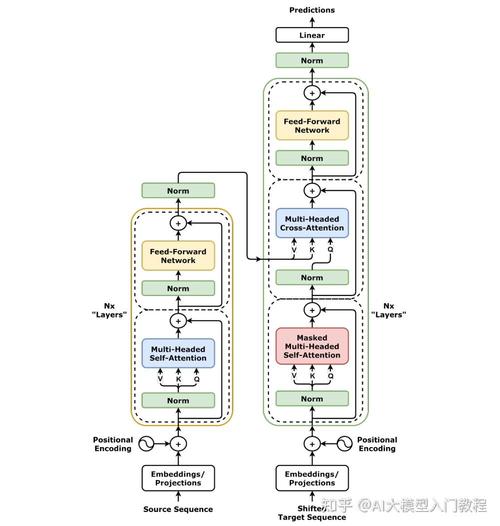
热闹背后的隐忧,从来不是技术本身
算力集中带来的行业准入门槛,是第一个绕不开的问题。现在能跑得起千亿参数Transformer模型的厂商,全球数得过来的也就那么十几家,原来AI领域那种”小团队靠一个创新算法就能颠覆行业”的时代,基本已经结束了——你没有几万张GPU的集群,连模型训练的入场券都拿不到。 第二个问题是数据的来源。Transformer是个靠数据喂大的孩子,现在全球互联网上的公开高质量文本,已经快被这些大模型吃干榨净了。接下来要找新的训练数据,就得爬版权内容、爬用户的隐私数据,这里面的版权纠纷已经打了好几轮了——之前有作家集体起诉OpenAI,说它未经授权把自己的书喂给模型训练,这个案子现在还没判,但背后的问题是,整个Transformer的技术迭代,现在是建立在对海量内容的无偿征用之上的。 还有个容易被忽略的问题,就是大家现在对Transformer的能力预期已经走偏了。很多人觉得只要模型规模够大,它就能自动学会逻辑、学会推理、学会像人一样思考,但实际上到今天为止,Transformer还是那个”读过整个互联网的超级接梗王”,你抛个开头,它能顺着所有见过的上下文给你接出最顺的后半句,但你要问它接的这句话到底符不符合现实逻辑,它真没数。 很容易踩坑。3到5年的判断:别等AGI,先看落地的真机会
未来3年,大参数的通用Transformer模型不会是主流的落地形态。反而会是各种轻量化、垂直领域的小参数Transformer模型,比如专门做法律文书审查的、专门做工业设备故障诊断的、专门做临床病历整理的,参数量可能只有几十亿,但是在特定场景下的效果比千亿参数的通用模型还好,成本还只有百分之一。 垂直领域轻量化模型的普及,会把AI的应用门槛拉到前所未有的低。现在很多中小企业用不起大模型,是因为调用一次API的成本太高,等这些小模型成熟之后,同样的功能,成本能降到原来的十分之一甚至百分之一,小餐馆、小加工厂都能用上适合自己的AI工具。 第二个判断是,算力的成本会快速下降。现在大家用的Transformer模型,都是基于FP16的精度跑的,接下来量化、剪枝的技术成熟之后,同样的模型能在消费级的GPU、甚至手机芯片上跑,到时候根本不用把数据传到云端,本地就能跑——比如你手机上的语音助手,下次更新的时候,核心就是个几亿参数的轻量化Transformer,不用联网就能帮你写邮件、整理备忘录。 第三个判断是,治理的规则会慢慢跟上。比如未来会有明确的规定,哪些数据能用来训练Transformer模型,训练出来的模型输出的内容要是侵权了,责任是谁的,不会像现在这样处于灰色地带。毕竟一个技术如果要真正普及,不可能永远靠打擦边球往前走。 上次那个乌镇碰到的老工程师,现在在公司牵头做一个轻量化的Transformer工业质检模型,他说现在再也不跟人吹什么AGI了,就想着把车间里的质检准确率再提1个点,能帮工厂少出点次品,就比什么概念都强。 技术从来都是这样。作者|大讲堂
排版|大讲堂
审核|阿辰