 大讲堂

开标现场的报价崩盘
2026年3月,苏州相城某汽车Tier1零部件园的公开开标场。我蹲在角落数投标报价。
原来做了五年机器视觉缺陷检测的本地厂商,上次同类型项目中标价122万,这次直接报71万。
全场哗然。
我当时以为他们是为了抢项目赔本赚吆喝,结果跟旁边坐的品控总监唠了半小时才搞明白——根本不是赔本。去年这个厂商给园区里的压铸件厂做单厂检测系统,报价里62万是帮客户攒缺陷标注样本的服务费,占了总价一半还多。按照工厂标注员的人力成本,一个熟练标注员一天能标800张金属压铸件缺陷图,10个标注员攒够10万张有效样本要整整4个月,人力成本约18万,而这类裂纹缺陷每出现一次就是320元的报废损失,攒1万张裂纹样本对应的报废成本就超过300万,比整套检测系统的硬件报价还高两倍。
这次客户的招标文件里,明明白白写了一条:投标系统必须支持跨厂联邦训练接口,允许园区内同工艺的三家压铸件厂联合训练检测模型,所有原始缺陷数据不允许导出工厂内网。
算笔账就懂了。
三家厂凑起来,每个厂只要出2万张自己攒的日常检测样本,总样本量刚好凑够10万张,原来要300多万的报废成本直接摊成三分之一,每个厂攒样本的成本从18万降到4万不到。那个之前收62万标注服务费的厂商,现在根本没理由收这个钱——客户自己凑的样本,他只需要把联邦交互的接口做通,剩下的模型训练是大家一起算的。
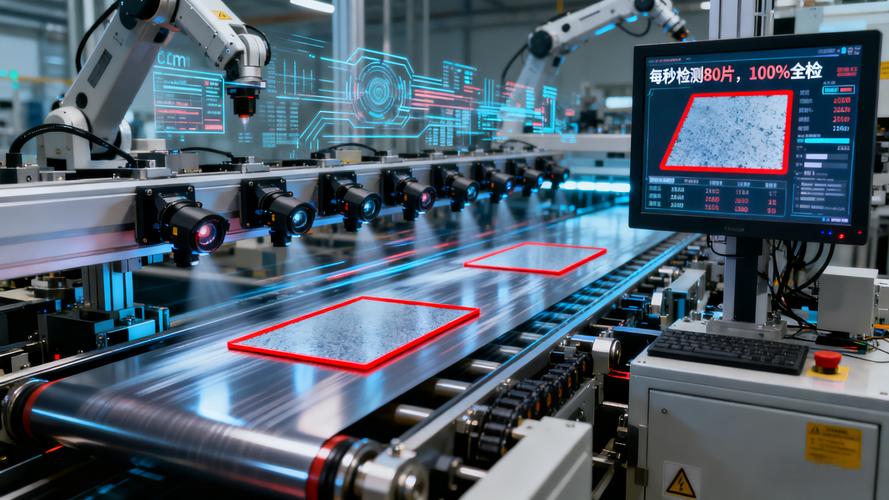
那个厂商的销售在现场脸都绿了。他之前跟客户谈了三个月,把自己家的模型准确率吹到99.2%,结果客户问他“你这系统能不能跟隔壁两个厂的模型打通?不能的话,我为什么要花120万买你那套单厂模型?等我攒够样本,人家的良率已经比我高3个点了,订单都抢光了。”
没人买账。
被误解的技术本质
之前所有媒体对联邦学习的叙事,全绕在“隐私合规”“数据安全”上,说这是互联网大厂为了合规搞出来的技术,能让数据不出域就能联合建模。全错。
在产业一线,这根本不是什么合规工具,是实打实的成本分摊工具。
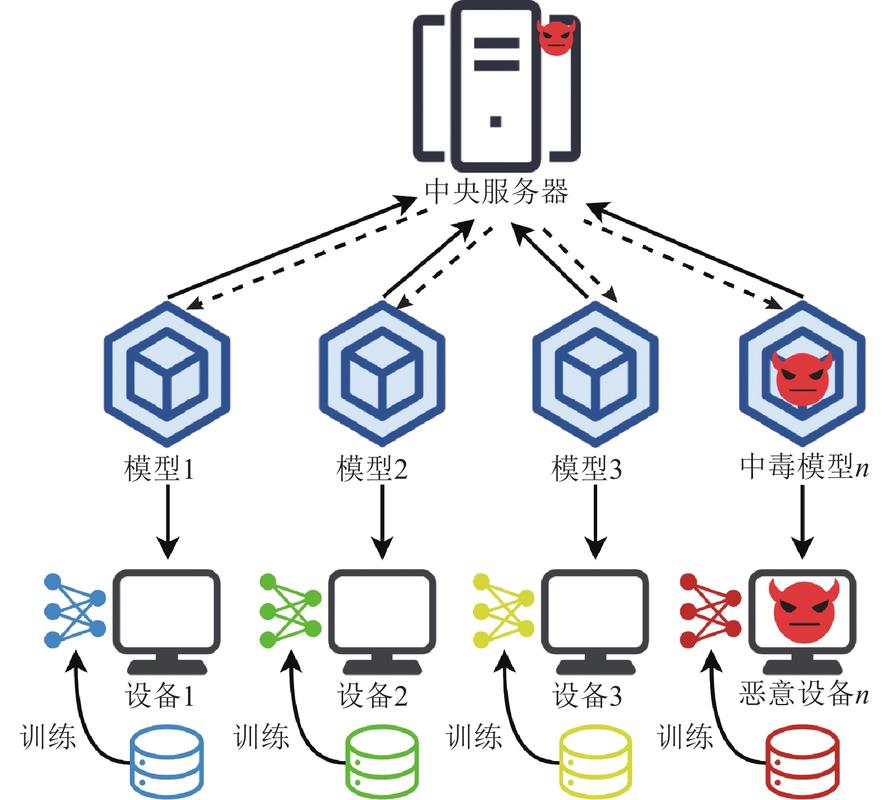
拿深圳微众银行的FATE框架举例子。他们2025年开始给珠三角的五金电镀厂做落地项目,之前每个电镀厂自己做环保排放预测模型,要攒整整两年的排放监测数据,因为每个厂的镀液配方、生产线速度都不一样,单厂攒的样本量太少,模型准确率只有62%,经常被环保系统预警,一预警就要停产排查,一次停产的订单损失就是22万。
原来单厂部署环保排放预测模型,要配一套带A100显卡的服务器,硬件成本28万。
现在三个相邻的电镀厂凑到一起,用FATE的框架做联合训练,每个厂的监测数据存在自己的环保站服务器里,只把模型训练的梯度参数传去公共节点,不碰原始数据,最后模型准确率直接拉到89%,每个厂每年因为预警停产的次数从11次降到2次,单厂每年减少损失120万。三个厂摊下来,一年给微众的服务费才30万,算下来投资回报率超过1:12。
这套逻辑跟南方农村早年的联合育种一模一样:原来每个农户在自家自留地里选种,攒三年的种子,抗稻瘟病的能力还是上不去,因为单块田的病虫害类型就那几种,选出来的种子基因多样性太差。现在大家把各自田里的育种材料凑到一起,不把自家的种子拿出去,只交换选种的性状参数,最后选出来的抗稻瘟病品种,比单户选的产量高40%,成本还摊到了每一户头上。
那谁在亏?
那些之前囤了大量工业公开数据集的厂商。
之前他们的生意逻辑是,攒一堆各个行业的标注数据集,卖给单厂做模型训练,一套数据集卖几十万。现在客户根本不买了——别人厂的工艺参数、生产环境跟自己厂根本对不上,把别人的数据集混进自己的模型里,反而会把良率拉低。去年广州有个做工业数据集的公司,本来2025年要冲北交所,年末盘库的时候发现之前囤的4700万数据集全砸手里,客户要么用自己厂的样本凑联邦节点,要么直接买开源的数据集,根本没人买他们的闭源数据集,最后提了4200万的存货跌价准备,IPO直接撤了。
真的。
牌桌上的站位洗牌
现在长三角、珠三角的工业园区,2026年的园区准入标准里,已经把支持跨节点联邦训练接口列为工业AI系统的强制准入项。原来那些靠封闭私有协议、攥着自己的系统不让跟别家通的厂商,现在连进园区投标的资格都没有。
我上个月跑佛山的家具产业园,碰到原来做家具表面缺陷检测的老板,去年还跟我吹自己的系统准确率98%,是园区里的独家供应商,今年开春就带着团队到处找能改联邦接口的工程师,开的工资比去年翻了2.3倍,还是招不到合适的人。他之前的团队全是做单厂模型优化的,根本不知道跨节点训练的时候,不同厂的工艺参数偏差要怎么校准,总不能把三个厂的模型参数瞎凑到一起,最后把检测准确率搞到不及格。
普通从业者的变化更直接。
原来工厂里的标注团队,10个人的团队一个月人力成本6万,现在因为跨厂凑样本,需要的标注量是原来的五分之一,原来的标注员要么被裁,要么转岗去做联邦节点的工艺参数校准——这个岗位不需要你会标图,需要你懂不同厂的生产线参数,知道哪个厂的样本因为镀液浓度不对,会导致模型参数飘了,现在这个岗位的工资是原来标注员的两倍还多。
谁在扩产?
原来做工业网关的厂商。现在要让不同厂的系统能通联邦接口,就需要在每个厂的工控机旁边装一个专门的加密网关,把传出去的模型参数加密,防止原始数据被扒出来。去年整个华东的工业网关厂商,联邦接口相关的订单占比从2024年的3%涨到了2026年第一季度的47%,产能直接拉满。
谁在挣扎?
之前靠给单厂做模型维保赚钱的集成商。原来的模式是,给客户装一套封闭系统,每年收20%的维保费用,现在客户要跨厂凑模型,你这个封闭系统根本接不进去,维保合同自然就黄了。我认识的一个集成商,2025年一年签了1200万的维保合同,2026年开春续了不到100万,剩下的客户全换了支持联邦接口的系统。
说实话,我之前听太多人吹联邦学习是“下一代人工智能的核心方向”“隐私计算的黄金赛道”,跑了两年现场才发现,这东西根本没那么玄乎。
就是工厂老板凑在一起,把原来单家扛的成本,摊到大家头上而已。
那那些靠这个概念融了三轮、估值几十亿的创业公司,现在手里的账,算得过来吗?
作者|大讲堂
排版|大讲堂
审核|满满