 大讲堂

2017年扔在arXiv上的那篇《Attention Is All You Need》,当时没几个人意识到,这堆写着自注意力逻辑的公式,会把全球科技产业的运行节奏掀得底朝天。
真的离谱。
六年后回头看,不管是OpenAI靠GPT系列撬走了硅谷近三成的早期风投资金,还是国内大模型厂商挤破头抢算力卡产能,甚至连传统制造车间的质检系统都开始蹭Transformer的技术热度,这东西早就不是NLP领域的专属工具了。它现在是整个生成式AI浪潮的技术底座,没有之一。
先把技术边界说透:别把Transformer神化成万能膏药
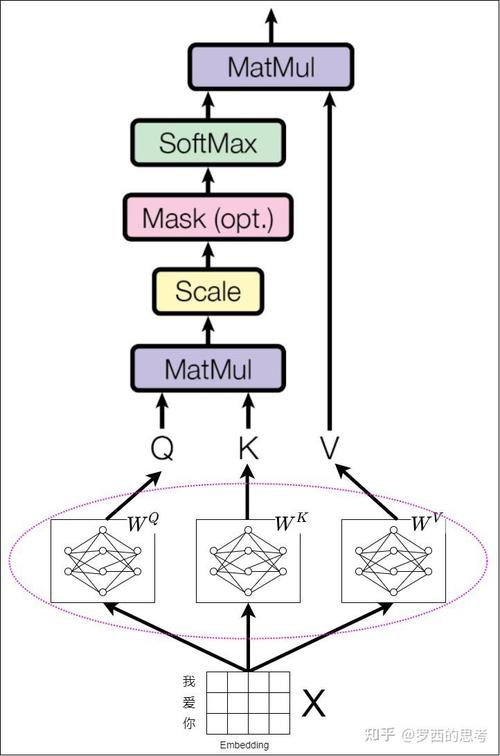
很多行业分析吹得太玄,把Transformer说成通往通用人工智能的唯一路径,其实根本没说清它的核心逻辑到底是什么。说白了,它的核心就是自注意力机制——计算输入序列里每个元素和其他所有元素的关联权重,给每个词、每个像素、甚至每段工业传感器的时序数据,自动匹配和当前判断最相关的信息片段,彻底跳过了之前RNN架构必须顺着序列逐字、逐帧计算的低效流程,并行度一下拉满,训练效率提了好几个数量级。
但很多人刻意回避它的天生短板。从设计第一天起,Transformer本质就是统计关联的拟合工具,没有真正的形式逻辑推理能力,训练数据里没覆盖到的知识组合,哪怕逻辑上再通顺,它也可能输出完全离谱的结果。说个真实的经历,去年找某头部大模型算一道初中几何证明题,它把所有已知条件抄得一字不差,最后结论写个“三角形内角和为360度”,你说气不气。
更有意思的是行业里曾经迷信的参数规模神话。前几年大家拼了命堆参数,从10亿到百亿再到千亿,以为参数越大模型越聪明,现在行业内部早就摸透了:当训练数据的质量没跟上,参数规模的边际收益拐点在千亿级就已经出现,再往上堆,不仅能力提升有限,甚至会出现“模型越大幻觉越严重”的奇怪现象——毕竟模型见过的低质内容太多,反而会把噪音当成规律学进去。
产业链的真实现状:算力、数据、应用的三层扭曲
现在围绕Transformer形成的产业链,早就不是技术圈的自嗨了,但三层环节的价值分配,歪得离谱。
最上层的算力环节,现在是绝对的卖方市场。英伟达的H100、H800成了全球科技公司的硬通货,这真不是段子——去年长三角某大模型团队为了赶项目节点,直接开车去东莞的电子城扫货,把渠道里压了半年的H800库存全拉走,价格比官方指导价高了近两成。整个算力环节的利润,现在占了Transformer相关产业总利润的六成以上,其他环节的玩家,本质上是在给芯片厂商打工。
中间的数据环节,是大家喊得最凶、实际质量最差的部分。九成以上的厂商在发布会上说自己有PB级的训练数据,扒开看一半是网上爬的公开文本,剩下的要么是没经过清洗的噪音,要么是重复搬运的低价值内容。真正有领域知识密度的私有数据——比如医院的诊疗记录、制造企业的工艺参数、金融机构的交易明细——现在成了比算力还稀缺的资源,很多厂商拿着几千万的算力预算,根本买不到匹配质量的训练素材。
最下层的应用环节,更是充满了“穿新鞋走老路”的魔幻感。很多To B的解决方案,号称用Transformer做了定制化大模型,实际就是接个通用大模型的API,套个企业logo的皮肤,根本没结合客户的真实业务流程。之前看到某制造企业的质检方案,号称用Transformer做表面缺陷识别,结果连车间光照波动带来的图像干扰都没做适配,上线一周识别准确率掉了40%,最后还是得靠老质检工补位。
不过话说回来,也不是全行业都在瞎搞。真正跑通商业闭环的案例,现在已经能看到轮廓:某头部电商平台用Transformer重构用户行为序列预测模型,把原来的推荐点击率提升了近20%——它能同时捕捉用户半年前的浏览记录、当下的搜索意图、甚至同时间段的平台活动节奏,这是之前的协同过滤算法根本做不到的。还有新势力车企的BEV感知方案,核心就是Transformer架构,能把车载多个摄像头的图像信息融合成统一的三维空间感知结果,比传统视觉方案的障碍物识别准确率高了一大截,现在已经成了中高阶智能驾驶的标配。
别回避的隐性成本:Transformer不是没有社会代价的
谈技术的时候大家都在说收益,很少有人提它带来的实实在在的风险。
首先是幻觉问题带来的现实冲击。现在越来越多的内容平台、客服系统开始用Transformer生成内容,如果没有严格的审核机制,随便编个虚假的财经信息、误导性的医疗建议,传播出去的代价是普通用户根本扛不住的。之前就有某内容平台靠Transformer自动生成的财经短文,把某上市公司的业绩增速写错了10倍,直接导致当天开盘股价波动超过5%,最后平台花了好大精力才把舆情压下去。
然后是绕不开的版权争议。现在的大模型训练阶段,爬取了全网的文本、图片、视频内容,根本没找原作者谈授权,国外已经有作家、摄影师集体起诉OpenAI的判例,国内这块的规则还没完全落地,迟早要变成整个行业的合规包袱。
最容易被忽略的是能耗问题。之前有公开的行业测算,训练一次千亿级的Transformer模型,耗电量差不多相当于一个普通家庭一整年的用电总量。现在全球几十家厂商挤着训大模型,很多明明手里的业务根本不需要千亿参数的模型,非要凑个热点新闻说自己训了万亿参数的版本,烧了几千万的算力成本,最后落地的时候还是用的最小的蒸馏版本,纯粹是浪费资源。
再过3到5年回头看,Transformer这个技术本身,大概率会从“行业风口”变成像现在的云计算、移动互联网一样的通用基础设施,不会再有人把它当成什么新鲜概念来炒作。
首先,现在热火朝天的参数竞赛肯定会停下来。大家的注意力会从“我能训多大的模型”转到“我能把模型在垂直场景跑得多便宜、多准”,端侧部署会成为主流方向——不用每次都把数据传到云端的大模型集群算,把经过蒸馏的小模型装在手机、智能家居、甚至工业传感器里,响应速度更快,隐私性也更好。现在已经有手机厂商在新机型里集成了端侧的Transformer模型,能直接在本地帮用户整理相册、写会议纪要,不用把照片、文字传到云端。
其次,产业链的利润分配会彻底重构。现在最赚钱的是卖算力的芯片厂商,以后真正的高价值环节,会转到手里有高质量私有数据、能把Transformer和具体业务流程深度结合的应用厂商手里,那些只会套壳、没有核心技术能力的中间商,会被快速挤出市场。
最后,治理规则会慢慢跟上。不管是训练数据的版权溯源要求、模型生成内容的强制标识规则,还是高能耗大模型项目的审批机制,这些不会等技术完全成熟了再出台,现在已经在陆续推出相关的行业标准和征求意见稿。
技术从来不是中立的。
当年写《Attention Is All You Need》的那批作者,一开始只是想解决机器翻译的效率问题,没人想到这套架构会变成撬动全球产业格局的杠杆。但历史就是这样,很多改变世界的技术,一开始的目标都朴素得要命。
作者|大讲堂
排版|大讲堂
审核|乐乐