2026-10-13 19:42:56 作者:大讲堂
凌晨两点十七分,阿柚的冰美式顺着键盘缝流到屏幕上,刚好蹭花了表格里标红的三行权重值。那是她给外婆搭的专属对话模型,攒了三个月的参数。她盯着那片棕褐色的咖啡渍,骂了句脏话。凌晨两点的出租屋,咖啡渍蹭在注意力权重表上
出租屋在老小区的顶楼,空调外机嗡嗡震得窗玻璃发颤。她本来是未来科技城某大模型团队的算法工程师,日常工作就是给核心层的注意力模块调参,上班的时候要对着几百页的公式推导,要跟产品经理掰扯为什么推荐流的点击率涨了2个点,要应付各个行业的客户问“你们这个注意力模型到底能给我带来多少转化”。没人知道她下班之后,会在自己的旧笔记本电脑上偷偷跑一个只有几百兆参数的小模型。训练数据全是她这两年用手机录的家里的细碎片段:外婆坐在院门口摘菜的声音,妈妈在厨房喊人吃饭的语气,梅干菜扣肉蒸好之后飘出来的香气对应的温度,甚至还有她自己小时候在外婆家偷拿糖吃,被外婆抓包的那段模糊的记忆。之前她总跟组里的实习生解释,别一上来就背“注意力机制是对输入序列的每个 token 分配不同权重值”的课本定义,用户听不懂的。说白了,就是你跟人聊天的时候,不会把对方说的每个字都用一样的力气去记。比如外婆拉着你的手说“我昨天在巷口碰到张阿婆,她给我塞了一把糖,就是你小时候最爱吃的那种橘子硬糖,纸是透明的,裹着金闪闪的边”,你的大脑会自动把“橘子硬糖”“你小时候”这几个片段的记忆权重拉到最高,剩下的“巷口”“张阿婆”“透明糖纸”这些,就安安静静当背景板待着,不用费神去记。太对了。你甚至不会特意去数这句话一共说了多少个分句,你的注意力自动就会锚定在那些和你情绪挂钩的节点上,剩下的信息不会抢戏,也不会被完全丢掉。
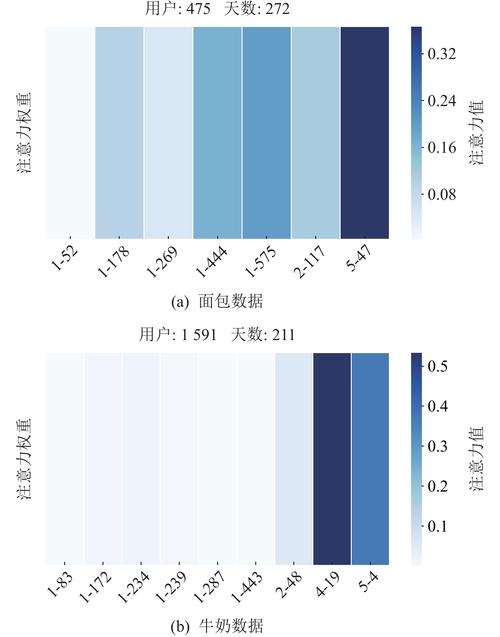 人工标注的注意力权重热力图 对话场景
她之前总觉得,上班调的那些参数,离“真正的注意力”差得远。直到去年外婆确诊了轻度阿尔茨海默,刚开始只是忘事,后来慢慢把她认成了小时候的邻居,拉着她的手说“你怎么还不回家吃饭,你妈在巷口喊你呢”。她坐在外婆家的小板凳上,看着外婆皱着眉头努力想认出她的样子,突然反应过来——外婆的大脑现在就是十年前那种没有注意力机制的老模型。所有的记忆都糊成一团,没有办法把“现在站在面前的27岁的外孙女”和“记忆里扎羊角辫的小丫头”这两个节点的权重对应上,所有信息都被平均分配重量,所以才会张冠李戴,把人认错。
我们对注意力机制的误解,全是从发布会的PPT里来的
去年行业开大会,阿柚跟同事凑了热闹去听。台上穿定制西装的专家放着炫酷的动图,说注意力机制是人类给AI装上的“灵魂”,实现了跨模态的认知跃迁,能看懂图片能写文章,甚至能像人一样思考。阿柚当时在底下啃肉包,差点把馅喷出来。啥认知跃迁啊。说穿了,最早这个机制刚被发明出来的时候,就是那帮做机器翻译的工程师被搞烦了。之前的老翻译模型,要把一长段输入序列从头到尾编码成一个固定长度的向量,句子稍微长一点,前面的信息就会被后面的信息挤得没地方放,翻译出来的东西前言不搭后语,就像你听人讲半小时的话,刚要张嘴接话,人家说的第一句你已经忘了。注意力机制就是给每个输入的token开了个临时窗口,不用把所有信息都硬塞进那个固定大小的向量里,哪个片段和当前要处理的内容相关,就把哪个片段的权重拉高一点,剩下的就放低一点,就这么简单。
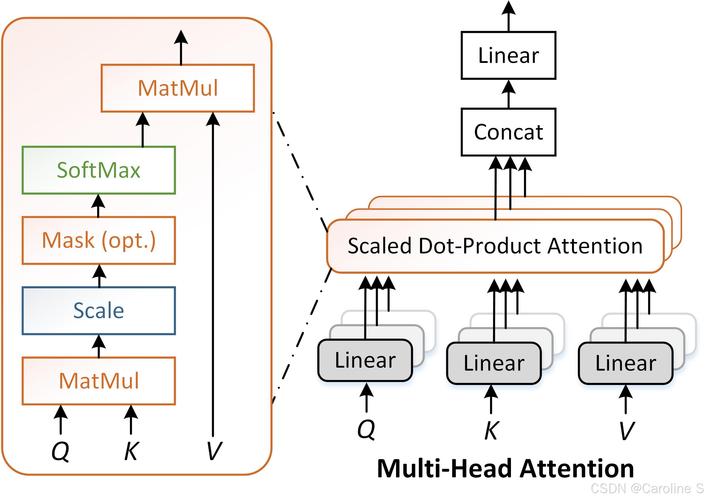 Transformer注意力机制计算流程手绘草图
不过话说回来,为什么现在所有人都把它吹得神乎其神?因为资本需要故事。你跟客户说“我们这个模型就是给每个字算个权重”,客户会觉得你在骗钱;但你跟客户说“我们的模型拥有类人的注意力能力”,合同一下就能签八位数。阿柚说她之前也差点被这些故事绕进去,直到上次陪外婆去做认知评估。医生给外婆出了一道题,让她从100开始连续减7,减五次。外婆算到第三个7就卡壳了,坐在诊室里抠衣角,像个被老师批评的小学生。那会她突然反应过来,我们之前对注意力的理解全歪了:我们总觉得注意力就是要把所有无关的信息全部屏蔽掉,盯着目标死磕,能长时间集中精神不跑神才是厉害的。可外婆的状态根本不是“专注力差”,她是没办法把那些细碎的、和她在乎的人相关的记忆,稳稳地抓在手里——她的注意力被那些乱糟糟的、没有权重区分的信息搅成了一团浆糊。
最好的注意力,从来都不是盯着目标死磕
 最好的注意力,从来都不是盯着目标死磕
之前阿柚在团队里提过一次,说能不能把推荐流里的用户注意力权重调低一点,别用户刚停留三秒,就拼了命给人推同类内容,最后把用户刷得累到眼睛发花,连本来想找什么都忘了。组里的产品经理当时眼睛都瞪圆了,说这是把到手的流量往外推啊,KPI怎么办。她自己有次周末想给外婆买之前常吃的那种软糕,打开购物APP,首页全是之前她刷到过的老人鞋、助听器,翻了二十分钟越翻越气,最后直接把APP卸了,骑了三公里的电动车去老巷口的店里买。风刮得她耳朵生疼,她那会突然想通了一个道理:注意力机制从来不是为了帮人把无关的信息全部屏蔽掉。我们现在被算法训练得,总觉得“高效的注意力”就是要心无旁骛,把所有和目标无关的东西全部推开,刷短视频的时候要连看两小时不带停的,上班的时候要四小时不看手机才叫专注力。可真实的人的注意力根本不是这样的啊。你陪外婆坐在院子里晒太阳的时候,你不会把所有的注意力都死盯着外婆的脸,你会听到远处卖冰棍的铃铛声,会闻到墙根下飘过来的茉莉花香,会注意到外婆手背上的老年斑又多了一块,会想起去年夏天外婆给你切的那块冰西瓜的甜味。这些信息从来不是什么需要被屏蔽的“噪音”,它们本来就该安安静静待在你的注意力范围里,不用你费力气去抓,自己就会浮上来。所以她给外婆搭的那个小模型,反着来调参数。别的模型都是把高权重分给那些能吸引用户停留的、能带来转化的内容,她把那些看起来毫无商业价值的细碎记忆的权重拉得最高:比如外婆蒸梅干菜扣肉的时候,一定要把浮在表面的油撇掉一半,不然吃了会反酸;比如外婆晒太阳的时候总喜欢把左脚的裤腿挽起来,去年摔跤留下的脚踝一受凉就疼;比如外婆听到“橘子硬糖”这四个字的时候,眼睛会一下子亮起来。那些在大模型的权重表里本来要被当成“低价值噪音”过滤掉的细节,全被她标成了最高优先级。上周她带着那个旧笔记本去看外婆,把平板放在外婆旁边的石桌上。外婆刚开始还是认不出她,坐在那里搓着手看院子里的鸡跑。平板里的声音慢慢响起来,不是什么机械的合成音,是她自己录的、模仿妈妈的语气说的:“阿婆,今天太阳好,我们等下蒸一碗梅干菜扣肉好不好?要撇掉一半油哦。”外婆突然转过头,盯着她看了半天,伸出皱巴巴的手,摸了摸她的刘海。“你小时候偷拿糖吃,把糖纸藏在枕头底下,我都看到了。”风卷着一朵茉莉花瓣落在平板屏幕上,她盯着那个权重表,看到“橘子硬糖”那栏的数值悄悄跳了一下,比之前高了0.03。她突然觉得,之前在会议室里跟人吵了那么久,说注意力机制到底是用来抢用户的停留时长,还是用来帮人留住那些快要散掉的记忆——根本没有什么标准答案。那些被大模型当成噪音过滤掉的细碎记忆,才是我们真正活着的证据啊。
免责声明:市场有风险,选择需谨慎!此文仅供参考,不作买卖依据。如有侵权请联系删除。
文章名称:你记不住的细碎小事,注意力机制都替你攒着
文章链接:https://www.lfdjt.com/info_23_25639.html
 大讲堂
