 大讲堂

今年三月跟深圳一家做行业大模型的创始人吃饭,酒过三巡他把手机拍我脸上。后台截图停着三个训练任务,红字标着「等待节点分配」。
他说,等了三天了。本来要赶六月份的行业展会发版,现在IDC说给不出整柜的GPU,零散节点拼起来的话,通信延迟扛不住,分布式训练跑不起来。愿意加三成租金都不行。
疯了。
放在四五年前,谁能想到分布式训练会变成卷到这个程度的生意。那时候大家聊起来,还只是大厂实验室里的玩物,千亿参数模型,堆几百块卡跑个把月,发个论文吹吹水。
抢不到GPU机柜的2026
现在呢?连做一个十万token的垂直领域微调,都要扯分布式。因为单卡已经塞不下越来越大的基座模型了。
我翻了一下IDC圈的报价,说实话吓一跳。单张A100的闲置时段租金,去年Q3还是三块钱一小时,今年Q1直接干到十二块。翻了三倍。一家做医疗大模型的朋友算过,现在训练一次1T标注临床语料,成本直接从八十万涨到两百万出头——这差不多相当于西部一个县级市全年教育系统的信息化预算,就这么一次训练烧完了。
很多人说,那不就是缺GPU嘛,多产点卡不就行了?不对。问题根本不是缺卡,是缺能放卡、能连起来的地方,缺能把分布式训练跑顺的节点。
你以为大厂手里卡多吗?字节去年采购的八万块H100,一大半绑在已经跑起来的推理任务上,要抽出来做训练,得停 inference ,损失的流量钱比租金还贵。所以现在大家都在抢市面上的零散闲置卡,拼起来做分布式训练。
有人囤卡炒价格,有人拿闲置卡拼池子赚快钱,去年下半年光是珠三角,就冒出来三十多家做分布式算力租赁的小公司,赚的比做模型还多。
这不就是抢地盘吗?原来IDC的地盘是头部厂商包圆,现在零散的小机房的闲置卡,变成了香饽饽。
缝起来的算力,打碎的格局
不过话说回来,分布式训练的核心,大家都搞错了方向。所有人都在说“更大集群、更低延迟”,我倒觉得这个方向走偏了。
你看国内厂商的玩法,字节跳动的BytePS早在四五年前就开源了,现在火山引擎拿这套做分布式算力池,就是把各个机房散的GPU,用软件层的拓扑优化把通信损耗压下来,不是靠砸钱换最贵的InfiniBand网卡。
这里有个很有意思的数据:万兆以太网的端到端延迟比InfiniBand高17倍,但成本只有InfiniBand方案的十分之一,跑分布式训练出来的模型,最终精度误差只高不到2个百分点。你说对于百分之九十的垂直领域大模型,这两个点的误差影响什么?啥也不影响,但是成本省了一大半,中小厂商用脚投票选这个。
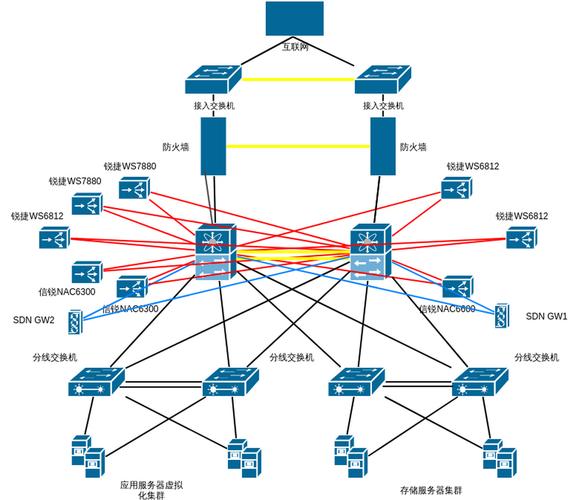
这个事儿像什么?像二战时候的阵地战对游击战。头部大厂砸几千亿建超级算力中心,那是阵地战,摆开架势跟你硬刚,所有卡都集中在一块儿,通信效率拉满,训练万亿参数基座。但是中小厂商玩不起阵地战,就打游击战,把散落各地的闲置卡攒起来,凑成一个分布式集群,能跑起来就能做微调做行业模型,成本只有十分之一。
原来的算力格局,是头部IDC和头部云厂商垄断了好的位置好的带宽,所有做模型的都得从他们手里买算力,定价权完全在人家手里。现在分布式训练的软件技术成熟了,相当于把原来垄断的算力盘子给打碎了,缝起来就能用。
去年火山引擎给我看了一组数据,他们的分布式闲池,帮中小厂商把训练成本降了42%,一半以上的节点都是来自第三方小IDC的闲置GPU,原来这些卡要么空着跑挖矿,要么只能给小公司做推理,现在能拿来做训练,赚的钱比原来多三倍。
华为这边也在推昇腾的分布式训练框架,把全国两百多个节点的昇腾卡连起来,中小厂商随时可以调,不用自己买卡囤卡。说白了,就是原来的地盘已经被重新划分了,原来握在少数人手里的算力,现在散出去了。
每个从业者都要改的作业
别觉得分布式训练只是大厂技术专家或者IDC老板的事儿,跟普通从业者没关系,完全不是。
我上个月见一个百度出来的算法工程师,原来在百度做文心一言的调参,出来创业做电商大模型,原来他找工作的时候,简历上只要写“精通大模型调参”就能拿三十万以上年薪,现在出去面试,第一句就问你“会不会做模型并行拆分,会不会做分布式节点调度”,不会的话薪资直接砍十万。
这就是变化。原来做算法,你只需要对着现成的整集群改改参数,调调prompt,现在你得自己算,哪块模型放哪个节点,什么时候抢闲时算力,怎么把通信损耗压下来,不然你的成本就比竞争对手高一大截,根本活不下来。
对于产业链上的小玩家更是这样,原来小IDC在珠三角长三角一大堆,根本抢不过头部云的整柜订单,只能接点小客户的托管,赚点辛苦钱,现在好了,你的闲置卡只要能连上网,就能进分布式算力池,别人拿你的卡做训练,给你分账,一年多赚几百万,比你原来做托管赚的多太多。
原来很多做芯片设计的小公司,自己买了一堆GPU做仿真,平时大部分时间都是闲置的,现在把闲置时间挂去分布式训练池子,一年下来,买卡的钱能赚回三分之一,这不香吗?
说白了,分布式训练不是把一堆卡堆在一起就完事儿了,是把整个产业链的闲置资源都拉出来重新分配,原来躺赚的玩家躺不住了,原来没机会的小玩家现在能上桌了。
当所有散落的闲置GPU都能被缝成一个可用的分布式训练集群,那些砸了几千亿砸超级算力中心的头部玩家,最后要靠什么赚回本钱?
作者|大讲堂
排版|大讲堂
审核|乐乐