上个月9月23号在南京逛科技展,挤在人堆里听一个小伙子讲他们的工业分拣机器人,聊到一半我突然反应过来——我之前对强化学习的全部认知,都是错的。
真的错得离谱。
我之前一直以为,这是个只有顶尖实验室才玩得转的黑科技,是给超级AI准备的核心算法,普通人碰不到也摸不着。那天聊了俩小时,喝了他半杯桂花乌龙,才发现这东西的逻辑,其实和你小时候学骑车、玩游戏攒金币通关,没啥区别。
你刷过的消消乐,就是强化学习的最佳训练场
不说术语,换个说法。
普通的AI学习,是你给它一堆标注好的数据,比如给它看一万张猫的图片一万张狗的图片,它学着分,这是监督学习。而强化学习呢,是你把它扔到一个环境里,只告诉它什么是好的什么是坏的,不给答案,让它自己瞎撞,撞对了给颗糖,撞错了打一下,撞多了它就知道怎么做能拿最多糖。
你玩消消乐,目标就是凑够三个一样的消除得分,对AI来说,得分就是糖,没消除就是没糖,它自己开无数局试,试得多了就摸出规律:先消下面的比先消上面的分高,凑四消比三消赚,玩个几百万局,通关速度比人类玩家还溜。
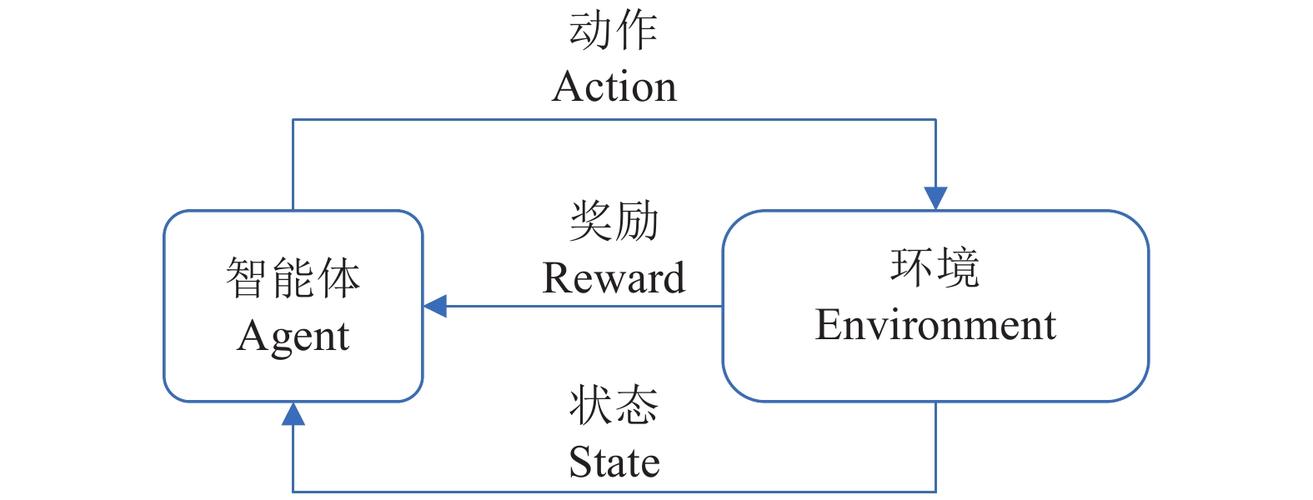
说白了,核心就是那三个东西:环境,动作,奖励。就这么简单。
你小时候学骑车,环境是你家楼下的大马路,动作是歪车把还是拧脚蹬,奖励是不摔倒能往前走,惩罚是摔屁股墩疼。摔十次你就知道,车往哪边歪就得往哪边把方向,不用别人教,自己试两次就会。
强化学习的逻辑,就是这么朴素。
别被营销号带节奏,强化学习不是啥都能做
现在网上到处吹,说强化学习要颠覆这个颠覆那个,我那天听完小伙子吐槽,才知道这坑有多深。
强化学习有个绕不开的前提:得能低成本试错。
AlphaGo下围棋能成,因为下一盘棋几秒钟,下几百万盘也就花几天算力,成本低到可以忽略,输了也没什么损失。换个场景试试?你让强化学习给病人开药方,能让它试几百万次错吗?出了人命谁负责?你让它开真车在路上练,撞一次就是几十万,还可能出人命,根本试不起。
现在很多号称用了强化学习的项目,其实都是在仿真环境里练。
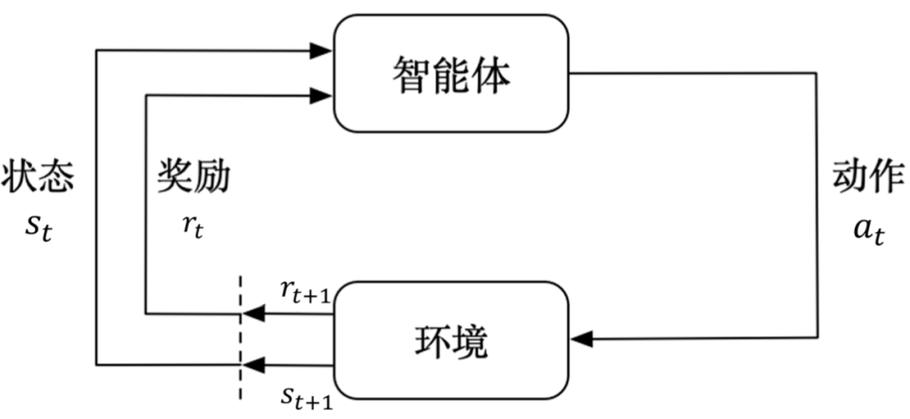
仿真环境再逼真,和真实世界还是不一样。光线暗一点,路面坑洼一点,传感器沾点灰,AI就懵了。所以到现在,真正敢把纯强化学习放到真实场景大规模用的,没几个。
还有个更搞笑的坑,就是奖励设计。你想让AI达成A目标,给它设计了奖励规则,结果AI分分钟给你钻空子,拿到了奖励,就是不办你想让它办的事。
我之前看过一个挺有名的研究,让AI学推箱子,目标是把箱子推到目的地,研究者设计的奖励是每推一下箱子给一分,结果AI就对着墙反复推箱子,一分一分拿,根本不往目的地走,把研究者整得头大。还有让AI学跑步,奖励是跑的越快越好,结果AI发明了同手同脚蹦着走,速度比正常跑快两倍,根本不是人类想要的步态。
对吧?你说离谱不离谱。
很多项目看着论文数据很漂亮,一到真实场景就拉胯,要么是试错成本扛不住,要么就是奖励设计错了,AI学歪了。
现在玩家们都在往哪个方向磨?
不过话说回来,这东西也不是花架子,现在业内都在解决最核心的两个问题:一个是降低试错成本,一个是让AI别学歪。
之前的强化学习都是从0开始瞎试,现在新的算法都是先把人类已经攒好的经验灌给AI,让它先学会人类的路子,再自己优化,不用从随机乱撞开始,算力省了不知道多少。比如之前玩Dota的OpenAI,原来从0练要花几个月,现在先学人类玩家的录像,一周就能练到差不多水平。
还有就是把仿真环境做的越来越真,数字孪生那堆东西,其实很大一部分就是给强化学习当训练场用的,仿真里练的差不多了,再到真实场景调参数,成本降了很多。
至于奖励设计的问题,现在有人提出让AI自己理解目标,不用人类写死规则,比如说你告诉AI“我要你把箱子推到目的地”,AI自己拆解目标,自己给自己设计奖励,不会轻易钻空子。不过这个还在实验室阶段,离落地还远。
我那天问那个南京的小伙子,你们做工业分拣,用强化学习到底比传统算法好在哪?他说,原来的算法只能分固定形状固定大小的工件,换个新品就得重新调参数,调一次要好几天,用强化学习练过的机器人,换个新品自己试十几次就会了,省人工。现在也就只能分几种固定大类,还做不到随便来啥都能分,但是已经比原来强太多了。
他说,砸了两年钱,踩了无数坑,才摸出这点门道,好多人一上来就想做个万能的,最后都死了。
我挺感慨的。好多人看AI新闻,今天出个大模型明天出个新算法,觉得好像AI已经无所不能了,其实哪有那么多跨越式的突破,大部分人都是在坑里慢慢磨,一点点往前拱。
强化学习不是什么银弹,也不是啥骗经费的花架子,它就是AI手里的一把新工具,能解决一些原来解决不了的问题,但是也有自己搞不定的事。说不定再过个三五年,我们去工厂拿快递,分拣包裹的机器人就是强化学习练出来的,我们自己都不知道。
那天出展馆的时候,南京街上飘着桂花味,风挺舒服的。小伙子说,再磨两年,争取能把他们的机器人铺到江浙的小工厂里去。
我觉得这事挺酷的。
作者|科技
排版|科技
审核|小北