2026-10-03 23:23:45
作者:
科技
早上蹲坑刷手机,随手让AI帮你改个文案;下午开策划会,丢给大模型几个关键词,十分钟出三版方案;晚上躺床上,让AI画张你想要的猫咪星空图发朋友圈。我们每天都在碰大模型,可你有没有停下来想过——大模型算法到底在算啥?很多科普讲得玄乎,要么堆一堆你看不懂的公式,要么上来就喊“改变世界”,听得人云里雾里。今天我就用普通人能听懂的话,掰扯清楚这件事。
别被百亿千亿参数吓住,它做的事情其实超简单
说实话,我第一次看到“千亿参数大模型”这个说法的时候,差点直接划走。参数?千亿?这得复杂成什么样啊。后来跟做算法的发小在南京喝啤酒,他三句话给我讲透了。
大模型算法从你输入文字到输出结果,核心就做一件事:根据已经出现的所有内容,算出来下一个字(或者像素、音符)概率最高的是什么。
就这么简单。
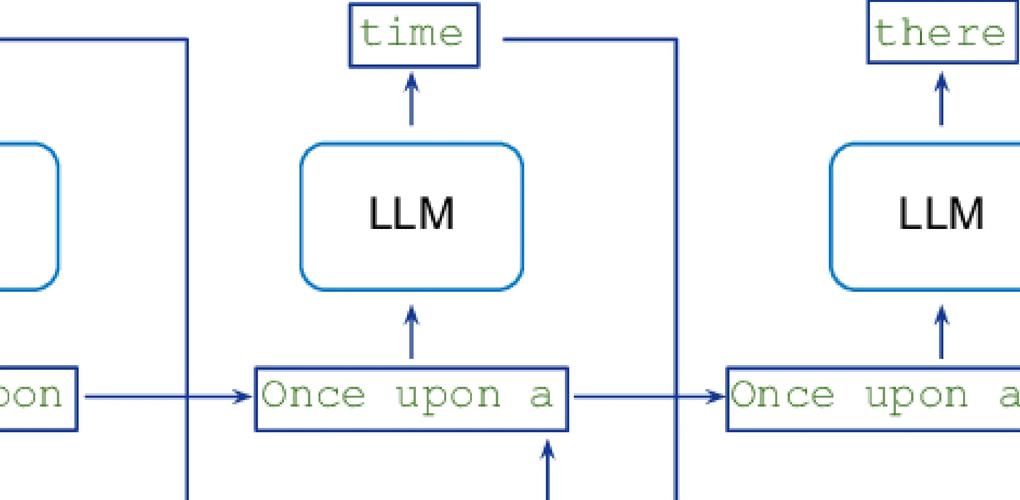 大模型自回归预测下一个词示意图
举个例子。你输入“南京秋天最好吃的是”,模型会把你已经输入的这十个字,挨个过一遍自己的参数,算出来每个汉字放在下一个位置的概率:“盐水鸭”的第一个字“盐”概率是62%,“桂花”的“桂”概率是18%,“螃蟹”的“螃”概率是11%,剩下乱七八糟的词分走剩下的9%。所以它大概率会输出“盐”,接下来再根据“南京秋天最好吃的是盐”,算下一个字,“水”概率最高,然后是“鸭”。
一段文字就这么一个字一个字攒出来了。对,就是一个字一个字猜。你看到的一大段通顺的回复,不是它一下子想出来的,是猜了几百上千次,拼出来的。
哦,你说画图?本质一样,只不过它猜的不是文字,是画布上每个位置的像素颜色而已。是不是一下子就不玄乎了?
你看不到的训练过程,才是大模型算法的真正壁垒
听到这儿肯定有人会说,不就是猜下一个字吗?这有什么难的,怎么现在才做出来这么好用的大模型?
难的不是猜,是怎么让它猜对。它刚出生的时候,参数全是随机的,你输入“1+1等于”,它可能给你输出“黄瓜”,完全驴唇不对马嘴。
怎么让它从乱猜变成能猜对?靠训练。简单说,就是拿亿万级别的公开内容喂给它,一遍一遍改参数。
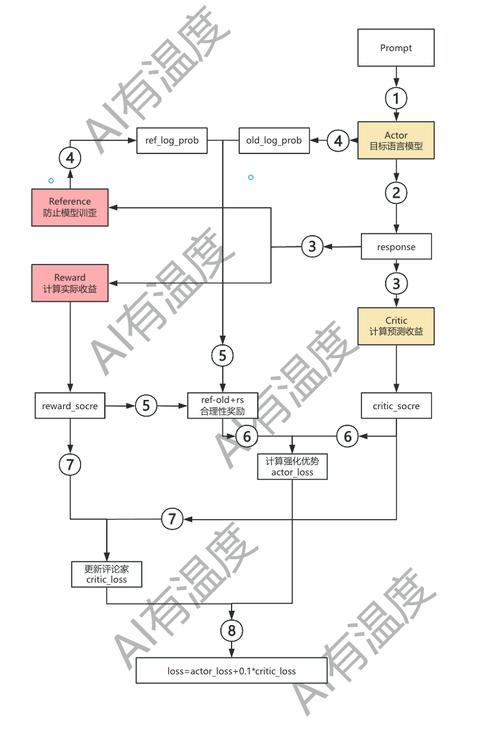 大模型预训练梯度更新参数流程图
举个具体的过程:拿网上已经有的一篇文章,把开头给模型,让它猜后面的内容,猜完了跟真实的文章比,猜错了,就往对的方向调整所有相关的参数,让正确内容的概率变高,错误的变低。一遍不行,就十遍,十遍不行,就一亿遍。
喂的内容越多,调的次数越多,它摸出来的文字、内容规律就越准,猜中的概率也就越高。说白了,就像你上学做练习题,做的题越多,对知识点的规律摸得越透,考试的时候蒙也蒙得比别人准。只不过大模型做的练习题,是你几辈子都做不完的量。
发小跟我说,现在大模型训练一次,烧掉的电费够普通人花一辈子,真不是瞎说。
几个很多人都信了的误区,得掰扯清楚
 几个很多人都信了的误区,得掰扯清楚
第一个误区,说大模型就是把所有训练数据背下来了,输出都是抄的。真不是。我上个月23号在南京吃盐水鸭,吃完闲得慌,让大模型写一首从来没有过的,写“盐水鸭配冰可乐”的五言绝句,它十几秒就写出来了,通顺押韵还挺有那味儿。总不能说它训练的时候刚好背过这么一首不存在的诗吧?
它是学到了中文的规律、绝句的格律、盐水鸭冰可乐的属性,把这些元素重新拼出来的,跟背东西完全不是一回事。
第二个误区,说大模型算法参数越大,效果就一定越好。现在行业里卷参数卷得厉害,好像不整个千亿参数都不好意思出来见人。可实际用下来,很多垂直领域的小参数模型,调对了方向,用起来比通用大模型还顺手,速度快还省钱。不是说参数越大不好,是别唯参数论,适合需求的才好用。
第三个误区,说大模型算法无所不能,再过几年就要取代人类了。别扯。它本质就是靠概率猜下一个字,它没有真正的逻辑思考能力,也没有自我意识。你让它算个十位数乘法,它都能给你算错,因为它是猜答案,不是算答案。很多复杂的需要深度推理的工作,它现在根本做不了,最多帮你打个下手。
不过话说回来,也不能小瞧它的进步。五年前谁能想到,现在手机上随便一个AI就能帮你写文案改简历画图?三年前我跟朋友聊大模型,还说至少十年才能做到现在这个程度,结果呢?发展速度比所有人预想的都快。
我现在写专栏找素材,都会先让大模型帮我把相关的信息整理出来,省去了我好几个小时找资料的时间,原来一周更一篇,现在能挤出时间多写一篇有意思的内容。
至于说未来大模型算法会走到哪一步……我这种普通人猜不透,也不瞎操心。反正它现在已经切切实实改变了我们每天的生活,对吧?
免责声明:市场有风险,选择需谨慎!此文仅供参考,不作买卖依据。如有侵权请联系删除。
文章名称:我们每天都用大模型,你真知道大模型算法到底在算啥?
文章链接:https://www.lfdjt.com/p/keji/a/6164.html