上个月9月23号,我在南京老门东的一家社区咖啡店等人。点了一块巴斯克,结账的时候小程序弹出来个推荐:「搭配冰美式,90%的客人都这么点」。我顺口跟老板吐槽,你们这规则写得挺准啊。
老板笑了,说哪是我写的规则。这是系统自己学的。
我一下子就来了兴致。原来这就是机器学习啊,藏在这么小的地方,大部分人点完单就划走,根本没发现。
机器学习从来不是只有实验室里的大模型
说实话,大部分人对这四个字的印象,还停留在新闻里的大模型、会下棋的机器人,动辄几千亿参数,感觉跟日常完全不沾边。
错得离谱。
你刷短视频的推荐流,点外卖给你推常吃的店铺,甚至手机上人脸解锁,背后都是机器学习。它不是有钱人实验室的玩具,早就钻进了你生活的每个缝隙。
这家咖啡店的例子太好懂了。放在十年前,要做这个搭配推荐,得工程师一条条给电脑写规则:点芝士蛋糕要推苦咖啡,点草莓慕斯要推果茶,孕妇不能推含咖啡因的,乳糖不耐受要推燕麦奶…
你写一万条规则,也架不住客人千奇百怪。有人就是吃甜还要喝甜,有人就爱巴斯克配热可可,你哪能把所有情况都写全?
机器学习换了个思路。它不用人写死所有规则,只要把过去一年几十万条客人点单数据喂给它,它自己就会找规律:什么样的客人,点了第一样东西之后,大概率会点第二样。试得越多,找得越准。
就这么简单。老板说,现在推荐的命中率,比他自己蹲店里摸了半年规律准两倍。
太爽了。
拆穿术语包装,核心逻辑其实普通人都能懂
很多科普一上来就甩卷积神经网络、梯度下降、反向传播,一堆术语堆得人头晕,直接把想了解的人吓跑了。
说白了,机器学习的核心逻辑,跟你第一次去一个陌生地方找店一模一样。
你要找老门东里的一家网红小馄饨店,导航只给了你大概位置,没说具体走哪条巷。你顺着大概方向走,每到一个路口就抬头看看路牌对不对,不对就退回去换一条,走个两三次,你就记住哪条路最快,不用再看导航了。
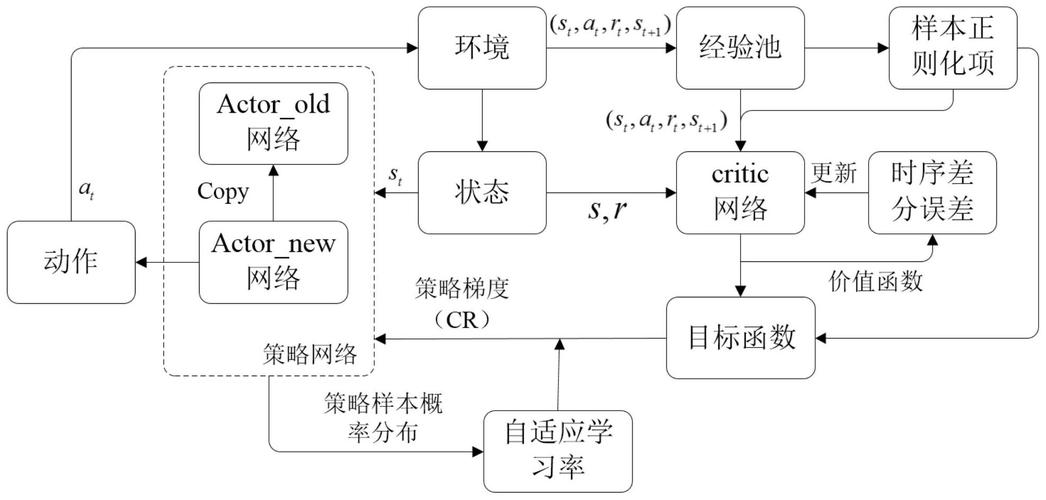
机器学习就是这么干的。一开始它也是瞎猜,猜完了跟真实结果对比,错了就调整自己的规律,一遍一遍试,试个成千上万次,规律就摸准了,猜得也就越来越对。
哪里需要什么高深莫测的理解?它不会真的「懂」为什么巴斯克配冰美式好喝,它只知道,百分之八十的客人都这么选,这么推就对了。
不过话说回来,你会要求一个推荐搭配的系统懂咖啡吗?它只要准就够了,对吧?
很多人有个误区,说机器学习必须配超大数据库,没有几个亿数据根本玩不了。扯。这家咖啡店一年才十几万条数据,照样用得好好的,够满足自己的需求就行。你开个小店,要全球数据干嘛?适合自己就够。
现在最多人踩的误区,我得掰扯清楚
我刷社交平台,看多了两种极端的说法,要么把机器学习吹得神乎其神,说马上就要取代所有人类,要么就说都是骗人的,全是资本炒概念。
两个都错。
第一个误区:机器学习什么都能做。现在好多人吹AI能写论文能看病能当律师,说什么问题都能解决。不对。它本质上是从已有数据里找规律,数据本身歪,结果肯定歪。
就说这家咖啡店,如果刚开店前半个月,都是老板帮客人点单,老板自己爱推冰美式,那系统学出来的全是老板的习惯,不是客人的真实需求,推出来的东西自然不准。数据脏,再厉害的模型也出不来好结果。
第二个误区:机器学习会抢走所有人的工作。它取代的,本来就是那种重复找规律的枯燥工作。比如原来有专人每天给发票分类,给客户邮件打标签,这种机械活,机器学习干得又快又准,本来就该交给机器做。
那老板呢?原来他每天打烊要花一个小时整理销售数据,想搭配算库存,现在系统帮他干了,他省下来的时间,可以蹲在厨房研究新的烤蛋糕配方,可以跟客人聊天拉近距离,这些需要温度、需要创意的事,机器抢得走吗?
抢不走的。
in我那天坐在咖啡店门口,看着秋风卷着桂花香飘进来,老板坐在柜台跟熟客聊天,系统在后台安安静静更新自己的规律,突然就觉得,这才是机器学习最好的样子。
它不用站在聚光灯下当无所不能的神,它就安安静静待在你看不见的地方,帮你省点时间,省点力气,让你把精力放在更有意思的事上。
就像现在你刷这篇文章,平台给你推它,也是机器学习在干活。你能看到这儿,说明它找对了你的兴趣,这不就够了吗?
作者|科技
排版|科技
审核|阿辰