2026-10-02 04:45:17
作者:
科技
昨天帮我妈搜“南京玄武湖银杏观赏时间”,打开页面没翻五分钟,直接框出来了最佳时间段、具体在哪一片、现在黄了多少,甚至连最近地铁哪一站封站都标在旁边。
换十年前,你得翻个三五篇公众号文章,才能把这些信息凑齐。
谁在背后帮你整理好了这一切?
是知识图谱。
别翻百科了,知识图谱不是画出来的“图”
很多人第一次听到这个词,第一反应就是画满节点和线的思维导图,或者那种结构清晰的知识框架图。
不对。
我们看到的那个花花绿绿的可视化图,只是知识图谱给人看的展示。它本质上是一套把实体和关系理清楚的结构化存储方式。
说白了,把世界上所有的人、事、物都拆成一个个独立的“节点”,再给两个节点之间牵一条线,线上写清楚他们是什么关系,这就是知识图谱最核心的样子。
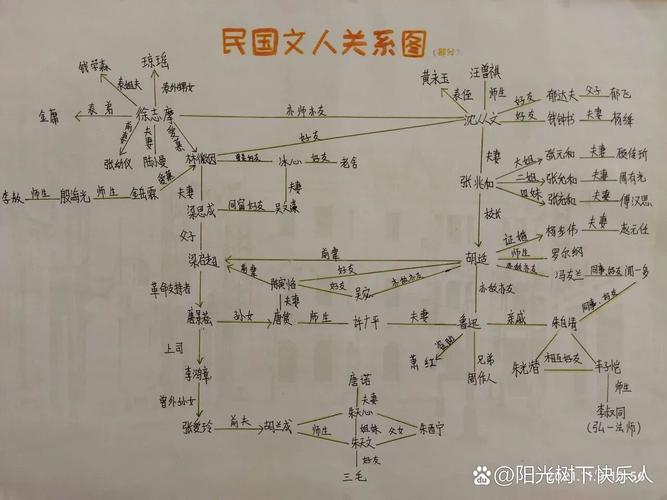 知识图谱民国文人关系可视化图
比如说,节点“鲁迅”,节点“周树人”,中间连的线是“等同于”;节点“鲁迅”,节点“呐喊”,中间连的线是“创作”;节点“呐喊”,节点“人民文学出版社”,中间连的线是“出版”。
这么一串起来,所有信息就不是散落在互联网各个角落的乱码了,机器能直接读懂谁是谁,谁和谁有什么关系。
以前我以为这东西是近几年才火的新概念,后来翻资料才发现,早在上世纪六七十年代就有类似的思路了,只是那时候算力不够,存不下这么多节点和线,直到最近十几年互联网信息爆炸了,才真的能用起来。
它解决了搜索十年都没搞定的老问题
你有没有过这种经历,十年前搜“苹果”,翻三页都分不清你要找的是水果还是手机。
那时候的搜索是关键词匹配,只要文章里有“苹果”两个字,不管说的是什么,都能给你排上来。机器根本不知道“苹果”是两个完全不同的东西。
知识图谱一上来,这个问题就解决了一大半。它能把你要搜的内容对应到具体的实体上,你最近半个月都在逛数码论坛,搜“苹果”出来的肯定是iPhone;你上周刚搜了“水果低糖减肥食谱”,出来的就是可以生吃的那个苹果。
 传统关键词搜索与知识图谱搜索结果对比图
说实话,这种变化对普通人来说太友好了。早几年搜“周杰伦的老婆”,首页全是好几年前和侯佩岑的旧新闻,翻半页才能找到昆凌的信息。现在你再搜,直接把昆凌的生日、什么时候结婚、几个孩子都给你整理得明明白白,根本不用你自己扒。
不止搜索,你现在用的所有推荐,背后都有知识图谱的影子。你搜了一次婴儿纸尿裤,接下来平台给你推婴儿奶粉、婴儿车,不是它偷窥你,是知识图谱里“纸尿裤”和“新生儿”“奶粉”本来就是强关联的实体,顺着关系推就对了。
导航找“附近带充电桩的停车场”,外卖搜“不辣的川菜馆”,本质上都是知识图谱在帮你做实体筛选,把符合两个条件的节点直接挑出来给你。
大部分人都对它有个误区
 大部分人都对它有个误区
很多人觉得知识图谱就是给大模型喂料的原材料,是科技公司实验室里的东西,跟日常用的普通人没关系。
哪能啊,你每天都在用,只是你没发现而已。
还有个更大的误区,很多人觉得知识图谱就是越大约全越好,全天下的知识都装进去才厉害。
其实错得离谱。
我去年帮朋友整理地方戏曲领域的小众知识图谱,机器自动从互联网爬出来的关系,错了快三分之一。把京剧名家的师父的师父,直接连给了当代演员当师父,还把同一个字辈的不同演员归成了父子关系。
我当时看到都笑疯了,这错误犯得比刚入圈的戏迷还离谱。
为什么会这样?互联网上关于这些小众领域的信息本来就少,还错漏百出,机器自动连关系,自然错得一塌糊涂。就算是通用知识图谱,闹的笑话也不少,之前还有人发现,某知识图谱把“张学良的父亲”写成了张学友,隔代错得没边。
不过话说回来,这种错误出现在通用领域也就是个乐子,出现在垂直领域真的会出问题。比如医学知识图谱错了一味药的配伍禁忌,法律知识图谱错了一条法条的生效时间,后果根本不敢想。
所以现在很多垂直领域的知识图谱,至今还是半人工整理,机器做初筛,人来做最后核对,根本做不到全自动化。
现在大模型火了,很多人说知识图谱要被替代了,大模型自己就能学所有知识,不用再费劲整理实体关系了。我倒不这么看,大模型会胡编乱造,就是因为它没有把知识按关系理清楚,知识图谱刚好能补这个短板,把错的东西给卡住。
说白了,知识图谱从来不是什么高大上的黑科技,它就是给乱七八糟的互联网信息,编了一本能让机器读懂的关系通讯录。你用的每一次搜索、每一次推荐,都在靠这本通讯录省时间。
只是它一直躲在后台,没人注意到罢了。
免责声明:市场有风险,选择需谨慎!此文仅供参考,不作买卖依据。如有侵权请联系删除。
文章名称:你刷到的推荐刚好对味,知识图谱在偷偷干活
文章链接:https://www.lfdjt.com/p/keji/a/5525.html