上周六去南京明瓦廊找吃的。刚点开点评输入两个字“鸭血”,搜索框下方直接弹出“鸭血粉丝汤(明瓦廊店) 人均28 营业中”。我都没输完,它怎么知道我要找什么?
别觉得这是大数据算命,这背后就是知识图谱在干活。很多人听这个名字觉得高大上,是实验室里的黑科技,其实你从早到晚,搜攻略、点外卖、导航、刷短视频,每一步都在蹭它的好处。
它不是堆出来的知识点,是一张连起来的网
很多人对知识图谱的第一印象,就是百科词条旁边那个“相关人物”“相关事件”的关联图。说实话,那只是做给人看的可视化,根本不是知识图谱的核心。
知识图谱的本质,说穿了就是两句话:把所有信息拆成实体和关系,再把这些实体像点一样,用关系当线连起来,织成一张网。
就拿刚才的例子说,你这个人,爱吃咸口,住在新街口,想找鸭血粉丝汤,这四个都是实体,关系是“用户-口味-咸口”“用户-位置-新街口”“用户-需求-鸭血粉丝汤”,知识图谱一拉,就直接把符合所有条件的那家店拽到你面前,根本不用瞎翻一堆不相关的内容。
放在十年前,搜索引擎根本做不到这个。那时候你输“南京秋天去哪玩”,它只会找网页里这几个关键词出现次数最多的页面,翻个三五页都是凑字数的攻略,根本找不到你要的内容。现在呢?输入完直接给你列出来栖霞山红叶、颐和路梧桐、中山陵桂花,连门票预约入口都给你摆好,这就是知识图谱的功劳——它早就把所有实体的关系理清楚了,不用临时瞎找。
那些你没注意到的地方,全是它的影子
除了搜索和推荐,知识图谱藏在太多地方了。你用导航找“附近带充电桩的加油站”,为啥三秒钟就能出结果?不是它一秒钟扫完了方圆十公里所有的加油站,是它的知识图谱里早就把“加油站”“充电桩”“位置”“距离”这些关系连好了,要做的只是拉出来匹配一下就行。
现在大火的大模型,其实也离不开它。你肯定见过大模型瞎编内容,说不存在的书、不存在的地址,甚至乱扯历史事件,这就是业内说的大模型幻觉。为啥会瞎编?因为大模型是靠统计概率猜下一个字,它根本不知道哪个实体和哪个关系是对的。如果接了知识图谱,就相当于给它拴上了缰绳,问它“南京有哪些古代皇宫”,它不会瞎扯说南京有现存故宫,因为知识图谱里明明白白写着“故宫-位置-北京”“明故宫遗址-位置-南京”,关系锁死了,它就错不了。
之前见过一个没对接知识图谱的大模型,跟我说南京大屠杀发生在武汉。太扯了。这种错误,只要有知识图谱打底,根本不可能出现。
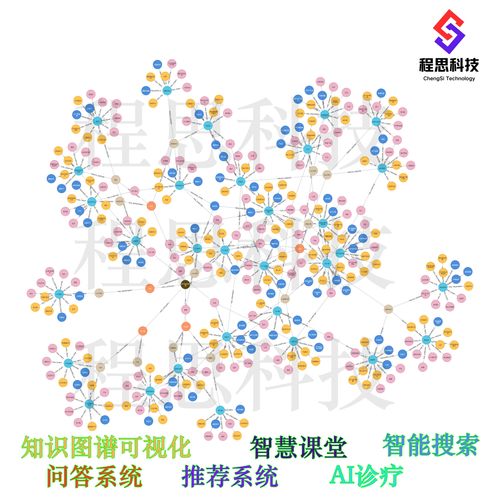
说白了,大模型是会背书的考生,知识图谱就是给它兜底的标准答案本,不会让它胡言乱语。现在好多做通用大模型的团队,都在往回捡知识图谱,之前吹什么“大模型能搞定一切知识”,挨了骂才知道,没有知识图谱兜底,根本没法用在正经地方。
很多人对它的误解,其实挺好笑的
第一个误解,说知识图谱就是给大模型准备的训练数据。不对,完全两码事。训练数据是喂给大模型让它学的,知识图谱是给大模型查的,一个是课本,一个是开卷考试带的索引,根本不一样。
第二个误解,说知识图谱就是给机器看的百科全书。也不对,百科全书是写给人看的,要讲逻辑讲文笔,知识图谱才不管这个,它只要把关系理对就行。外卖平台的知识图谱里,甚至会写“南京用户的微辣=比中辣少放两勺辣椒”“成都用户的微辣=广州用户的特辣”这种细碎到离谱的关系,百科全书会登这个吗?根本不会,但对机器来说,这就是最有用的知识。
不过话说回来,现在行业里吹的牛也不少。动不动就说自己有上百亿实体,规模多大,其实里面一堆错误的垃圾关系,把“南京盐水鸭”和“北京烤鸭”归成同一个菜品,这种堆出来的规模,有啥用呢?还不如踏踏实理顺清楚一万个常用的正确关系,对用户来说有用多了。
还有人说,现在大模型这么火,知识图谱过时了,没人用了。真的是这样吗?我上个月跟一个做算法的朋友吃饭,他说现在所有能落地的大模型应用,多多少少都要搭知识图谱,毕竟用户要的是正确的答案,不是一本正经的胡说八道,光靠大模型的概率,真兜不住。
当然,知识图谱也不是完美的。它也有麻烦事,比如很容易把人类的偏见带进去,之前就有招聘网站的知识图谱,把“高管”这个实体默认和“男性”绑定,推荐的时候全给男性推高管岗位,这种偏见藏在网里,改起来特别麻烦。还有,知识图谱越大,错一个关系就要改一堆关联的地方,牵一发动全身,维护成本高得吓人。
那天吃完鸭血粉丝,沿着中山南路走,风刮得梧桐叶子掉下来,落在肩上。我掏出手机搜附近的咖啡店,一秒就出来了离我五十米的一家社区店,地址连门牌号都对。
我们从来不会特意想起知识图谱,甚至很多人用了好几年都没听过这个词,但它早就悄悄把我们生活里的各种信息,织成了一张细密的网。你要的不是一碗鸭血粉丝,也不是一杯咖啡,它早就帮你把所有符合你需求的选择,理得清清楚楚,递到你面前了。
作者|科技
排版|科技
审核|安然