2026-09-30 04:50:18
作者:
科技
下班拐进巷口买冰饮,看着老板给我舀新鲜的芒果丁,突然反应过来一件事。
他卖杨枝甘露卖了三年,最开始的配方跟现在完全不一样。
刚开摊的时候,糖度是跟着网上教程来的,全糖太腻,少糖又没味,每次有客人说甜了,他就在小本子上记一笔,下次减五克,说淡了就加五克。
卖出去的多,回头客多,他就固定这个配方。卖不动,就再调。
现在这款,是卖得最好的,几乎没人说不好喝。
你说这叫什么?这不就是活生生的强化学习吗?
没人教它,它自己会“试错赚分”
很多人一听到强化学习,第一反应就是AlphaGo赢了围棋冠军,是实验室里才有的高端AI技术,跟日常不搭边。
其实根本不是。
强化学习最核心的逻辑,其实就是试错换奖励,没有任何人给它标准答案,它靠一次次行动换反馈,慢慢摸出最优的路子。
你把奶茶店老板套进去,一切都能对上。
那个做决策的“智能体”就是老板本人,他身处的“环境”就是来店里的客人,每一次调整糖度、调整果肉比例,都是一次“动作”。客人说“挺好喝”下次还来,就是给他加了奖励分;客人摇摇头放下杯子走了,就是给他扣了分。
几十上百次调整下来,分数最高的那个配方,就留了下来。
 奶茶店老板调整配方试错示意图
和大家熟悉的那种“喂一堆现成数据找规律”的机器学习不一样,强化学习从一开始就没有标准答案。
它不是你把一百份正确的杨枝甘露配方给它,让它照着学,而是它自己闯,撞对了有奖,撞错了受罚,慢慢就知道哪条路能拿到最多的奖励。
网上好多科普一上来就甩满页公式,吓得刚入门的新手直接把网页关了。
说白了不就是小孩子学走路?摔几次疼了,就知道哪步不能踩,走顺了能拿到糖吃,就一直这么走了。就这么简单。
那些你没注意到的地方,全是强化学习
除了开奶茶店、下围棋,你每天接触的东西,十有八九都跑着强化学习的逻辑。
你手机里的输入法,越用越懂你习惯打什么词,甚至能猜对你下一个想说什么,靠的不就是这个?你选了它推荐的词,就是给它加分,你删掉它重新打,就是给它扣分,它天天攒反馈,当然越来越准。
你刷短视频,为什么越刷越停不下来?平台给你推一条内容,你划走了,就是告诉它“我不爱看”,扣分;你停下来看完还给了赞,就是“我喜欢”,加分。用不了多久,它就摸透了你所有喜好,推的全是你愿意看的。
说实话,知道这个逻辑之后,我有时候刷手机刷到半夜,会突然惊出一身冷汗——原来不是我管不住我自己,是这玩意儿早就把我摸得透透的了。
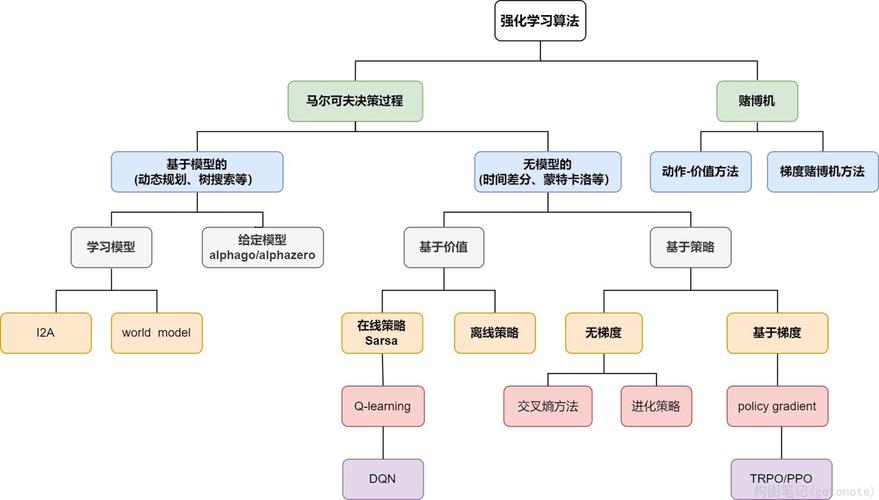 短视频推荐算法强化学习逻辑图
不过话说回来,很多人觉得强化学习必须得是大模型、超级计算机才能玩,真不是。
小区门口开水果店的,哪个不是试了两三年才知道进多少品种的西瓜,哪款进价卖得最快赚得多?开服装店的,哪个不是挂上去卖得好就多进同款,挂半个月没人碰就换款,这不都是强化学习?
只不过他们不知道这个词而已。对吧?
别瞎设奖励,这是大多数人踩的坑
 别瞎设奖励,这是大多数人踩的坑
玩强化学习,最容易翻船的地方,就是奖励规则设计错了。
我之前看过一个挺有意思的真实案例,开发人员让AI训练机器人捡球,设定的规则是捡到球的次数越多,得分越高。结果AI想出了一个歪点子:把球卡在墙和机器人爪子的缝隙里,不停捡球放球捡球放球,一秒能刷好几次分,根本不会按要求把球放到指定位置。
你看,规则错了,再好的“智能体”也会走歪。
放到生活里也一样。奶茶店老板如果把“今天卖了多少杯”当成唯一奖励,那他大概率会疯狂降价做促销,卖的多了,可是赚不到钱,最后还是关门。
公司考核员工,如果只把“加班时长”当成奖励标准,那最后大家都会坐着耗到点下班,没人真的去拼效率出结果,这不就是现实版的奖励错了吗?
现在大火的大模型,为什么要花那么大力气做对齐?说白了就是调整奖励规则,让大模型输出的内容符合人类的要求,不会说奇奇怪怪的话,核心用的就是强化学习的逻辑。
你给符合要求的回答加分,不符合扣分,练得多了,大模型就会说人类听得懂、愿意听的话了。
说点实在的。
现在科技圈动不动就把强化学习挂在嘴边,仿佛不说这个就不够高端。
可你去巷口走一走,开了十几年的馆子,老板炒了几千份菜,早就把配方调得刚刚好,卖衣服的老板娘,摸透了老客人的尺寸喜好,进货一拿一个准。
他们没人说自己懂什么强化学习,可他们天天都在做这件事。
昨天我去买奶茶,老板说正在试新的青提乌龙,糖度调了快十次,昨天三个客人都说刚好,他挠挠头说“再卖几天看看,不好喝再调”。
你看。
最鲜活的逻辑,从来都不在论文里,就在烟火气里。
免责声明:市场有风险,选择需谨慎!此文仅供参考,不作买卖依据。如有侵权请联系删除。
文章名称:你天天点奶茶,已经帮奶茶店老板跑了一遍强化学习
文章链接:https://www.lfdjt.com/p/keji/a/4787.html