2026-09-28 05:31:50 分类:正文
九月二十三日,南京新街口的咖啡馆,空调开得有点足。
朋友揣着磨毛了壳的笔记本坐过来,说,给你看个新东西。
我本来没抱太大期待。这两年各种新概念轮着转,刚看完大模型热,又冒出来多模态,吹得玄乎,说白了不就是能认个图嘛?
试完我坐那愣了十分钟。
别被「能认图」骗了,核心根本不是拼模块
绝大多数人对多模态大模型的误解,从玩法介绍就错了。很多科普说它就是「文本大模型加上图像识别模块,再加点语音视频」,说白了就是拼起来的混血。
不对。
真的融合型多模态,是从训练开始就把文字、图像、音频这些不同类型的信息,放到同一个空间里学习。它懂的不是「这张图里有猫,文字说猫是黑色」,它懂的是「你说的那只钻进纸箱子的胖黑猫,和我看到的这张图里的东西,是同一个意思」。
举个我那天试的例子。我翻出来包里一张皱巴巴的发票,随手拍了,输入:帮我把这张票的信息整理出来,填到我上周出差的报销清单里,挑出来超过公司标准的那部分标出来。
放在以前,我得先把发票上的字一个个敲进去,再翻报销标准对,折腾十分钟。这个呢?十秒出结果,连发票上我签名蹭出来的墨点都没认错,直接把错字过滤了。
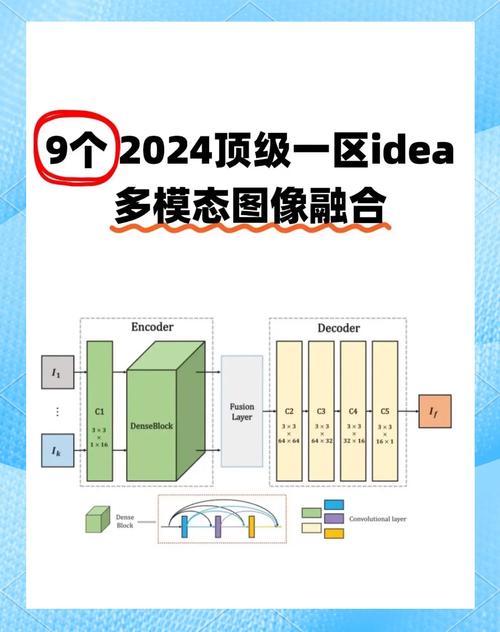 多模态大模型模态融合架构对比示意图
换个普通的图文模型试,它只能把发票上的字全部识别出来,根本不知道哪部分是金额哪部分是日期,更别说对应报销规则筛了。
这就是差距。一个是帮你干活,一个是帮你认东西,完全不是一回事。
普通人别追概念,试试这些日常场景真的香
说实话,我之前看厂商发布会,说多模态要颠覆这个颠覆那个,我都懒得看。都是给资本看的,和普通人有啥关系?
试了三天才发现,它已经悄悄能解决好多我们日常烦得要死的小事了。
我妈攒了四大本老相册,全是我从小到大的照片,没有一张标日期,也没写去哪拍的。她念叨好几年想整理成电子册,我一直懒得弄,太麻烦了。
这次直接把所有照片扫描成图,一股脑丢给多模态,说:按拍摄时间排序,把有我小学春游的分一组,有我一家三口在北京天安门的分一组,每张照片给我写一句适合发朋友圈的文案,不要太肉麻。
半小时。
全部弄完。正确率有九成多,只有几张我初中和高中的照片分错了,改两下就行。我妈拿到电子档,直接发了三条朋友圈,高兴得晚上加了个菜。
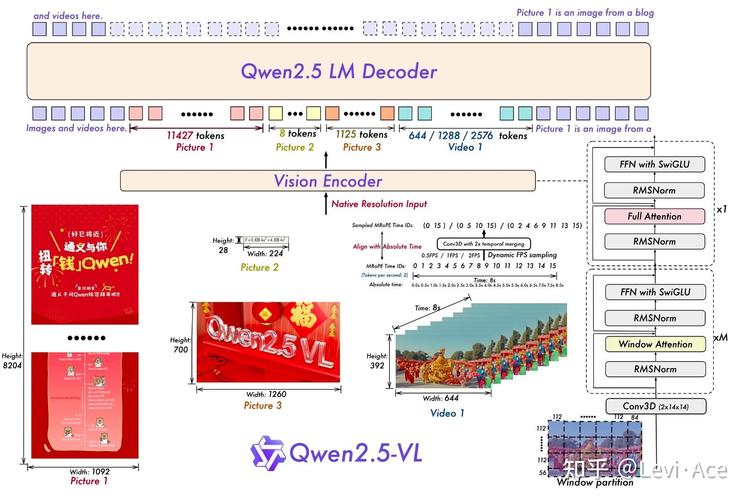 多模态大模型整理老相册交互界面示例
还有啥?比如你画了一张歪歪扭扭的户型图,想给设计师看,你直接拍了给多模态,说帮我把这个改成标准的带尺寸标注的CAD初稿,顺便给我出两个摆放家具的思路,符合我要的极简风格。它直接就能弄,不用你对着软件拉半天线。
你拍一张你在餐厅吃的蛋糕,说这个蛋糕的奶油从质感帮我判断一下会不会是植物奶油,这家店菜单写的动物奶油会不会骗我。它也能给你说个八九不离十。
都是小事。但就是这些小事,耗了我们多少时间对吧?
别吹得太神,它现在的坑还不少
 别吹得太神,它现在的坑还不少
不过话说回来,我得泼点冷水。现在的多模态大模型,远没到完美的程度。
我试过拍一张我爷爷写的毛笔字,年代久了纸发黄,墨迹也晕开了,让它识别内容,它错了快三分之一。笔画连在一起的手写,它还是认不清。
还有一次我拍了我电脑屏幕上的代码截图,说帮我改一下这个bug,它看了半天,把变量名认错了,改出来的东西根本跑不起来。
还有人说多模态要取代摄影师设计师,纯扯。它现在能帮你整理素材,能帮你出初稿,能帮你想思路,但真要出符合要求的成品,还得人调。它不会懂你拍这张老照片的时候,你爸刚下岗,一家人挤在公园草坪上笑那种情绪,它只能帮你标出来这张照片是什么时候拍的,有几个人。
很多营销号把它吹得太神,目的是什么大家都懂。我们普通人得拎清楚,它就是个新工具,和当年我们从手写日记变成打字,从胶片相机变成数码相机一样,工具变了,干活的核心还是人。
那天邻座的小姑娘,刚毕业找工作,拿着自己的手绘作品集,拍了一张给多模态,说帮我把这个作品集整理成PDF,每个作品加一段介绍,符合互联网公司招聘的口味。十几分钟弄完,她凑过来给我看,说比她昨天找打印店老板帮她弄的还整齐。
她抬头笑的时候眼睛亮得很。
我那时候突然想,这才是多模态真正有意思的地方。以前我们要干个什么事,得先学一堆软件,得会按规则和机器说话,现在不用了。你拿个手机拍一下,说两句人话,它就懂你要啥。
门槛没了。
很多人谈技术变革,说来说去都是架构参数,我觉得不对。技术变革真正的改变,就是让原来要花很多钱很多时间很多学习成本才能干的事,变得普通人拿起手机就能干。
多模态大模型现在走的就是这条路。
你别听那些专家扯什么遥不可及的概念,也别信什么颠覆行业的鬼话,你就找个能用的,拿你自己手头那点烦心事试试。
试完你就知道。
这波,真的不一样。
免责声明:市场有风险,选择需谨慎!此文仅供参考,不作买卖依据。如有侵权请联系删除。
文章名称:我在咖啡馆试了三天多模态大模型,发现大家都误解它了
文章链接:https://www.lfdjt.com/p/keji/a/4070.html