我挺好奇,问老板什么时候开始搞这个推荐的?老板擦着手说,大半年了吧,原来不管谁来都是默认放桂花的,现在不一样,谁来过吃过啥,它自己记着自己推,销量居然涨了小两成。
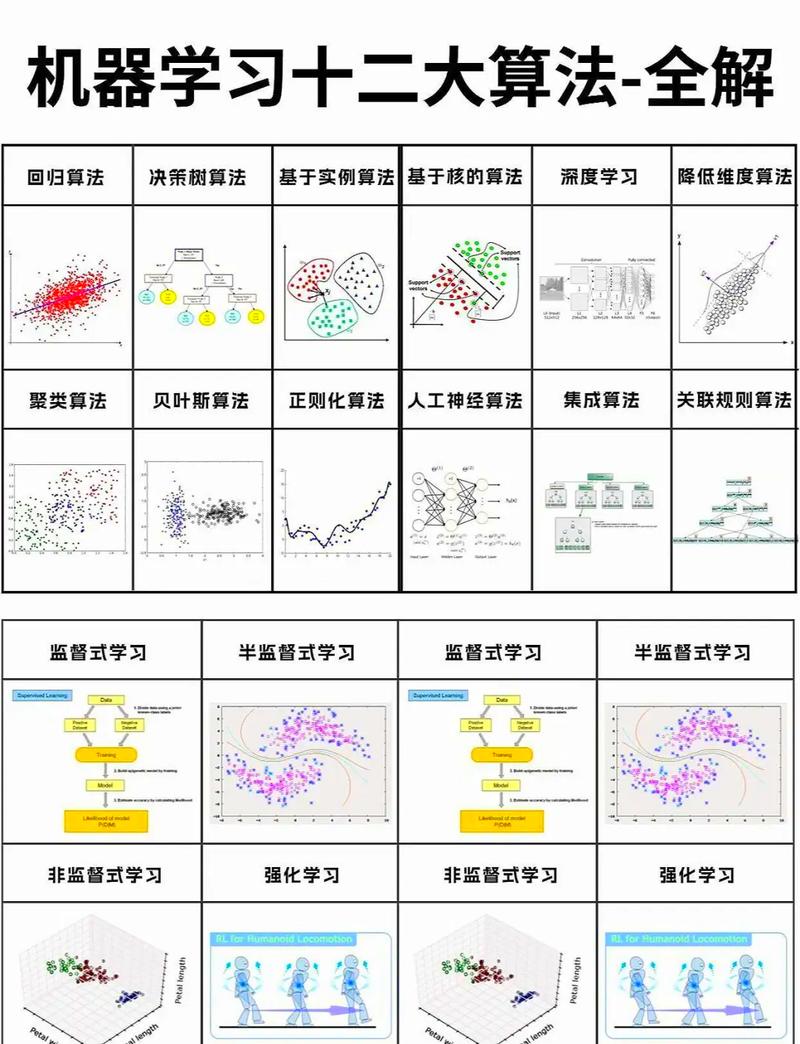
你看,这就是机器学习。不是只有阿尔法狗下围棋、ChatGPT写作文才叫机器学习,你点外卖的推荐、导航选的不堵车路线、手机相册自动给你分类人脸,全是它在干活。
它不是”写死的规则”,是自己学会找答案
很多人一听”机器学习”四个字就头大,觉得满页都是看不懂的公式。其实说白了很简单,原来我们用的程序,都是人把规则一条一条写死的。比如商场做活动,满100减10,满200减30,程序员就把这两行规则敲进去,谁来都是按这个算,一点错没有。但要是碰到那种说不清楚规则的事呢?
比如让机器认猫,你怎么写规则?猫有尖耳朵?折耳猫不服。猫有毛?无毛猫哭给你看。你就是写一万条规则,总有漏网的猫。
机器学习的思路不一样,不给规则,只给例子。你给它扔十万张照片,每张都标好”这是猫””这不是猫”,让它自己一遍一遍刷,刷得多了,它自己就能摸出规律:原来长这样的就是猫啊。下次扔给它一张没见过的图,它就能说出是不是猫了。
它活没活对不对?
普通人对机器学习的几个常见误区
第一个误区,就是把机器学习等同于人工智能。其实人工智能是个很大的概念,从最早会下棋的程序到现在的聊天机器人,都能算人工智能。机器学习只是人工智能里,目前最好用也最火的一个方法,现在出圈的生成式AI,本质上也是机器学习里的深度学习分支,别搞混了。第二个误区,觉得机器学习都是瞎蒙的,一点不准。其实它不是瞎蒙,是算概率。它给你推半糖冰美式,不是它瞎猜你要喝这个,是它算出来,你点半糖冰美式的概率是78%,比其他所有口味都高,所以才放第一个。当然也会错,你今天就是想换个口味喝全糖的,很正常,概率高不代表百分之百对嘛。
第三个误区,说机器学习马上就要取代所有人上班了。我认识好几个做算法的朋友,天天吐槽加班,加在哪?不是调模型,是整理数据。
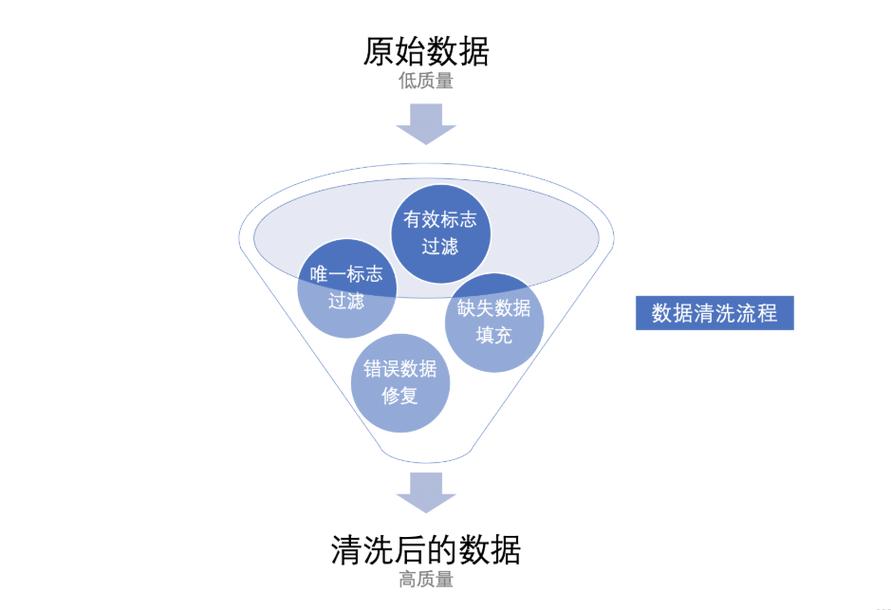
一堆用户上传的数据,什么奇奇怪怪的都有,年龄写999,地址写”我家”,照片拍糊了标错了,都得人一点点改,一点点标对了,机器才能学得会。机器哪懂你填999岁是瞎写的?它当真了你说怎么办?
说白了,现在所有能落地的机器学习,背后都是一堆人在给它擦屁股。它取代的都是那种重复整理数据的活,真正要做判断拿主意的,还得是人来。
说点不跟风的冷思考
原来做个机器学习模型,得养一堆算法工程师,花好多钱,只有大公司玩得起。现在不一样,云服务商有现成的预训练模型,小商家花几百块钱就能接上,把自己的营业数据喂进去,就能用,算库存推产品都能干。这才是真的改变普通人生活的事。
当然问题也不少,最常见的就是大家常说的过拟合,换成人话讲就是”见得太少,认死理”。你给模型喂的一万只猫全是橘猫,它就会觉得只有橘色的才是猫,碰到黑猫就不认得了。
现在很多模型都有这个毛病,训练用的数据全是大城市年轻人的上网数据,推给三四线的中老年人,推荐的东西全不对路,这不是模型笨,是喂给它的数据就不对。
不过话说回来,这两年也慢慢好起来了,越来越多做模型的人开始关注数据的多样性,不再只拿一线城市年轻人的数据凑数。
我上个月跟一个做医疗机器学习的朋友吃饭,他说他们做的胸片读片模型,对小结节的识别率已经比平均水平的大夫高了,但医院还是要求必须大夫看过才能下诊断,模型只给人做辅助,提个醒。
我觉得这状态就对了。从一开始的神化,到现在慢慢落地成工具,机器学习本来就是个帮人干活的东西,不是什么改变世界的魔法,更不是要抢人饭碗的怪物。
今天你出门,打开导航它给你选了不堵的路,打开外卖它推了你爱吃的那家店,你可能都没感觉,这就是机器学习最好的状态——悄悄干活,不凑热闹。
说不定刚才你点咖啡,它又给你推对了口味呢。
作者|科技
排版|科技
审核|安然