 大讲堂
前阵子朋友发来一张糊得发绿的照片,问我桌上那坨是什么。我懒得打字,直接丢给手机里的助手:这啥?还能吃吗?它先认出了外卖盒,又读出包装上的小字,还提醒我汤汁可能洒了。那一刻我有点愣。它不是在“处理文字”,它在同时看、读、猜上下文。嗯,多模态大模型干的,就是这种跨感官的活。
它不是“加了个摄像头”的聊天机器人
很多人以为,多模态大模型就是给语言模型外挂一个图像模块。图进来,识别一下,再把结果翻译成文字。要真这么简单,工程师早回家睡觉了。
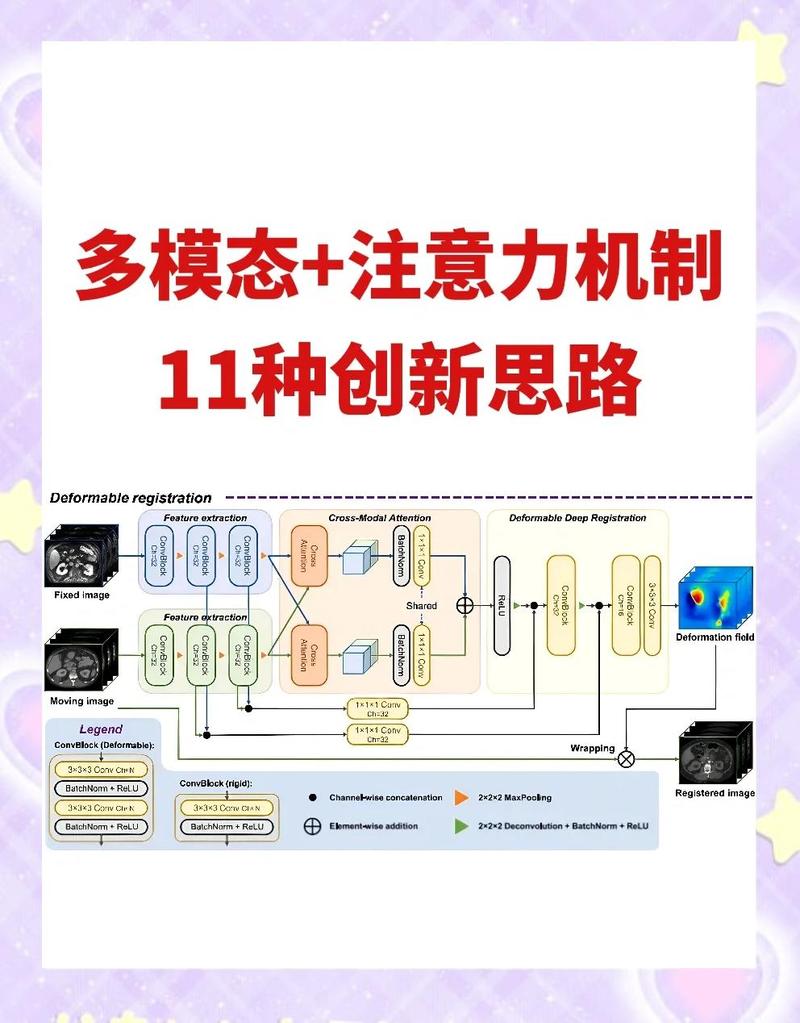
语言模型眼里,世界是一串 token。图像呢?像素矩阵。音频?波形。它们原本说不同的语言。多模态要做的,是让这些不同信号在内部找到一套共同的向量表达。比如把图切成小块,每一块压成向量;文本词也变成向量;再用投影层把它们拉到同一个空间。训练时喂大量图文对,让猫的图和猫这个词靠近,让狗的图和狗这个词靠近。听起来像相亲。实际上,确实有点像。
但麻烦在后面。你说“左边那个红色的”,它得把 left、red 对应到画面区域。不是关键词匹配。区域和词之间要有注意力来回拉扯。图像里的小字、被遮挡的半张脸、视频里一闪而过的动作,都可能在这套拉扯里丢掉。
放大的不是算力,是“接口”问题
大模型看一张图,不是看一眼就完。图像会被切成很多小块,每一块都变成 token。一张普通照片,可能就顶上一段长文。视频更狠。几十帧、上百帧,再加音频轨道。上下文窗口瞬间吃紧。
所以多模态模型常做的事,是压缩、筛选、丢细节。像开会时只记关键词。你问“菜单里哪个不辣”,它得先 OCR,认出菜名,再调用常识。手写体、反光、辣椒图标,都会让它犯难。它答错了,未必是“笨”。可能是视觉那一端根本没读清。
还有一个隐藏成本:延迟。云端跑大模型,拍张照上传、推理、返回,几秒就过去了。要是自动驾驶或手术辅助,几秒可不行。边缘设备算力又有限。于是很多产品选择折中——本地做小模型初筛,云端做复杂问答。多模态的体验,常常被接口和带宽卡住,不是被参数卡住。
那些让人误解的“看懂”和“听懂”
它没有眼睛,也没有耳朵。它有的是向量、权重、概率。所谓“看懂”,是统计相关性在起作用。给它一张图,它根据训练里见过的模式,猜出这里像猫,那里像杯子。可一旦遇到对抗贴纸、罕见角度、奇怪光照,它就可能翻车。
还有一个常见误会:多模态大模型等于全能。能 OCR 不代表能空间推理。能描述视频,不代表懂因果。你让它数图里几个人,它可能多数一个,因为把海报上的人也算了。你让它判断“杯子会不会掉”,它得理解重力、支撑面、遮挡关系。这些不是多认几个物体就能解决的。
语音这边也一样。识别字面容易,识别语气、讽刺、犹豫,难。口音、背景噪音、多人说话,都会把波形搅乱。它可能听清了每个词,却理解反了意思。人类聊天靠表情、停顿、语境补全。模型也在学,但学得磕磕绊绊。
一段真实对话里的裂缝

我试过拿一张地铁线路图问它换乘。它答得挺顺,连方向都说了。可它把某个站说成同台换乘。我盯着图看了半天,发现它把图例颜色看混了。那瞬间挺有意思——它从文字里学会了“换乘”的常见说法,却没真正读准图上的线。
这暴露了一个关键:多模态大模型擅长跨模态联想,不擅长精确空间计算。你要它写一段看图作文,它可能很出彩。你要它从工程图纸里读出尺寸,它可能胡编。怎么办?给它工具。调用 OCR 后结构化,调用地图 API,调用计算器,调用代码解释器。模型当调度员,别当计算器。
真正的系统不是单模型。摄像头、麦克风、屏幕、数据库、外部工具,都是它的感官和手脚。多模态只是其中一个环节。把它当万能大脑,容易失望。把它当会看会听的接口层,反而能做出靠谱东西。
时间线:从“看图说话”到“边看边做”
早些年,图像描述任务就是给图配一句话。后来有了视觉问答,问它图里有没有伞。再往后,对比学习把图文对齐推了一大步。CLIP 这类思路让模型学会判断哪段文字和哪张图更配。然后,大语言模型接上视觉编码器,开始能聊图、读表、解题。
现在往前看,多模态正在往智能体走。它看屏幕,点按钮,填表单,甚至操作软件。听起来很酷。可每个动作都伴随风险。点错按钮、读错数字、把隐私截图传出去,都不是小事。所以落地会分层。低风险场景先来,比如整理相册、给视频自动打章节、把截图里的文字提取出来。高风险场景会慢很多。

如果它真的走进日常,先改变什么?
相册搜索会变得很自然。你输入“去年在海边吃冰淇淋那张”,它可能真找出来。无障碍领域也值得期待。视障用户拍一下周围,模型描述路况、读标签、认面孔。教育里,孩子指着一道几何题,模型边看边引导。工业质检里,摄像头加模型找瑕疵。这些方向都不新鲜,但多模态让交互门槛降了。
不过,隐私问题绕不开。摄像头一直开着,谁在听?谁在存?本地推理能缓解,但能力会打折。云端能力强,可数据要上传。还有版权。模型学过的图、视频、声音,怎么算?这些问题没有简单答案。技术跑得快,规则追得喘。
能耗也是。多模态推理比纯文本贵。视频更是电老虎。如果每次问答都调用大模型,成本会劝退很多产品。于是量化、蒸馏、缓存、路由,全上。用户只关心快不快、准不准。工程师在背后和延迟、内存、功耗打架。
别急着骂“人工智障”
下次它答错时,先看看图是不是太糊,光是不是太暗,问题是不是太绕。它只是在用它的方式拼凑世界。拼得好的时候,像魔术。拼得差的时候,像喝多了。
多模态大模型不是突然有了感官。它是把不同模态的信号,硬拉到同一个空间里做概率游戏。知道它怎么猜,比争论它懂不懂,更有用。毕竟,工具好不好用,取决于我们会不会用,也取决于我们知不知道它的边界在哪。
作者|科技
排版|科技
审核|小北