上周我把我妈发的扇子舞视频转给我闺蜜,过了三天我打开常用的短视频平台,首页直接堆了八个带绸子的舞蹈教程,甚至连我之前根本没点过的中老年穿搭链接都冒出来了。我盯着屏幕愣了半分钟——我根本没搜过跳舞啊。
你以为的”懂你”,其实是它在数你按了几次暂停
很多人第一反应是”平台偷听我说话”。真不是。
它根本不需要听你的语音。你刷视频的时候,看到扇子舞的片段,停了0.8秒才划走,你给我妈发消息的时候输入过”扇子”两个字,你上次在闺蜜的朋友圈给她发的舞蹈练习照点了个赞——这些碎得不能再碎的信号,全是它用来判断”你可能对这类内容感兴趣”的依据。
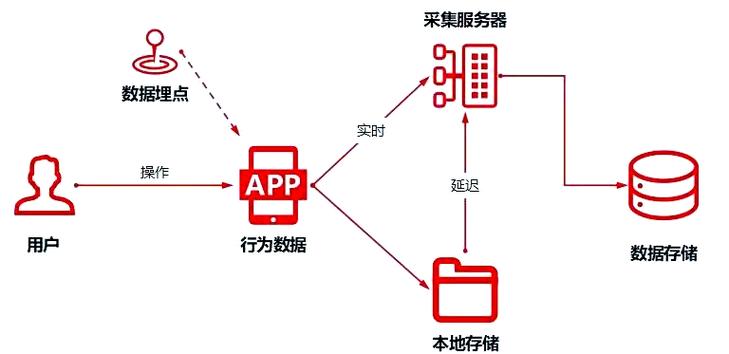
它不会像人一样坐下来想”哦,这个人是不是帮她妈看舞蹈视频呢”,它甚至根本不知道”舞蹈”是什么东西。它只是在算,把这些行为信号凑在一起,给你推什么内容,能让你多在这个APP里待30秒、1分钟、5分钟。
别神化它,它连”对错”是什么都不知道
我之前上学的时候,总觉得机器学习是那种科幻片里会自己思考的超级电脑。真接触了才发现,它最开始的状态,比刚学会认东西的三岁小孩还笨。
就拿最基础的认猫任务来说,你得给它喂几万张标好注的图:这张是猫,这张不是猫。最开始它会把带尖耳朵的兔子当猫,会把掉在沙发上的橘猫毛团当猫,会把穿毛绒猫耳外套的女生当猫。你得一次次给它纠正,标出来”这不对”,它就一点点调整自己的判断规则——直到它能准确把你家蜷在键盘上踩屏幕的真猫,和戴假猫耳的网红博主分开。
真的。
我第一次在实验室看这个训练过程的时候,鸡皮疙瘩都起来了。原来它根本不知道”猫”的定义是什么,只是在算两个图像的像素特征重合度有多高而已。

你平时用输入法打”我今天”,它跳出来”要加班”,不是它未卜先知知道你老板今天要临时开例会。是之前几千万个输入过同样三个字的用户,后面接的最多的内容就是”要加班”,它只是顺着这个概率,把最可能出现的词放在最前面而已。上次我打”我今天要去”,它直接给我跳出”医院”,给我整得半天没反应过来——我上周明明只是去商圈吃了顿重庆火锅啊喂。
那些没人愿意说的笨功夫,才是它真正的内核
很多人觉得机器学习厉害,是因为算法写得牛。错了。
我之前帮实验室的朋友标过三天自动驾驶的训练数据,标到最后我看见路边的行人,都忍不住在心里数他的身高占了画面的多少像素。你要让模型能认出路上的行人、红绿灯、路边的垃圾桶,就得把几十万张街景照片里的这些东西,一个个用框标出来,哪些是行人,哪些是骑电动车的人,哪些是被树挡了一半的红绿灯——这些枯燥到让人眼睛发花的工作,占了整个项目工作量的七成以上。
枯燥。
所有机器学习展现出来的”聪明”,背后都藏着无数人蹲在屏幕前给数据擦屁股的笨功夫。那些能写长文、能画插画的大模型也一样,你以为它能写出逻辑通顺的文章,其实它是把网上所有能爬取到的公开文字,拆成最小的语义碎块,算出来哪个词接在哪个词后面最顺而已。它根本不知道自己写的内容有没有道理,就像鹦鹉学舌,只是学的样本多了,听起来像那么回事。
有人说机器学习是没有偏见的,比人靠谱。拉倒吧。它的偏见全是我们喂给它的。比如你给它的历史招聘数据里,拿到offer的求职者大部分是男性,它就会自动觉得这类岗位更适合招男性——根本不需要给它写任何关于性别的规则,只要数据里藏着的倾向足够明显,它就能精准把那部分倾向挖出来,放大给你看。我之前朋友做的简历打分模型,跑出来的结果清一色偏向名校毕业生,翻了半天才发现,之前喂进去的历史录用数据里,名校出身的人占了绝大多数。不是模型偏心,是我们之前的流程本身就偏心。
前几天我家猫踩在我键盘上,把我写了一半的文档删了一半,我气的拍了个它一脸无辜的视频发朋友圈,过了十分钟打开购物软件,首页给我推了防猫抓键盘膜。
我没生气。
我甚至有点好奇——下次我要是故意在键盘上敲点乱七八糟的字,它会给我算出个什么花来。
作者|科技
排版|科技
审核|阿辰