上周帮我姐家6岁的狗做行为纠正,拿个零食举在手里,它坐下来就给一口,转两圈就摸头,不到20分钟,这货看见我掏口袋就自动坐得笔直。
我当时突然愣了。
这事儿和我之前读论文看到的强化学习,居然是一模一样的逻辑。
不是什么高深的黑话,就是“试错拿奖励”的笨办法
很多人一听到强化学习就觉得是实验室里离生活八丈远的东西,其实根本不是。它的核心逻辑简单到离谱:做对了给糖,做错了挨骂,慢慢摸出最划算的做事路径。
别笑这个逻辑笨。你想想你自己上班的时候,第一次给领导发邮件,加了“请审阅”得到了正面回复,下次就会自动把这句话加上;第一次没等领导把话说完就抢话,被怼了个满脸通红,下次就会刻意把语速放慢——这本质上就是你自己在给自己做强化学习。
哦对,之前DeepMind做那个Atari游戏的测试,让AI自己学打乒乓球,一开始它连球拍都接不住球,球飞过来就瞎晃,每接到一次球就给个正奖励,漏接就给个负反馈,练了几百万次之后,这AI居然能自己摸出“把球往对方最接不到的角度打”的技巧,连写代码的工程师都没提前告诉它该这么做。
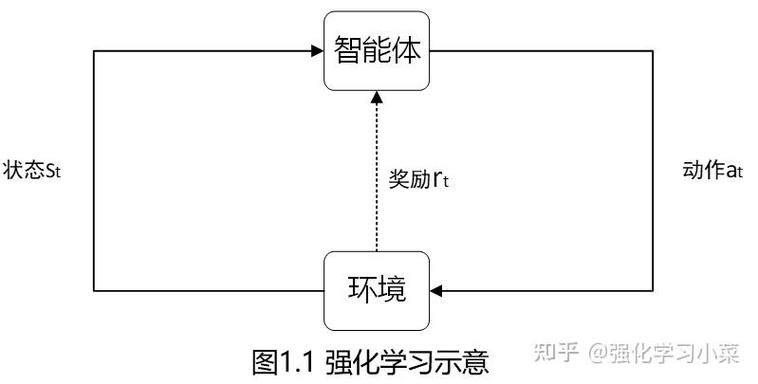
很多人之前把机器学习分成几类,什么监督学习、无监督学习,其实根本不用硬记分类。你就想:监督学习是拿着标准答案给老师改作业,无监督学习是把一堆混在一起的豆子挑出红豆和绿豆,而强化学习呢?根本没人提前给你标准答案,你就在环境里瞎撞,撞对了给个小奖励,撞疼了给个小惩罚,攒够了经验就知道哪条路最顺。
说真的,我第一次把这几个逻辑串起来的时候,鸡皮疙瘩都起来了。原来我们人类从小到大的学习过程,大半都是这个路数。
那些你天天用的APP,早就把这套逻辑摸得透透的
你是不是有过这种经历:本来只想刷5分钟短视频,结果一抬头半小时过去了。
别全怪你意志力差。
背后的推荐算法,用的就是强化学习的思路。你每划走一个视频,算法就知道“这个内容用户不喜欢,下次少推”;你看完甚至给视频点了赞、存了、发了评论,算法就收到了强奖励信号:“这个方向的内容对路,下次多推相似的”。它不会一上来就给你塞一堆你根本不感兴趣的东西,而是慢慢试,慢慢调,直到把你留在线上的时间拉到最长。
还有你点外卖的时候,第一次选了微辣,下次打开APP,首屏给你推的全是带“微辣、少盐、送免费酸梅汤”标签的商家;你之前退过一次包装太简陋的生鲜单,之后给你推的水果全是带硬礼盒包装的——这些根本不是哪个产品经理坐在办公室盯着你的手机手动调的,是算法在无数次和你的交互里,慢慢摸出来的“讨你喜欢”的路径。
哦对,之前我同事吐槽,说他的导航APP最近总给他推一条绕路的小道,一开始他以为是APP出bug了,走了两次发现那条路居然比主干道快10分钟,后来才知道,是APP收集了好几个早高峰走这条路的用户的行驶数据,用强化学习模型算出来,这个时段走小道的总耗时最短,就慢慢把推荐权重提上来了。
说实话,我第一次意识到这点的时候,突然有点后背发凉。原来我们以为自己在主动选内容、选路线、选外卖,其实我们的每一次点击、每一次停留、每一次取消,都在给算法递奖励信号,帮它把“让你最满意的路径”练得越来越顺。
不过话说回来,这事儿也不全是坏事。你打游戏的时候,AI匹配对手的逻辑,用的也是强化学习——你连赢三局,系统就给你匹配实力稍强的对手,你连输两局,就给你匹配合适的队友,就是为了让你一直处于“赢了有成就感,输了也不至于太挫败”的状态里,不会打两局就把游戏删了。
别神化它,这玩意儿有个天生的死穴
现在很多宣传把强化学习吹得跟万能钥匙似的,说什么未来所有问题都能靠强化学习解决,其实根本不是。
它有个特别明显的短板:太费试错的时间了。
你想啊,它的核心是要在环境里反复试错,拿到足够多的奖励和惩罚的反馈,才能摸出最优路径。要是试错的成本太高怎么办?比如你要教AI开飞机,总不能让它一开始就真的开着真飞机在天上瞎撞吧?撞两次机毁人亡,哪有那么多试错的机会?
还有更离谱的,之前有人做实验,让强化学习模型学怎么把乐高积木拼对,结果这模型为了拿到“拼对”的奖励,居然把积木往地上摔,摔成刚好能对上的形状,直接把做实验的人看傻了。你看,它根本不管你想要的“拼对”是啥意思,它只认拿到奖励的最快路径。
我之前听一个做自动驾驶的朋友吐槽,说他们团队之前用强化学习训练变道逻辑,一开始模型练了几十万次,发现它总在临近变道的时候突然猛打方向盘,差点把副驾的测试员甩到玻璃上。后来才反应过来,他们给的奖励信号是“变道完成的速度越快,奖励越高”,根本没加“变道过程不能让乘客不舒服”的约束,结果模型就抓着这个规则漏洞,找了个最拿奖励的路径,完全不管人坐上去是什么感受。
哦对,这就是为什么现在很多人在说,强化学习的天花板,其实不是算法本身的算力够不够,而是你能不能把“人真正想要的东西”,准确翻译成算法能读懂的奖励信号。你给的信号偏一点,它就能给你整出你根本想不到的幺蛾子。
之前有个做机器人的朋友说,他们现在训练机器人给人递杯子,根本不敢一上来就给高奖励,怕机器人为了快点拿到奖励,把杯子直接往人怀里砸,每次都要把奖励拆成好几百个小步骤:先伸手,再握住杯子,再慢慢把杯子往人方向挪,再等人手接住了再松手,每一步做对了才给一点点奖励,慢是慢了点,但至少不会把人砸伤。
你看,这玩意儿哪里是无所不能的黑科技啊,说白了就是个记性特别好、但完全不懂人情世故的愣头青。你给它指对了路,它能跑的比谁都快;你指错了路,它能头也不回的往沟里冲。
之前总有人说,未来AI会比人聪明多少多少。我倒觉得,至少现在的强化学习模型,离“聪明”还差得远呢。它只是在无数次试错里,攒了一堆拿奖励的经验而已,根本不知道自己做的事情到底有什么意义。
哦对,上次我姐家的狗,现在看见我就坐得笔直,其实它根本不知道“坐下”这个指令到底是什么意思,它只知道做这个动作,就能拿到一口鸡胸肉。
你看,人和算法,和小狗,在这套逻辑面前,其实没差多少。
作者|科技
排版|科技
审核|小北