2026-10-21 17:22:59
作者:
科技
上周六陪我妈逛超市,她站在冷柜前纠结买哪种酸奶,我掏出手机搜了下“低蔗糖 益生菌 适合老年人肠胃的酸奶”,刚按完搜索,首页弹出来的不是满屏广告,是我们家上个月在社区团购里买过的那款无糖希腊酸奶的补货链接,连带推了同品牌的低钠奶酪碎。
我妈当时就愣了,说这手机是不是长眼睛了。
哪是长眼睛。
是有人在你看不见的地方,把你所有碎得像渣的行为、偏好、甚至你自己都没意识到的习惯,全串成了一张摸得着的网。
别被百科里的定义骗了,知识图谱根本不是什么高科技新玩具
很多人刷到“知识图谱”这四个字,第一反应是这是大模型火了之后才冒出来的新东西,是科技公司搞出来割韭菜的概念。
真不是。
最早相关的语义网络构想,上世纪90年代末就有学者在论文里提过。2012年谷歌第一次把这个概念放到公开的搜索产品里,当时的目标朴素得很:之前你搜“苹果”,搜索引擎给你堆几十页卖水果的链接,根本分不清你是想找吃的,还是想找那个做手机的牌子。他们当时做的事,就是把“苹果”这个词背后所有关联的实体拆出来——水果的品种、产地、营养成分,科技公司的产品线、创始人、发布会时间——给每个实体贴好明确的标签,再把实体之间的关联关系用线连起来。
 谷歌早期知识图谱搜索结果关联实体示意图
你以为这玩意离普通人远?
远个屁。
你现在导航搜“附近的宠物医院”,APP不会给你推已经倒闭三年的店,甚至会标出来哪家可以带猫进去、哪家需要提前预约、哪家对异宠开放。这些信息不是爬虫从各个网页上扒下来堆在一起的,是背后的知识图谱把“宠物医院”这个节点,和“营业状态”“服务宠物品类”“预约规则”这些关联节点全串成了连通的网,你找A的时候,顺着网线就能摸到和A相关的所有信息,不用自己在几十页搜索结果里瞎翻。
之前我碰到过一个做知识图谱的创业公司,跟客户吹说他们的图谱覆盖了全网99%的实体,结果我问他们“小区楼下卖手抓饼的张阿姨”算不算实体,对方半天接不上话。
其实哪有那么玄乎。你高中上地理课,在笔记本上把“长江”“流经省份”“沿岸城市”“特产”这些内容用彩笔连成的网,本质上就是最原始的知识图谱。
大模型火了之后,大家对知识图谱的误会,真的快把我气笑了
前两个月参加一个行业小沙龙,有个做ToB销售的哥们拍着胸脯说,他们给客户做的大模型项目,加了知识图谱就绝对不会胡说八道,客户问什么都能答得准。
我当时差点把手里的冰美式喷出来。
哪有那么神。
知识图谱不是给大模型“擦屁股”的万能补丁。很多人觉得大模型胡言乱语是因为记不住事实,只要把所有事实都塞进知识图谱,大模型就不会瞎编了。错。你想想,你把一整本《红楼梦》里所有人物关系、事件时间线、诗词出处全做成严谨到挑不出错的知识图谱,大模型该瞎编还是能瞎编——它根本不会老老实实去读图谱里的节点,很多时候它只是顺着自己训练时养成的语言惯性,把看起来通顺的句子拼出来而已。
那它到底有什么用?
说白了,是给容易走歪路的大模型搭个扶手。比如你问大模型“我家猫上周做了绝育,今天能不能喂它吃之前囤的三文鱼冻干”,如果没有知识图谱,它可能顺着之前的语料,给你扯一堆三文鱼的营养成分,说的全是正确的废话。但如果有图谱,它会先定位“绝育术后猫”这个节点,关联上“饮食禁忌”“术后恢复期时长”“常见并发症风险”,再顺着关系链找到对应的饮食建议——不是让它突然变聪明,是让它别在你需要靠谱答案的时候,扯些不着边际的闲篇。
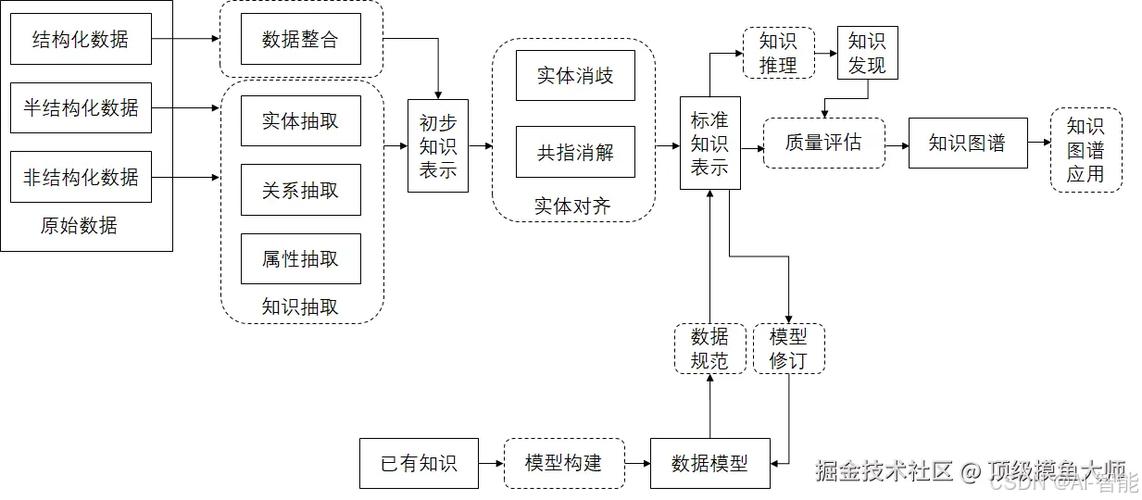 大模型对接知识图谱的节点关联流程图
去年我帮一个做古籍整理的朋友对接项目,他们之前用大模型给清代地方志做标点,经常把人名、地名标错,比如把“陶渊明”拆成“陶”“渊明”两个无关的词,读起来特别别扭。后来他们花了三个月,把整理过的史料里的所有人物、地名、官职名做成了小型知识图谱,再给大模型设了简单的规则:只要碰到图谱里有的实体,就直接调用对应的标注,不许自己瞎拆。
调整完之后,标注的准确率一下提了快40%,之前经常出现的把官职名当成地名的低级错误,基本没了。
不是大模型变聪明了。是它每次要走歪路的时候,图谱给它指了个正确的方向。
别把知识图谱吹成下一代互联网的终局,它其实是个笨功夫
 别把知识图谱吹成下一代互联网的终局,它其实是个笨功夫
这两年总能听到有人吹,说知识图谱是未来的核心技术,是下一代互联网的底座。
听着就虚。
它最熬人的地方,从来不是算法有多牛,是你得一个节点一个节点地抠,一条关系一条关系地核对。
之前和一个做儿童常见病医疗知识图谱的团队聊天,他们做的图谱面向普通家长,就是为了让大家查护理常识的时候,别被网上的谣言骗了。光“儿童发烧”这个节点,他们就拆了快两百个关联分支:不同年龄段的正常体温阈值、不同退烧药的适用年龄、过敏史的关联影响、物理降温的正确操作边界……这所有的内容,不是爬几篇网页就能凑出来的,得找临床医生一条一条核对,哪个是有循证医学依据的,哪个是网上传的谣言,哪个是早就过时的旧指南。
这活一点都不酷。没有炫酷的算法demo,没有发布会上能讲的性感故事,甚至你花了半年做出来的图谱,普通用户根本看不见——他们只会觉得,这个APP查发烧注意事项的时候,怎么比别的靠谱点。
很多人觉得知识图谱是个可以一次性做完的项目,其实根本不是。就像你家的书架,你今天添了本新书,明天把之前乱放的书归到对应的类目里,后天发现之前把两本讲同一个主题的书放错了层——这是个永远在更新的活,没有做完的那天。
说真的,我自己去年给我的笔记软件做了个迷你的个人知识图谱,就是把这几年写的文章、看过的书、存的电影片段、甚至我自己记的那些碎碎念,全打上标签串起来。之前我找东西,得翻半天文件夹,现在只要点一下“《银翼杀手》”这个节点,就能顺带着看到我之前写的关于赛博朋克的随笔、我存的那段雨夜街头的镜头、我当时引用的本雅明的《机械复制时代的艺术作品》的段落。
这东西根本没有什么高深的技术,就是把你脑子里本来就存在的关联,用看得见的方式摆出来而已。
前几天刷到我妈发的朋友圈,是她买的那款酸奶的照片,配文说“现在手机真懂我”。
我看着屏幕笑了半天。
她不知道的是,她每次在超市冷柜前停的3秒犹豫,她上次跟邻居吐槽之前买的酸奶太甜的聊天记录,她在社区团购里勾选的“低蔗糖”选项,早就被串成了一张小小的、属于她的节点。
哪是手机懂她。
是那些看不见的节点,把她所有没说出口的偏好,全接住了。
免责声明:市场有风险,选择需谨慎!此文仅供参考,不作买卖依据。如有侵权请联系删除。
文章名称:你刷到的“猜你喜欢”,根本不是算法玄学,是张织了20年的知识图谱
文章链接:https://www.lfdjt.com/p/keji/a/12234.html