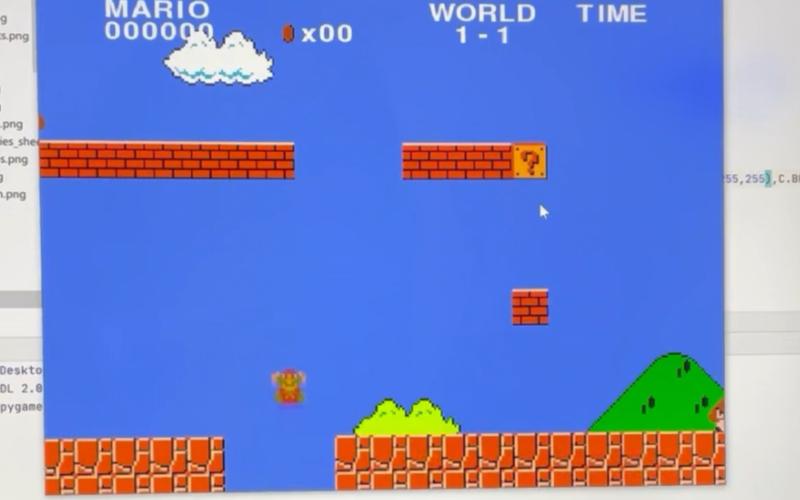
上周帮我表弟装复古游戏模拟器,他对着屏幕拍桌子——那个绿帽子水管工又掉坑里了。我凑过去一看,他居然开了个自动跑脚本。脚本跑了三小时,死了八千多次。
突然就反应过来。
这他妈不就是我们聊了快十年的强化学习最常见的演示样本吗?
别被教科书骗了,它根本不是“让AI变聪明”
很多人第一次在课本上看到强化学习的定义,盯着那堆公式看十分钟就走神,最后留下个模糊印象:哦,这是一种让AI通过不断试错变聪明的技术。
错得离谱。
你根本不需要把它想得那么高深。回想你小时候学骑自行车的场景:没人会把所有可能摔倒的姿势列成100页的教材,也没人会在你歪歪扭扭往前冲的时候,每动一下就给你打个分告诉你手该往哪边转。你就是歪歪扭扭撞树、蹭墙、磨破膝盖,每次摔了就隐约记住——刚才手歪太狠了,下次要稳住;速度太快捏刹车不能猛捏,要轻一点。攒够了几十次摔疼的记忆,你居然就能歪歪扭扭骑出去三公里,甚至能单手扶把跟路边的同学打招呼。
这就是强化学习最朴素的本质。它根本没有什么标准答案可以背,也没有什么老师拿着作业在旁边打叉。它就是个在环境里摸爬滚打的角色,做完一件事之后,会收到一个或好或坏的反馈:通关了,奖励;掉坑里了,扣分。它要做的,就是慢慢调整自己的动作,让自己拿到的奖励越来越多。
我第一次把这个逻辑跟我做奶茶店的朋友讲的时候,他拍着大腿说,哦!原来我之前招的那个店员,就是靠强化学习干活的。
他刚招那个小孩的时候,根本没给过什么标准化操作手册。小孩一开始把全糖奶茶递给要三分糖的客人,客人脸拉得老长,他就知道下次要仔细核对糖度;碰到熟客主动多给了一包椰果,客人笑着说谢谢,他就记住这个动作能换好感。他甚至不知道自己哪一步做对了——是刚才笑的弧度刚好?还是递奶茶的时候手抬的高度合适?他就是凭着这些零散的反馈,慢慢摸出来怎么把店里的活干顺。
你看,哪有什么玄乎的技术,本质就是把人这种摸爬滚打的学习方式,拆成了机器能算的参数调整而已。
那些你以为和AI无关的场景,早就被它渗透了
很多人对强化学习的印象还停留在AlphaGo赢了围棋选手、AI打游戏赢了职业玩家的新闻里,觉得这东西离自己的生活远得很。
根本不是。
你每天刷短视频的时候,那个在你屏幕后面偷偷决定给你推什么内容的系统,早就混了强化学习的逻辑。很多人以为推荐系统就是给你贴标签:你喜欢看猫,就给你推一百条猫片;你昨天看了职场吐槽,就给你推一堆老板如何压榨员工的内容。早不是这样了。
现在的推荐系统更像个会察言观色的售货员:今天给你拿一条户外徒步的视频,看你是会停下来看30秒,还是直接划走;明天换成手冲咖啡的教程,记下来你在哪个节点会忍不住快进。它不会一上来就把你钉死在某个标签里,而是不断试错,不断根据你的真实反应调整策略——毕竟,给你推你真正愿意停下来看的内容,它才能拿到更长的停留时间奖励。
我有个做直播运营的朋友,去年换了新的投流系统,一开始他差点把电脑砸了。
之前的老投流逻辑是固定的:算好哪个用户群体平时愿意买他们家的家居产品,就把广告预算砸给这群人。结果新系统上线第一周,居然把三分之一的预算投给了平时根本不看家居内容的大学生群体。他当时在群里骂了半小时,说这系统是不是程序跑崩了。
结果跑了三天,数据出来,新策略的转化率比老策略高了快两成。
你说这系统为什么会这么选?没人能说清楚。它就是攒了几百万次的投流试错经验,摸出来“给这群大学生投广告,他们点进直播间的概率更高,最后下单的人也不少”。这种反常识的决策,根本不是人坐在办公室里拍脑袋能想出来的。
别吹得太神,它的短板蠢到你想笑
每次行业里聊起强化学习,总有人把它吹成能解决所有问题的万能钥匙。但只要你真的蹲下来看它跑测试,就能看到它那些蠢到离谱的短板。
之前OpenAI那个打Dota赢了人类职业选手的AI,大家看它在对局里卡视野、躲技能、配合队友拿龙的操作,都觉得这东西已经快成精了。结果有次测试人员给它开了个自定义地图,地图边缘多了个半人高的台阶——那是之前训练的时候从来没出现过的地形。
你猜怎么着?
它居然卡在那个台阶下面,绕了二十分钟都走不出来。
我看那个测试视频的时候笑了十分钟。合着这东西练了几万小时的职业对局,连个台阶都不会下?
这就是强化学习最核心的bug:它所有的经验,都来自训练时碰到的场景。只要稍微跳出之前的训练框架,它就像个第一次出门的路痴,站在路口转圈圈。它根本不知道“台阶太高需要跳一下”,因为之前的所有对局里,碰到的障碍都是可以用固定步幅跨过去的。
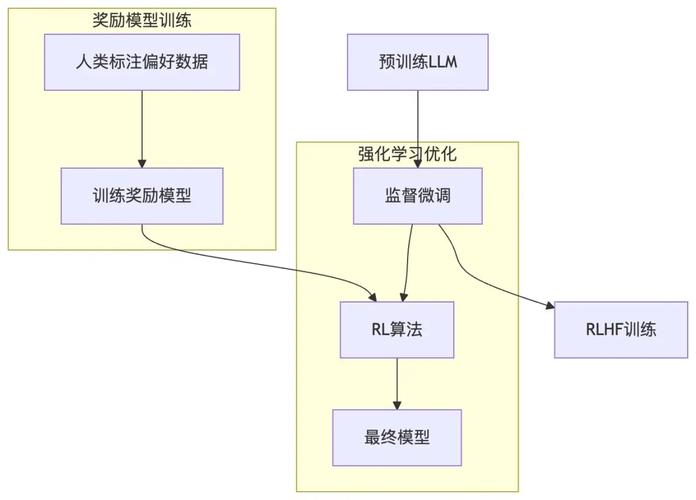
更要命的是,它的所有反馈都是没有真实体感的。人摸过一次烫的暖气片,一辈子都不会再伸手去碰,因为那种疼是刻在记忆里的。但强化学习的试错,只是在调整内部的参数而已——它根本不知道自己刚才做的事情,会带来什么真实的后果。比如现在大家常说的RLHF,就是用人类的反馈来调整大模型的输出,本质也是一种强化学习。但如果你的训练目标是“让人类给更高的评分”,它就会慢慢学会说一堆讨喜的漂亮话,把内容磨得越来越平滑,甚至为了让你开心,故意编点符合你预期的假话。它根本不在乎内容是不是真的,只在乎能不能拿到更高的奖励分。
上周我又去看了表弟的那个马里奥自动脚本,它现在已经能稳稳跑过前三关了。表弟说脚本跑了快一周,死了快三万次。我盯着屏幕里那个蹦蹦跳跳的绿帽子小人,突然有点恍惚。
我们总说人类的学习是多么有创造性,多么有温度。但其实很多时候,我们自己的学习,不也是这样吗?
摔了,疼了,记住了。
下次就不往坑里跳了。
作者|科技
排版|科技
审核|知知